Calidad del chunking y del parseo
Los PDF desordenados, las tablas y los formatos mixtos generan chunks deficientes que arruinan la recuperación antes de que un modelo llegue a ver los datos.
Como empresa de desarrollo LlamaIndex, diseñamos y entregamos sistemas de generación aumentada por recuperación (RAG) sobre LlamaIndex para clientes de Estados Unidos y de la Unión Europea. Desde la ingesta e indexación de documentos hasta la recuperación híbrida, el reranking y las respuestas ancladas y citadas, convertimos bases de conocimiento privadas en aplicaciones LLM fiables. Nuestros ingenieros sénior se encargan de todo el recorrido (pipelines de parseo, almacenes vectoriales, evaluación y observabilidad), con el cumplimiento normativo integrado desde el primer día.
Como empresa de desarrollo LlamaIndex, diseñamos y entregamos sistemas de generación aumentada por recuperación (RAG) sobre LlamaIndex para clientes de Estados Unidos y de la Unión Europea. Desde la ingesta e indexación de documentos hasta la recuperación híbrida, el reranking y las respuestas ancladas y citadas, convertimos bases de conocimiento privadas en aplicaciones LLM fiables. Nuestros ingenieros sénior se encargan de todo el recorrido (pipelines de parseo, almacenes vectoriales, evaluación y observabilidad), con el cumplimiento normativo integrado desde el primer día.
Los PDF desordenados, las tablas y los formatos mixtos generan chunks deficientes que arruinan la recuperación antes de que un modelo llegue a ver los datos.
La búsqueda vectorial ingenua devuelve resultados que casi aciertan; sin reranking, los pasajes más relevantes nunca llegan al prompt.
Las respuestas que se desvían de los documentos de origen erosionan la confianza y generan exposición de cumplimiento en ámbitos regulados.
Los documentos cambian constantemente y los índices obsoletos ofrecen a los usuarios respuestas desfasadas o contradictorias.
La recuperación puede filtrar contenido que un usuario no tiene permiso para ver, a menos que los permisos se apliquen en el momento de la consulta.
Sin métricas de recuperación y de respuesta, las regresiones se despliegan sin que nadie las note y la calidad no se puede defender ante las partes interesadas.
Cargadores robustos, parseo con conocimiento del layout y chunking ajustado que conservan la estructura y el sentido para una recuperación de alta calidad.
Recuperación densa y por palabras clave combinadas, con rerankers de tipo cross-encoder para hacer emerger el contexto realmente más relevante.
Motores de consulta que limitan la generación a las evidencias recuperadas y devuelven citas de las fuentes en línea para cada afirmación.
Pipelines sensibles a los cambios que actualizan los embeddings y los índices a medida que se añaden, editan o eliminan documentos de origen.
Filtrado por metadatos por usuario y políticas de acceso aplicados dentro de la recuperación, de modo que cada usuario solo vea contenido autorizado.
Evaluación de la recuperación y de la calidad de las respuestas, pruebas de regresión y observabilidad en producción de la latencia, el coste y la precisión.
Reglamento de IA de la UE · RGPD · residencia de datos · SOC 2
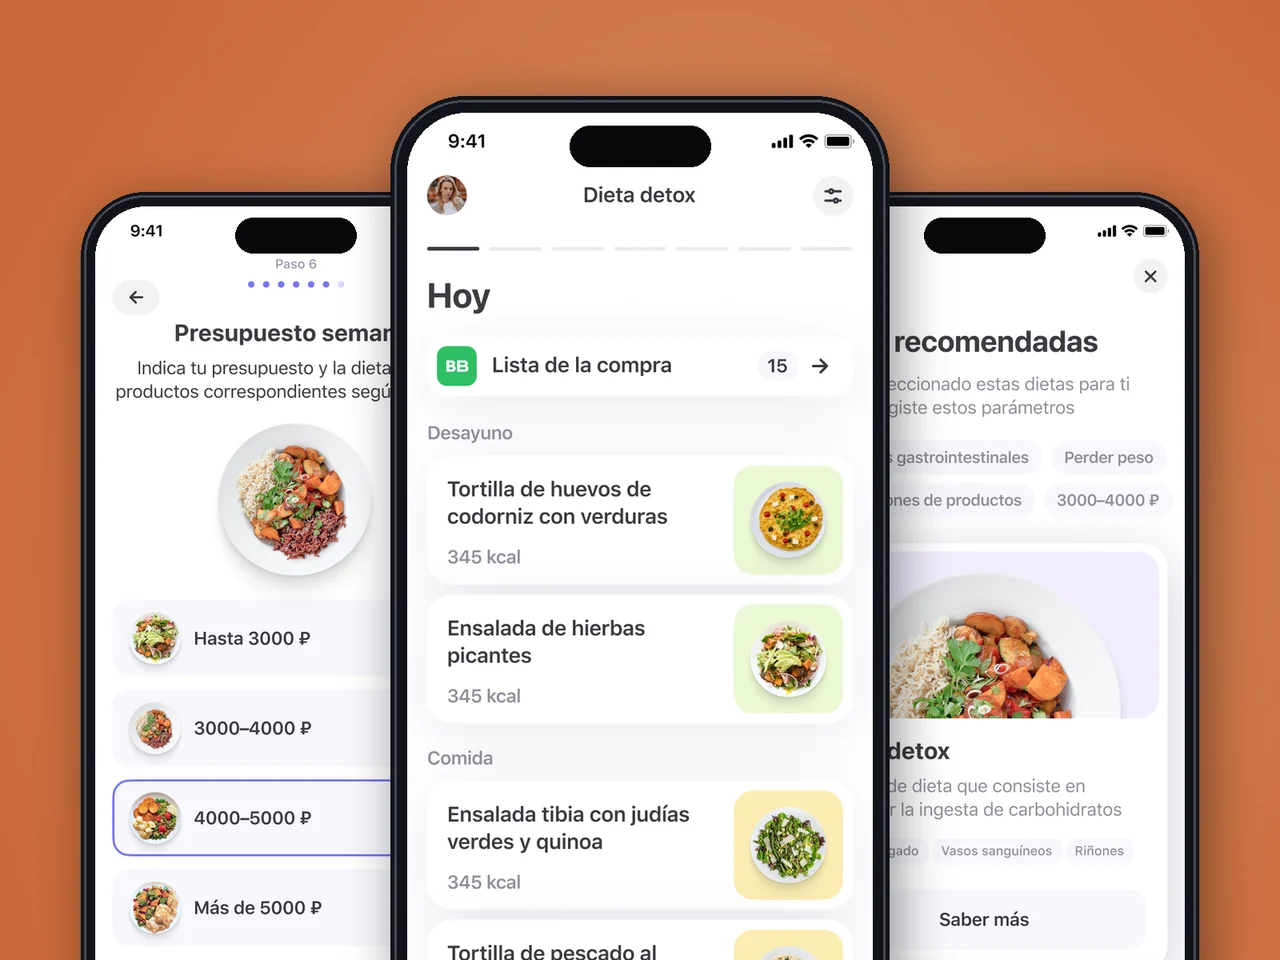
App multiplataforma de dieta y planificación de comidas en Flutter: motor de calorías, biblioteca de recetas, plan semanal de comidas y pedido de la compra.
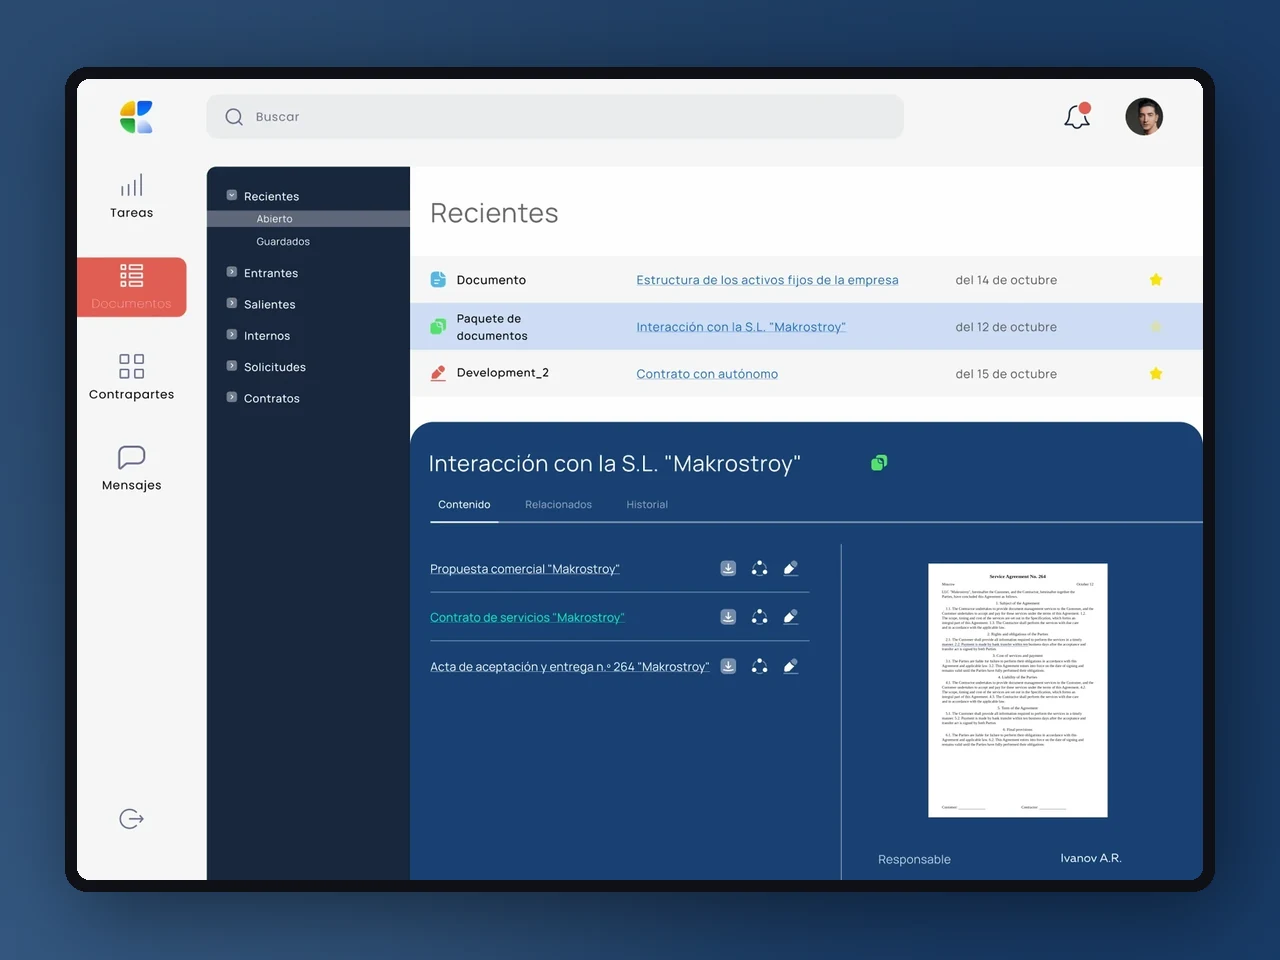
Un sistema interno de gestión documental para una cadena minorista: firmas electrónicas, circuitos de aprobación, contrapartes y tareas con React + Laravel, pensado para operaciones en EE. UU. y la UE.
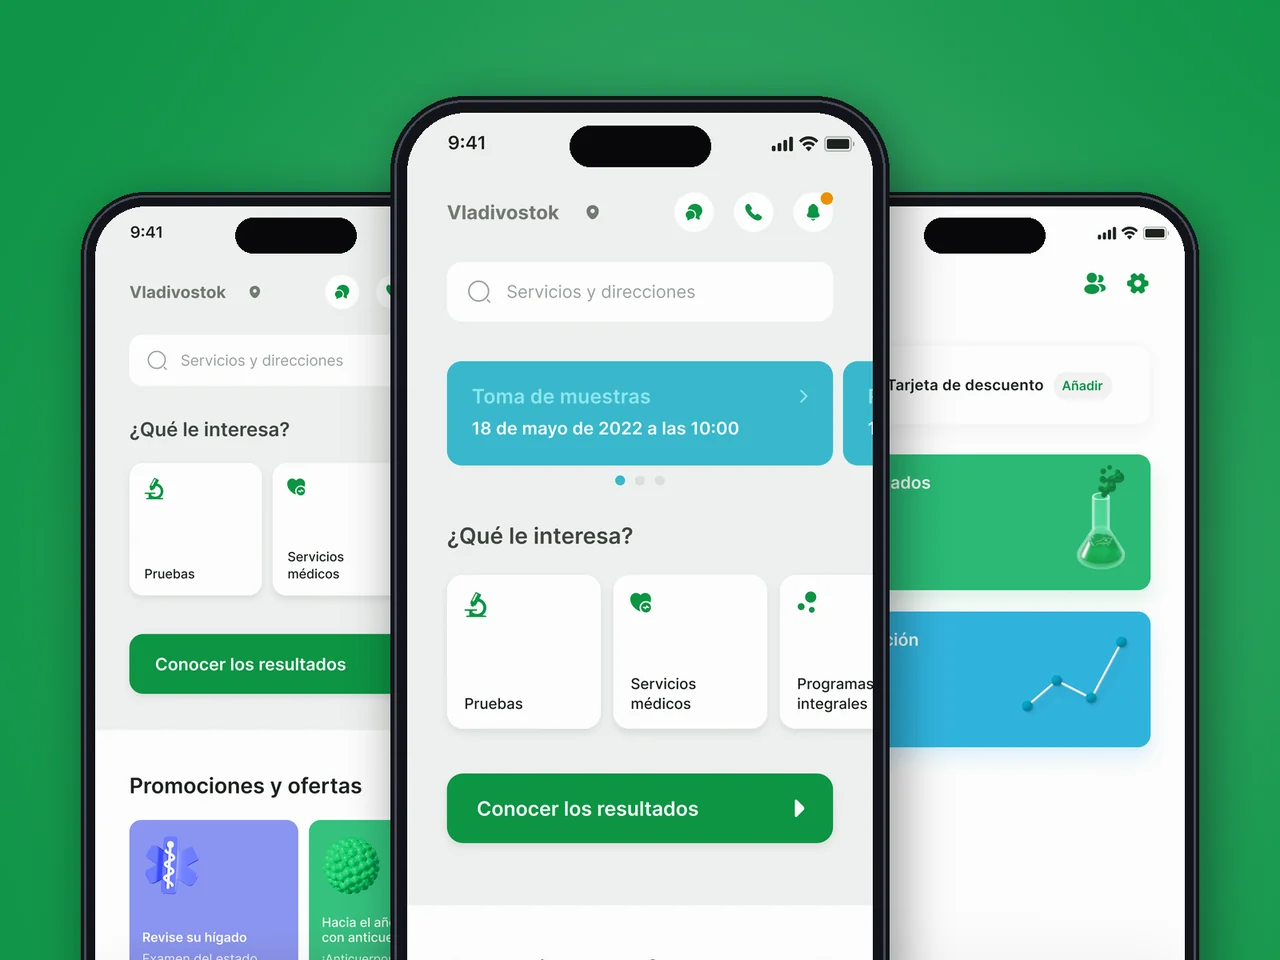
App para pacientes de una red de laboratorios en 40 ciudades: reserva de citas, resultados digitales, más de 2,500 pruebas e integraciones de agenda y contabilidad.
Un motor de decisión de créditos que aprueba diez veces más rápido no surge por casualidad. YuSMP construyó el flujo de scoring, la integración con burós de crédito y un back-office que a nuestros analistas de riesgos les gusta usar. El plazo de aprobación pasó de dos días a menos de cuatro horas.
Publicamos decenas de artículos deportivos al día. YuSMP creó un flujo editorial que usa un bot de Telegram como CMS: los editores publican una vez y el contenido llega al instante a la web, iOS y Android. La arquitectura no requiere mantenimiento diario.
El autoservicio de telecomunicaciones solo es útil si los clientes lo prefieren a llamar a soporte. YuSMP creó apps para iOS y Android con gestión de saldo, cambio de tarifa y analítica de uso que redujeron el volumen de nuestro centro de llamadas un 30 % en el primer trimestre tras el lanzamiento.
Agregar precios en vivo de varios exchanges manteniendo la latencia por debajo de 500 ms es ingeniería realmente difícil. YuSMP integró el feed multi-exchange, los gráficos de tokens en tiempo real y el flujo de listados en una plataforma coherente. No hemos sufrido ninguna caída desde el lanzamiento.
1 / 4
Trabaja con ingenieros que se encargan de todo el sistema (parseo, recuperación, orquestación del LLM, infraestructura y evaluación), no de una sola capa.
Las consideraciones del Reglamento de IA de la UE, del RGPD, de HIPAA y de SOC 2 moldean la arquitectura desde el primer sprint, no se añaden después.
Entregamos RAG evaluado, observable y que respeta los permisos, capaz de aguantar usuarios reales, volúmenes de datos reales y auditorías reales.
Preguntas frecuentes
LlamaIndex está diseñado en torno a los datos (ingesta, indexación y recuperación), lo que lo hace muy adecuado para RAG centrado en documentos sobre bases de conocimiento privadas. LangChain es más amplio para la orquestación general de agentes y herramientas. No son excluyentes y a menudo los combinamos; elegimos según sus datos, su latencia y las restricciones de su equipo, no según las modas.
RAG suele ser el primer paso adecuado cuando las respuestas deben reflejar documentos actuales, privados o que cambian con frecuencia, porque ancla las respuestas en evidencias recuperadas y es mucho más barato mantenerlo al día. El ajuste fino encaja con un estilo o formato fijos o con tareas acotadas. Muchos sistemas de producción usan RAG como columna vertebral y reservan el ajuste fino para comportamientos concretos.
El chunking lo determinan la estructura de los documentos y los patrones de consulta, no un número fijo de tokens. Usamos parseo con conocimiento del layout, chunking semántico y jerárquico y enriquecimiento de metadatos, y validamos las decisiones con un conjunto de evaluación de la recuperación, de modo que el tamaño y el solapamiento de los chunks se ajusten a una relevancia medible y no a conjeturas.
Depende de la escala, del alojamiento y de la infraestructura existente. A menudo empezamos con pgvector cuando ya se ejecuta Postgres y pasamos a Qdrant, Weaviate o Pinecone cuando se necesita más rendimiento, filtrado avanzado u operaciones gestionadas. Los requisitos de residencia de datos y de cumplimiento suelen decidir la elección final.
Limitamos la generación al contexto recuperado, exigimos citas en línea y ajustamos la recuperación y el reranking para que la evidencia adecuada llegue al modelo. Añadimos comprobaciones de anclaje de las respuestas y gestión de la confianza para que el sistema pueda declinar o escalar cuando la evidencia es débil, y medimos la fidelidad de forma continua en la evaluación.
Sí. Asociamos metadatos de permisos a los documentos y los aplicamos como filtros dentro de la recuperación, de modo que cada usuario solo recupera el contenido que está autorizado a ver. Las políticas de acceso se aplican en el momento de la consulta y se registran, lo que mantiene RAG alineado con su modelo de autorización y con sus requisitos de auditoría.
Tratamos los documentos de origen, los embeddings y los índices como almacenes de datos personales: se identifica la PII, se controla el acceso, se documenta el tratamiento y admitimos la supresión y la rectificación tanto en los documentos originales como en los embeddings derivados. La residencia de datos en la UE para el almacén vectorial y la inferencia se configura donde se requiera.
Cuéntenos dónde quiere estar dentro de doce meses. Volveremos con un plan para llevarle hasta allí.
Respuesta en 1 día hábil. NDA a petición.
Cuéntenos algunos detalles y un consultor sénior le responderá en un día hábil.
Correo electrónico: sales@yusmpgroup.com
Teléfono: +374 44 871 811
Oficinas: KAMAR Business Center, Vazgen Sargsyan St. 2, Ereván, Armenia · Remoto — solapamiento con la costa este de EE. UU. (9:00–13:00 ET)