Qualità del chunking e del parsing
PDF disordinati, tabelle e formati misti producono chunk di scarsa qualità che compromettono il recupero ancor prima che il modello veda i dati.
Progettiamo e realizziamo sistemi di retrieval-augmented generation su LlamaIndex per clienti negli Stati Uniti e nell'Unione Europea. Dall'ingestione e indicizzazione dei documenti al recupero ibrido, al reranking e alle risposte citate e ancorate alle fonti, trasformiamo le basi di conoscenza private in applicazioni LLM affidabili. I nostri ingegneri senior gestiscono l'intero percorso – pipeline di parsing, vector store, valutazione e osservabilità – con la conformità integrata fin dal primo giorno.
Progettiamo e realizziamo sistemi di retrieval-augmented generation su LlamaIndex per clienti negli Stati Uniti e nell'Unione Europea. Dall'ingestione e indicizzazione dei documenti al recupero ibrido, al reranking e alle risposte citate e ancorate alle fonti, trasformiamo le basi di conoscenza private in applicazioni LLM affidabili. I nostri ingegneri senior gestiscono l'intero percorso – pipeline di parsing, vector store, valutazione e osservabilità – con la conformità integrata fin dal primo giorno.
PDF disordinati, tabelle e formati misti producono chunk di scarsa qualità che compromettono il recupero ancor prima che il modello veda i dati.
La ricerca vettoriale naive restituisce risultati approssimativi; senza reranking i passaggi più rilevanti non raggiungono mai il prompt.
Risposte che si discostano dai documenti sorgente erodono la fiducia e creano esposizione alla conformità nei settori regolamentati.
I documenti cambiano continuamente e gli indici obsoleti forniscono risposte superate o contraddittorie agli utenti.
Il recupero può esporre contenuti che un determinato utente non è autorizzato a vedere, se le autorizzazioni non vengono applicate al momento della query.
Senza metriche di recupero e qualità delle risposte, le regressioni vengono rilasciate in silenzio e la qualità non può essere difesa di fronte agli stakeholder.
Loader robusti, parsing consapevole del layout e chunking ottimizzato che preservano struttura e significato per un recupero di alta qualità.
Recupero denso e per parole chiave combinato con reranker cross-encoder per far emergere il contesto genuinamente più rilevante.
Query engine che limitano la generazione alle evidenze recuperate e restituiscono citazioni della fonte inline per ogni affermazione.
Pipeline consapevoli delle modifiche che aggiornano embedding e indici man mano che i documenti sorgente vengono aggiunti, modificati o rimossi.
Filtri sui metadati per singolo utente e policy di accesso applicate all'interno del recupero, così che ogni utente veda solo i contenuti autorizzati.
Valutazione del recupero e della qualità delle risposte, test di regressione e osservabilità in produzione su latenza, costi e precisione.
EU AI Act · GDPR · residenza dei dati · SOC 2
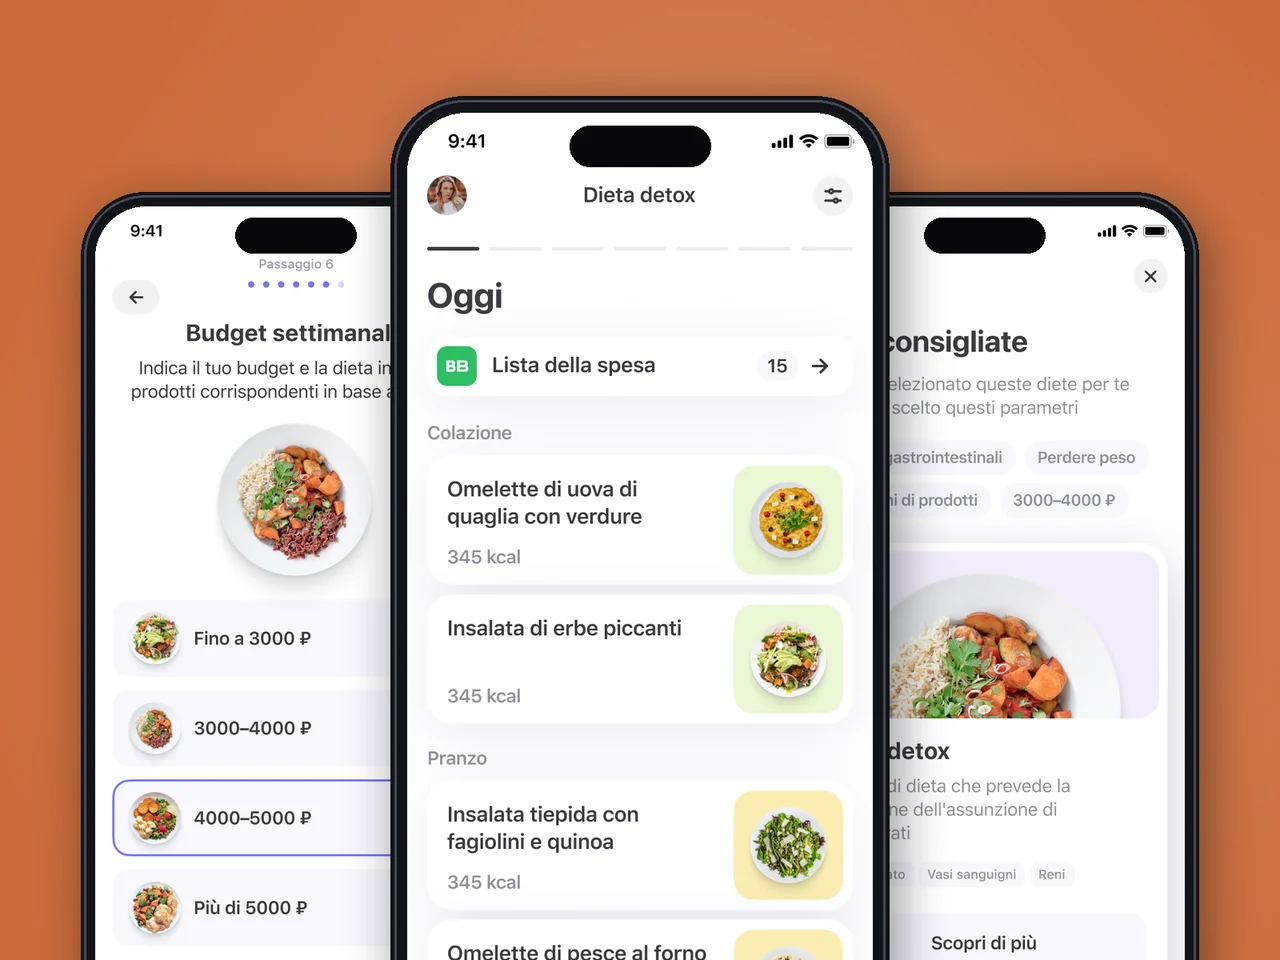
App multipiattaforma per dieta e pianificazione pasti su Flutter — motore calorico, libreria ricette, piano pasti settimanale, ordinazione della spesa.
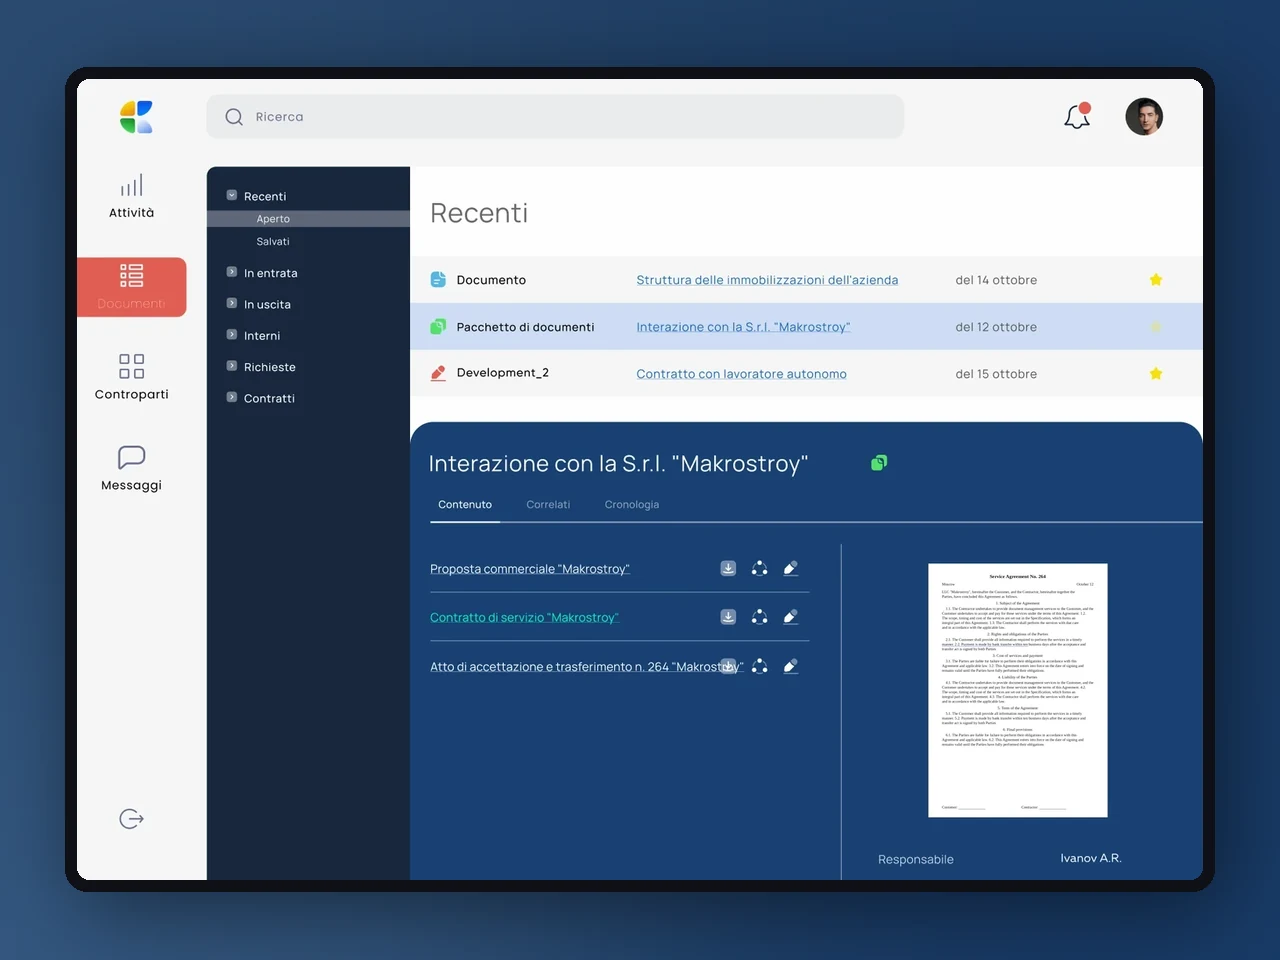
Un sistema EDM interno per una catena retail — firme elettroniche, routing delle approvazioni, controparti e attività su React + Laravel, sviluppato per operazioni USA ed UE.
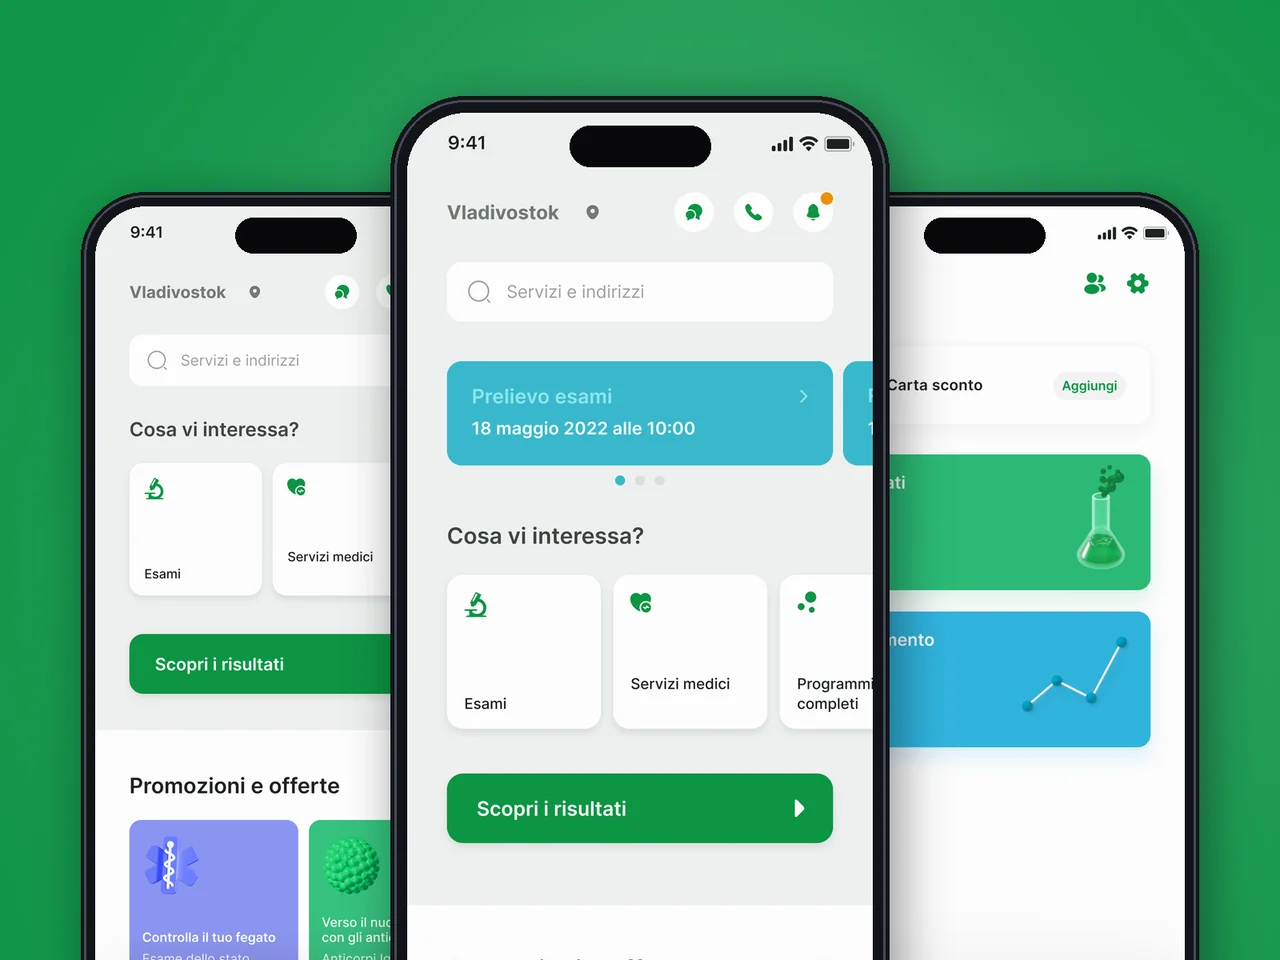
App per i pazienti di una rete di laboratori in 40 città — prenotazione appuntamenti, referti digitali, oltre 2.500 esami, integrazioni con scheduling e contabilità.
Una catena retail con decine di punti vendita ha bisogno di flussi di lavoro documentali che il personale non tecnico possa seguire senza formazione. YuSMP ha sviluppato un DMS interno con catene di approvazione, versioning e accesso basato sui ruoli che il nostro responsabile della compliance ha definito il sistema più ordinato che abbiamo mai distribuito.
Avevamo un'idea e tempistiche stringenti. YuSMP ha trasformato uno scheletro Flutter in un'app per la nutrizione pronta per la produzione con motore calorico, piani alimentari e abbonamenti App Store in quattro mesi. La retention a 90 giorni ha superato il nostro benchmark del 30%.
Gestire appuntamenti e referti in più città su tre piattaforme è genuinamente complesso. YuSMP ha risolto un problema di integrazione legacy che avevamo evitato per due anni e ha rilasciato un'esperienza paziente che i nostri punteggi NPS hanno immediatamente rispecchiato.
Un motore di decisione sui prestiti che impiega dieci volte meno tempo per approvare non avviene per caso. YuSMP ha costruito la pipeline di scoring, l’integrazione con i bureau del credito e un back-office che i nostri sottoscrittori apprezzano davvero. I tempi di approvazione sono passati da due giorni a meno di quattro ore.
1 / 4
Collaborerete con ingegneri che gestiscono l'intero sistema – parsing, recupero, orchestrazione LLM, infrastruttura e valutazione – non un singolo livello.
EU AI Act, GDPR, HIPAA e SOC 2 orientano l'architettura fin dal primo sprint, non come ripensamento.
Consegniamo RAG valutato, osservabile e con controllo degli accessi, che regge con utenti reali, volumi di dati reali e audit reali.
Domande frequenti
LlamaIndex è progettato attorno ai dati – ingestione, indicizzazione e recupero – ed è particolarmente adatto a sistemi RAG incentrati su documenti e basi di conoscenza private. LangChain è più ampio per orchestrazioni generali di agenti e strumenti. Le due soluzioni non si escludono a vicenda e spesso le combiniamo; la scelta dipende dai vostri dati, dalla latenza e dai vincoli del team, non dalle mode.
Il RAG è solitamente il primo passo corretto quando le risposte devono riflettere documenti attuali, privati o che cambiano frequentemente, perché ancora le risposte alle evidenze recuperate ed è molto meno costoso da aggiornare. Il fine-tuning si adatta a stile, formato o compiti ristretti e fissi. Molti sistemi in produzione usano il RAG come spina dorsale e riservano il fine-tuning a comportamenti specifici.
Il chunking è guidato dalla struttura del documento e dai pattern di interrogazione, non da un conteggio fisso di token. Utilizziamo il parsing consapevole del layout, il chunking semantico e gerarchico e l'arricchimento dei metadati; poi validiamo le scelte su un set di valutazione del recupero in modo che la dimensione e la sovrapposizione dei chunk siano calibrate su una rilevanza misurabile, non a intuito.
Dipende dalla scala, dall'hosting e dall'infrastruttura esistente. Partiamo spesso con pgvector quando già utilizzate Postgres, e passiamo a Qdrant, Weaviate o Pinecone quando necessitate di throughput elevato, filtri avanzati o operazioni gestite. I requisiti di residenza dei dati e di conformità decidono spesso la scelta finale.
Limitiamo la generazione al contesto recuperato, richiediamo citazioni inline e regoliamo il recupero e il reranking affinché le prove corrette raggiungano il modello. Aggiungiamo controlli di ancoraggio delle risposte e gestione della fiducia in modo che il sistema possa rifiutare o escalare quando le prove sono deboli, e misuriamo la fedeltà in modo continuo in fase di valutazione.
Sì. Associamo i metadati delle autorizzazioni ai documenti e li applichiamo come filtri all'interno del recupero, in modo che ogni utente recuperi solo i contenuti che è autorizzato a vedere. Le policy di accesso vengono applicate al momento della query e registrate, il che mantiene il RAG allineato al vostro modello di autorizzazione e ai requisiti di audit esistenti.
Trattiamo i documenti sorgente, gli embedding e gli indici come archivi di dati personali: i dati personali vengono identificati, gli accessi sono controllati, il trattamento è documentato e supportiamo la cancellazione e la rettifica sia dei documenti grezzi sia degli embedding derivati. La residenza dei dati UE per il vector store e l'inferenza viene configurata ove necessario.
Diteci dove volete essere tra dodici mesi. Vi risponderemo con un piano per arrivarci.
Risposta entro 1 giorno lavorativo. NDA su richiesta.
Condividete alcuni dettagli e un consulente senior risponderà entro un giorno lavorativo.
Email: sales@yusmpgroup.com
Telefono: +374 44 871 811
Uffici: KAMAR Business Center, Vazgen Sargsyan St. 2, Erevan, Armenia · Remoto — sovrapposizione con la costa est degli Stati Uniti (9:00–13:00 ET)