


PoC / pilot
da $2,900
4–6 settimane · un caso d'uso
Un proof of concept delimitato sui vostri dati reali: un caso d'uso, un prototipo end-to-end funzionante, un eval set e un go/no-go scritto con una proiezione dei costi.
Richiedi un preventivoYuSMP Group costruisce applicazioni GenAI di livello produttivo, sistemi RAG, AI agent e le pipeline di dati che li alimentano — come scaglioni snelli a scope fisso, non un ingaggio enterprise a sei cifre. Un PoC / pilot da $2,900 in 4–6 settimane, RAG sulla vostra knowledge base da $8,100, un AI agent autonomo da $10,400, un modello ML in produzione da $13,800. Oltre 80 senior engineer a Yerevan lavorano nella fascia oraria CET / costa est USA, con uno stack vendor-neutral sui modelli tra OpenAI, Anthropic e Bedrock. Scope fisso, prezzi all-in in USD, IP trasferita a voi dal primo giorno, allineato al GDPR e strutturato per la conformità EU AI Act fin dal primo giorno — non aggiunto in seguito.
Vendor-neutral · Conforme GDPR · ISO 27001 ready · SOC 2 Type II in corso · HIPAA-capable · EU AI Act & NIST AI RMF · giornata CET con sovrapposizione 9:00–13:00 ET
Forniamo uno scope integrato: applicazioni GenAI, retrieval-augmented generation, AI agent multi-step, machine learning classico, la data engineering che rende tutto ciò affidabile e il MLOps che ne garantisce il funzionamento. I nostri team rimangono vendor-neutral sui modelli — Anthropic, OpenAI, open-weight tramite Bedrock o self-hosted — e scelgono lo stack in base alla residenza dei dati, alla latenza e al budget. La governance è integrata: GDPR, controlli ISO 27001, SOC 2 Type II in corso, delivery HIPAA-capable e un passaggio di classificazione del rischio EU AI Act in ogni engagement. Vederlo in pratica nel nostro caso di studio ARIA.
Copilot, ricerca, sintesi e workflow documentali legati a KPI misurabili. Consegniamo funzionalità che spostano le metriche, non demo che si bloccano in fase pilota.
Recupero ibrido, reranking, valutazione e osservabilità. Ottimizziamo sui vostri dati, le vostre query e i vostri criteri di accettazione, non su benchmark fittizi.
Training riproducibile, model registry, shadow deploy e monitoraggio per drift e bias. Ogni modello ha un percorso chiaro dal notebook alla produzione.
Modern data stack su Snowflake, BigQuery o Databricks. ELT con dbt, contratti tra team e lineage di cui sia gli auditor che gli analisti possono fidarsi.
Classificazione del rischio, avvisi di trasparenza, documentazione tecnica e supervisione umana integrati nel prodotto ai sensi dell'EU AI Act e del NIST AI Risk Management Framework — non aggiunti prima di un audit. Consapevole delle leggi statali (Colorado AI Act 2026, NYC AEDT, norme CCPA ADM).
Golden dataset, regressioni automatizzate ed eval offline su ogni modifica ai prompt e ai modelli. La qualità è un numero, non una sensazione.
Vi serve un ingaggio mirato invece di un build end-to-end? Ogni capacità qui sotto è un servizio YuSMP dedicato, con il suo team senior, il suo playbook di delivery e la sua postura di conformità USA e UE.
Integrate la GenAI nel vostro prodotto esistente — copilot, sintesi e workflow di contenuti su uno stack vendor-neutral.
Retrieval ibrido, reranking e valutazione sulla vostra knowledge base, con osservabilità e guardrail.
Agent multi-step che compiono azioni tra i vostri tool, con human-in-the-loop sui percorsi ad alto rischio.
Pipeline di detection, classificazione e OCR per team industriali e di prodotto, addestrate e monitorate sui vostri dati.
Fine-tuning, eval e il MLOps per rilasciare e monitorare i modelli quando il solo RAG non raggiunge i vostri obiettivi di costo o latenza.
Classificazione del rischio, documentazione tecnica e design della supervisione umana perché la vostra AI arrivi audit-ready nell'UE.
Mappiamo i casi d'uso rispetto al valore di business, alla prontezza dei dati e alla doppia classificazione del rischio — classe di rischio EU AI Act più profilo NIST AI RMF Govern/Map/Measure/Manage — poi scegliamo i due o tre con il payoff più elevato.
Architettura di riferimento, harness di valutazione, pipeline di dati e confini human-in-the-loop vengono progettati prima che qualsiasi modello venga integrato nel prodotto.
Sprint di due settimane con eval offline, A/B test su utenti reali, controllo delle versioni di prompt e modelli e osservabilità su costi, latenza e qualità.
Dashboard su drift, bias e costi, rivalutazioni programmate e un backlog legato ai cambiamenti di modelli e normativi nell'UE (AI Act), negli USA (NIST AI RMF, leggi statali) e presso i principali provider.
Per proof of value AI delimitati, pilot RAG e build di piattaforme dati con criteri di accettazione precisi e una scadenza fissa.
Per prodotti AI in evoluzione in cui prompt, modelli e metriche cambiano ogni settimana. Team senior, demo settimanali, revisioni mensili della capacità.
Un team AI e data di lungo periodo integrato nella vostra organizzazione di prodotto, responsabile della qualità dei dati, del ciclo di vita dei modelli e della documentazione di conformità.
La maggior parte dei fornitori tiene il numero per una call commerciale. Ecco i nostri scaglioni snelli a scope fisso, così potete fare il budget prima della discovery. Tutto è all-in, denominato in USD, con IP trasferita a voi dal primo giorno, nessun ricarico di recruiting, nessun sovrapprezzo per i tool e nessuna commissione nascosta. Vedete il budget dettagliato prima che venga scritto qualsiasi codice e lo approvate. I costi cloud e GPU passano dai vostri account, così mantenete la leva sui costi.
PoC / pilot
da $2,900
4–6 settimane · un caso d'uso
Un proof of concept delimitato sui vostri dati reali: un caso d'uso, un prototipo end-to-end funzionante, un eval set e un go/no-go scritto con una proiezione dei costi.
Richiedi un preventivoRAG sulla vostra knowledge base
da $8,100
ancorato al vostro corpus
Retrieval-augmented generation sulla vostra knowledge base: ingestion e chunking, retrieval ibrido e reranking, un eval harness in CI, guardrail e osservabilità.
Richiedi un preventivoAI agent (autonomo)
da $10,400
multi-step, con uso di tool
Un agent multi-step che compie azioni tra i vostri tool, con human-in-the-loop sui percorsi ad alto rischio, eval deterministiche, filtri sull'output e un runbook di proprietà del vostro team.
Richiedi un preventivoModello ML in produzione
da $13,800
dal notebook al serving
Un modello ML su misura portato in produzione: pipeline di dati, training e ablation, MLOps con monitoraggio di drift e bias e un percorso documentato dal notebook al serving.
Richiedi un preventivoCosa sposta il numero: quanti casi d'uso rilasciate e quanto va in profondità ogni corpus RAG; la dimensione dell'eval set necessaria per fidarsi degli output; gli obiettivi di latenza (p95 sotto i 500 ms impone scelte di modello e infrastruttura); e lo scope di conformità — il GDPR è in scope per impostazione predefinita, ma flussi di dati HIPAA-capable, residenza solo UE o contratti provider zero-retention aggiungono lavoro di controllo. GPU, tooling di terze parti e spesa cloud passano dai vostri account. Tutto ciò che esce dallo scope firmato finisce su una roadmap con stime dimensionate invece di un'estensione silenziosa delle tempistiche. I prezzi sono indicativi e vengono fissati in una proposta scritta per il vostro scope specifico.
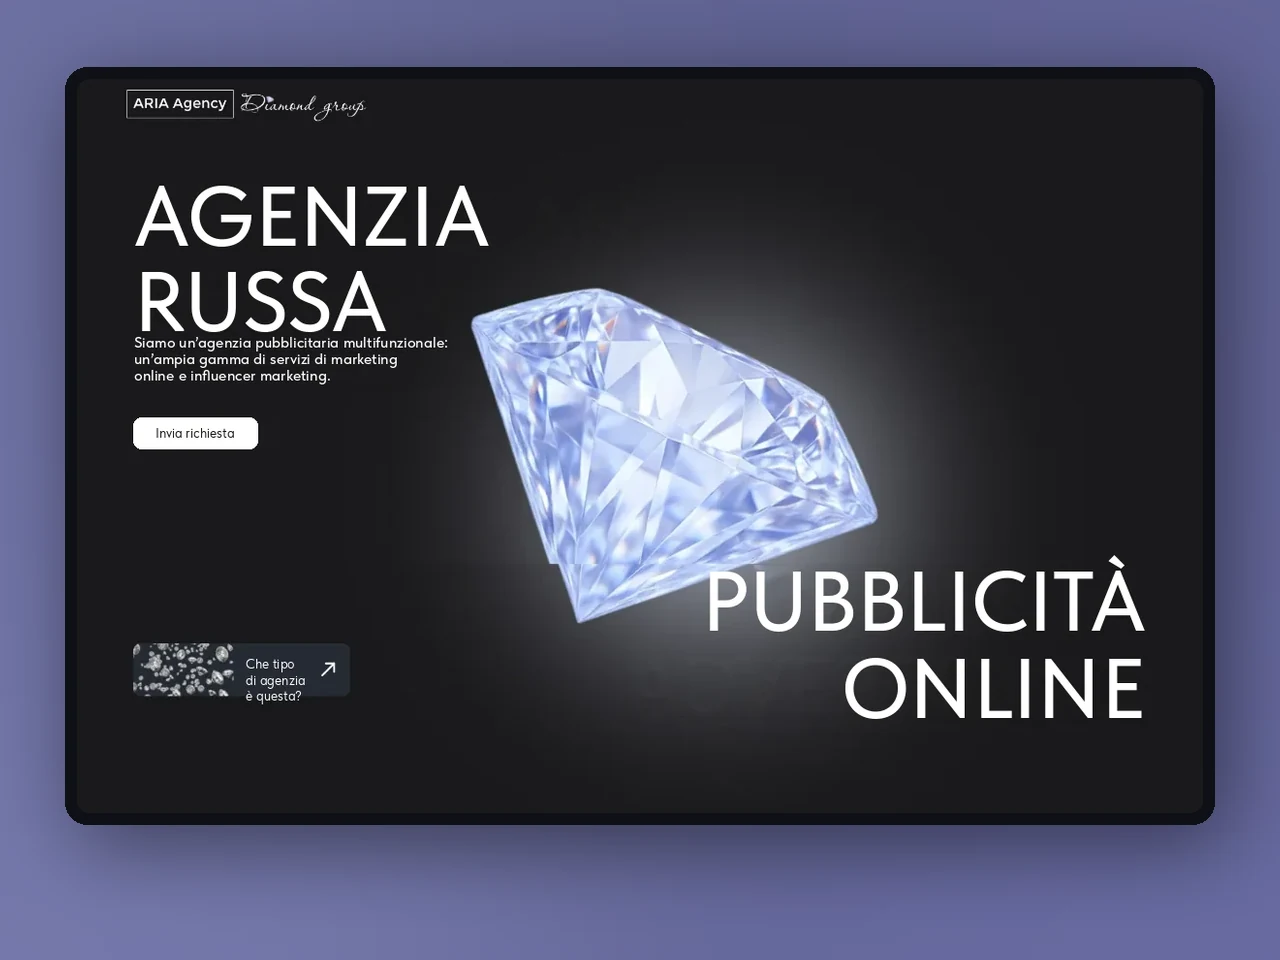
Landing page single-page su Tilda con acquisizione lead tramite bot Telegram per un'agenzia pubblicitaria — rilasciata in due settimane, pronta per USA e UE.
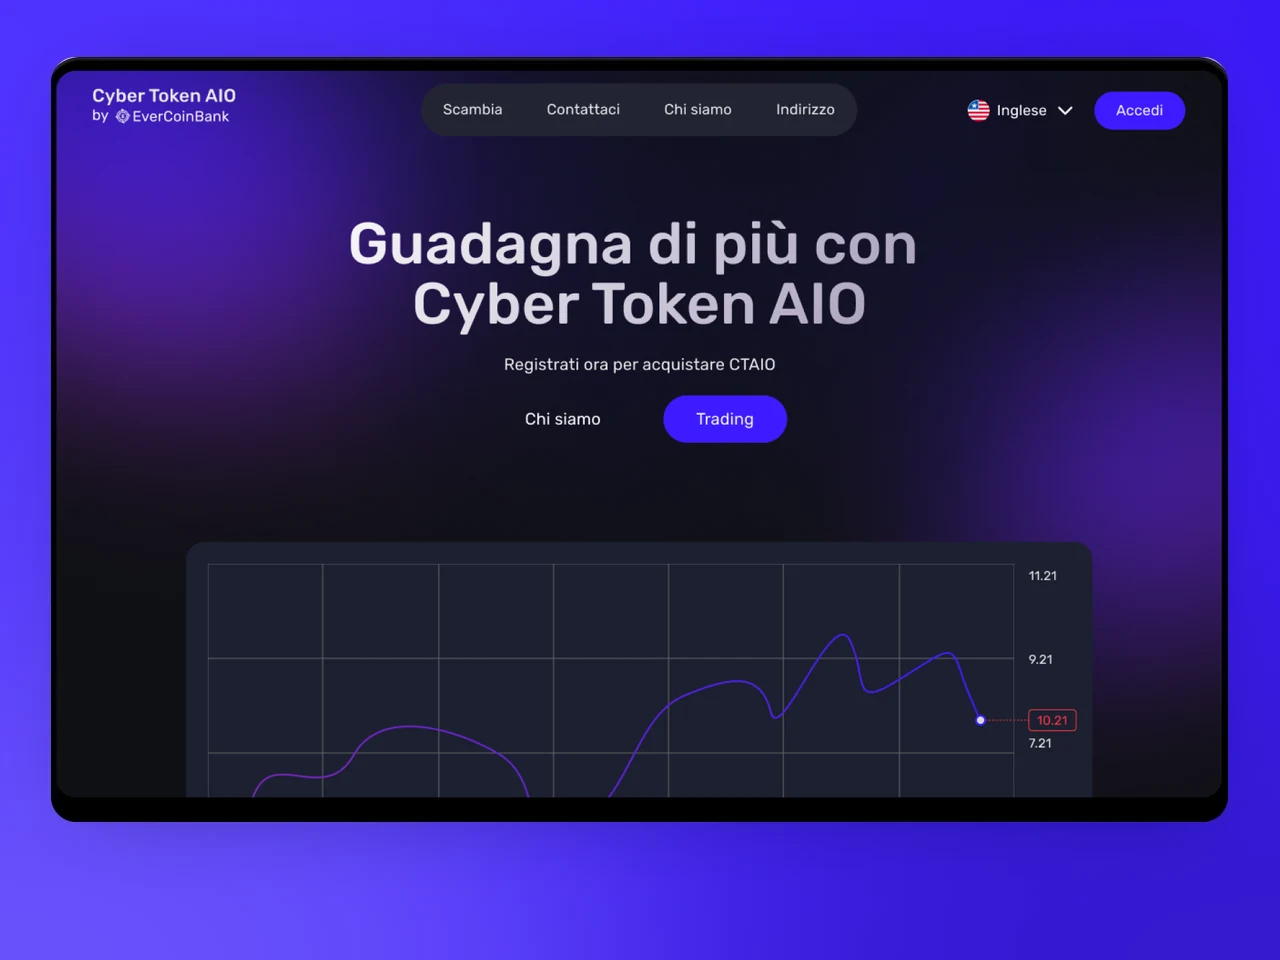
Lancio ERC-20 end-to-end — contratto Solidity, audit di sicurezza, listing sugli exchange, checkout MetaMask sul sito del progetto.
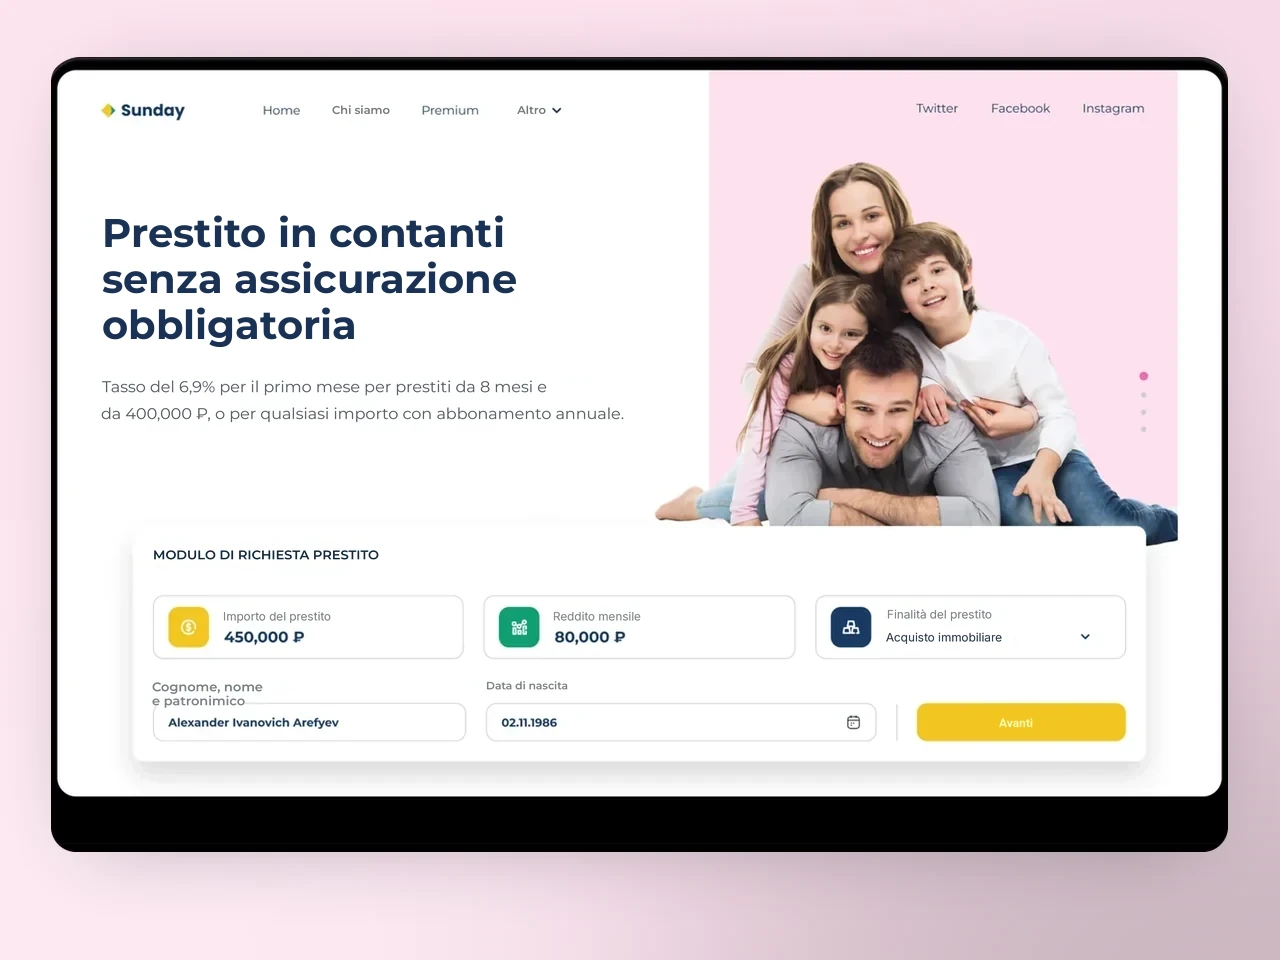
Motore decisionale per prestiti ad alto throughput su Laravel — scoring automatizzato, integrazione con le agenzie di credito e decisioni 10 volte più rapide per istituti di credito USA e UE.
L'AI è utile solo quando rispetta la realtà di dati, latenza e normative del vostro settore. Uniamo ML e data engineering a una conformità specifica per settore nei mercati USA e UE.
Modelli di scoring, segnali di frode e document processing con decisioni auditabili e flussi di dati in scope PCI DSS.
ML HIPAA-capable e allineato al GDPR su dati clinici e dei pazienti, con flussi di dati documentati e BAA.
Modelli di ricerca, raccomandazione e previsione della domanda, più le piattaforme dati che li alimentano.
Modelli di routing, ETA e dispatch su pipeline di eventi in tempo reale con dati di corrieri terzi.
Conforme GDPR · Pronto per ISO 27001 · SOC 2 Type II in corso · Compatibile HIPAA · CCPA riconosciuto
Data engineer e ML lead in orario CET con sovrapposizione costa est USA (9:00-13:00 ET), sui vostri standup, con decisioni in giornata su prompt, modelli e rollout.
ML engineer e data platform lead con sistemi in produzione USA e UE già rilasciati. Non impar iamo i vector database sulla vostra roadmap.
Endpoint hosted con region-lock (residenza dati UE · opzioni USA su richiesta), configurazioni zero-retention, DPA e BAA firmati, controlli allineati a ISO 27001 con SOC 2 Type II in corso. Scope PCI DSS dove il ML tocca i pagamenti; HIPAA-capable dove il ML tocca PHI.
La doppia governance AI è parte di ogni decisione architetturale: nell'UE applichiamo l'AI Act (classificare ogni caso d'uso, documentare il sistema, definire i punti di supervisione umana, preparare le evidenze per scenari ad alto rischio come assunzione, credit scoring e trattamento biometrico); negli USA applichiamo gli executive order federali sull'AI, il NIST AI RMF (Govern / Map / Measure / Manage), le aspettative OMB M-24-10 e le screening statali — Colorado AI Act (in vigore dal 2026), NYC AEDT (Local Law 144), NY AI Bill of Rights e norme CCPA / CPRA sul processo decisionale automatizzato.
Un motore di decisione sui prestiti che impiega dieci volte meno tempo per approvare non avviene per caso. YuSMP ha costruito la pipeline di scoring, l’integrazione con i bureau del credito e un back-office che i nostri sottoscrittori apprezzano davvero. I tempi di approvazione sono passati da due giorni a meno di quattro ore.
Aggregare i prezzi in tempo reale su più exchange mantenendo la latenza sotto i 500 ms è ingegneria davvero complessa. YuSMP ha integrato il feed multi-exchange, i grafici dei token in tempo reale e il flusso di listing in una piattaforma coerente. Non abbiamo avuto un’interruzione dal lancio.
1 / 2
La decisione giusta sull'infrastruttura AI dipende dalla sensibilità dei vostri dati, dal volume di query, dai requisiti di latenza e dalla capacità organizzativa di gestire sistemi AI in produzione.
Usare l'API di GPT-4 è la scelta giusta per compiti general-purpose dove l'accuratezza specifica di dominio non è critica, il time-to-market è prioritario e i costi per query sono accettabili al vostro volume previsto.
Il fine-tuning di modelli open-source (Llama 3 70B, Mistral 7B) diventa economicamente giustificato quando processate più di 1 milione di token al giorno (il costo API supera il costo di hosting GPU), avete bisogno di una latenza di inferenza sotto i 500ms, richiedete che i dati restino on-premise per motivi di conformità, o avete bisogno di un formato di output coerente che il solo prompt engineering non riesce a garantire in modo affidabile.
Le tecniche di fine-tuning parameter-efficient LoRA e QLoRA riducono la memoria GPU e il tempo di training richiesti per il fine-tuning di modelli grandi dell'80–90%, rendendo il fine-tuning accessibile su singole GPU A100 o istanze spot cloud. Progettiamo pipeline di fine-tuning, curiamo dataset di training specifici per dominio, ed eseguiamo valutazioni benchmark sistematiche confrontando il modello fine-tuned con la baseline di GPT-4 sul vostro compito specifico prima di impegnarvi nell'investimento infrastrutturale.
Gli LLM open-source (Llama 3, Mistral, Falcon, Qwen) vi danno il controllo completo sulla gestione dei dati, consentono deployment offline e air-gapped, eliminano i costi API per token su larga scala e possono essere personalizzati senza il permesso del fornitore.
I modelli proprietari (GPT-4, Claude, Gemini Ultra) offrono prestazioni allo stato dell'arte su compiti di ragionamento complesso, non richiedono gestione dell'infrastruttura e offrono un time-to-pilot più rapido.
La decisione dipende dai vostri requisiti di sensibilità dei dati, dal volume di inferenza, dai benchmark di performance sui vostri compiti specifici e dalla capacità AI organizzativa. Per sanità e servizi finanziari con rigidi requisiti di residenza dei dati, i modelli open-source su infrastruttura privata sono spesso obbligatori. Per i team di prodotto che costruiscono rapidamente funzionalità AI-assistite, le API proprietarie con forti rate limit e performance coerenti sono di solito il punto di partenza più pragmatico.
L'inferenza su GPU cloud (AWS SageMaker, GCP Vertex AI, Azure ML) è ottimale per carichi di lavoro variabili, progetti pilota e team senza competenze di gestione cluster GPU, con costi che vanno da $2–8/ora per GPU A100.
L'inferenza on-premise diventa conveniente quando l'utilizzo GPU supera costantemente il 60%, quando i requisiti normativi proibiscono l'invio di dati ai fornitori cloud, o quando gli obiettivi di latenza di inferenza non possono essere raggiunti con round-trip su API cloud.
Analizziamo il profilo del vostro carico di lavoro, i requisiti di residenza dei dati e la proiezione di costo su 3 anni per raccomandare la giusta strategia infrastrutturale. Per la maggior parte delle applicazioni AI enterprise, un approccio hybrid — GPU cloud per il training del modello e l'inferenza batch, istanze on-prem o cloud dedicate per il serving in tempo reale dei modelli in produzione — bilancia efficienza dei costi con requisiti di latenza e conformità normativa.
I progetti hanno scope fisso e sono snelli, all-in e denominati in USD. Un PoC / pilot parte da $2,900 (4–6 settimane); RAG sulla vostra knowledge base da $8,100; un AI agent autonomo da $10,400; un modello ML in produzione da $13,800. Il numero esatto dipende da quanti casi d'uso rilasciate, dalla profondità del corpus e dalla dimensione dell'eval set, dagli obiettivi di latenza e dallo scope di conformità. Vedete il budget dettagliato al termine della discovery e lo approvate prima che venga scritto qualsiasi codice. Non c'è alcun ricarico di recruiting né sovrapprezzo per i tool, e i costi cloud e GPU passano dai vostri account, così mantenete la leva sui costi.
Valutiamo i modelli candidati sui vostri task reali prima di raccomandare. Mistral / Claude / OpenAI con region-lock su Bedrock, Vertex o Azure OpenAI (hosted UE per clienti UE, hosted USA per clienti USA), e modelli open-source su cluster UE o USA, spesso battono la scelta ovvia su costo e residenza dei dati una volta misurata la latenza end-to-end e l'accuratezza.
Per la maggior parte dei casi d'uso legati alla knowledge base, il retrieval-augmented generation con eval solide batte il fine-tuning. Passiamo al fine-tuning o a LoRA solo quando gli obiettivi di stile, latenza o costo non possono essere raggiunti con RAG, e misuriamo il guadagno.
Versioning dei prompt, eval deterministiche, prompt di red-team, filtri sull'output e human-in-the-loop sui percorsi ad alto rischio. Ogni release viene rilasciata con una dashboard di qualità e sicurezza misurabile, non solo un controllo a sensazione.
La maggior parte dei prodotti SaaS utilizza l'AI in ruoli a rischio limitato o minimo, che richiedono avvisi di trasparenza e logging di base. Aiutiamo a classificare i vostri casi d'uso, a documentare il sistema e a prepararsi agli obblighi ad alto rischio se assunzione, credito o biometria rientrano nello scope.
Per i deployment USA mappiamo i controlli rispetto al NIST AI Risk Management Framework (Govern / Map / Measure / Manage), ci allineiamo agli executive order federali sull'AI e alle aspettative OMB M-24-10, e pre-screening i casi d'uso rispetto alle leggi statali — il Colorado AI Act (in vigore dal 2026), NYC AEDT (Local Law 144), il NY AI Bill of Rights e le norme CCPA / CPRA sul processo decisionale automatizzato. Documentiamo classe di rischio, avvisi di trasparenza, supervisione umana e valutazioni d'impatto in una singola AI system card per deployment.
Sì. Utilizziamo endpoint con region-lock di Bedrock, Vertex, Azure OpenAI e Mistral — hosted UE per clienti UE (residenza dati UE), hosted USA per clienti USA (opzioni USA su richiesta, BAA disponibili per carichi di lavoro HIPAA-capable). Modelli open source self-hosted su cluster UE o USA quando la residenza è critica. DPA, BAA e configurazioni zero-retention fanno parte di ogni revisione dell'architettura.
Diteci dove volete essere tra dodici mesi. Vi risponderemo con un piano per arrivarci.
Approfondimenti e guide pratiche dal nostro blog per i team di prodotto e ingegneria di USA e UE.
Quanto costa lo sviluppo IA nel 2026: prezzi per tipo di progetto, fattori di costo, costi di esercizio e come stimare il budget…
Come le aziende integrano l’IA nel software esistente nel 2026 — casi d’uso, ERP/CRM e sistemi legacy, governance…
Guida 2026 agli agenti AI enterprise: selezione del modello (Claude 4.6, GPT-4o, Gemini 2.5), orchestrazione con…
Benchmark 2026 sui costi di fine-tuning LLM: prezzi GPU H100/H200/B200, budget di curation dei dataset e LoRA vs…
Condividete alcuni dettagli e un consulente senior risponderà entro un giorno lavorativo.
Email: sales@yusmpgroup.com
Telefono: +374 44 871 811
Uffici: KAMAR Business Center, Vazgen Sargsyan St. 2, Erevan, Armenia · Remoto — sovrapposizione con la costa est degli Stati Uniti (9:00–13:00 ET)