Blog News Contatti Richiedi una proposta

Sviluppo Snowflake che scala il compute senza costi fuori controllo

Costruiamo piattaforme Snowflake in produzione per team di dati in USA e UE — dal dimensionamento del warehouse e le pipeline ELT alle app Snowpark e la governance basata su ruoli. I nostri ingegneri separano deliberatamente storage e compute, così si paga solo per le query eseguite. Ogni deployment è consapevole della regione, attento a GDPR e HIPAA, e strumentato per il consumo di credit dal primo giorno.

  • Snowflake
  • virtual warehouse
  • Snowpark
  • Stream e Task

Costruiamo piattaforme Snowflake in produzione per team di dati in USA e UE — dal dimensionamento del warehouse e le pipeline ELT alle app Snowpark e la governance basata su ruoli. I nostri ingegneri separano deliberatamente storage e compute, così si paga solo per le query eseguite. Ogni deployment è consapevole della regione, attento a GDPR e HIPAA, e strumentato per il consumo di credit dal primo giorno.

Sfide di settore che risolviamo

Dimensionamento warehouse e credit fuori controllo

Warehouse sovradimensionati, auto-suspend assente e cluster inattivi consumano silenziosamente credit. Senza attribuzione per team, le fatture mensili Snowflake crescono senza un responsabile o un tetto chiaro.
Modellazione dati: ELT vs ETL

Caricare dati grezzi e trasformarli nel warehouse richiede layer disciplinati di staging, pulizia e mart. Saltare questa struttura lascia SQL fragile e non testato che nessuno può modificare in sicurezza.

Governance e RBAC su larga scala

I grant di ruolo piatti o ad hoc diventano ingestibili man mano che crescono schema, team e share esterne. Un accesso troppo ampio genera riscontri di audit ed espone colonne sensibili.

Ingestione: Snowpipe, batch e CDC

Collegare caricamenti Snowpipe continui, file batch schedulati e change-data-capture da database operativi è soggetto a errori, con lacune, duplicati e dati in ritardo.

Performance di query e cluster key

Cluster key scadenti, micro-partition in espansione e scansioni non potate rendono le dashboard lente e costose. Lo spill verso lo storage remoto segnala warehouse in conflitto con il layout dei dati.

Cancellazione GDPR e masking

I diritti di cancellazione e le norme sulla residenza dei dati si scontrano con time-travel, fail-safe e share replicate. I dati personali devono essere rintracciabili, mascherabili e cancellabili in ogni copia.

Soluzioni che realizziamo

Progettazione warehouse e ottimizzazione dei costi

Dimensioniamo correttamente i virtual warehouse, impostiamo auto-suspend/resume, separiamo i carichi di lavoro per warehouse e aggiungiamo resource monitor con attribuzione dei credit per team, così la spesa è prevedibile e visibile.

Pipeline ELT con dbt, Stream e Task

Costruiamo ELT testata e version-controlled in dbt, orchestrata con Stream e Task o dynamic table, con modelli incrementali, data test e lineage completo.

Modellazione dati a layer

Strutturiamo layer di staging, intermedi e mart con naming e ownership chiari, affinché i modelli analytics siano riutilizzabili, documentati e sicuri da evolvere.

Ingestione: Snowpipe, Fivetran e CDC

Implementiamo Snowpipe continuo, connettori gestiti (Fivetran/Airbyte) e pipeline CDC con carichi idempotenti, gestione della schema drift e monitoraggio della freschezza.

App Snowpark e ML

Spostiamo i carichi di lavoro Python, Scala e ML in Snowpark affinché la trasformazione e la feature engineering girino accanto ai dati, senza esportarli su compute esterno.

Governance e RBAC

Progettiamo gerarchie di ruoli, masking basato su tag e policy di row access, con provisioning SSO/SCIM e revisioni degli accessi che reggono gli audit SOC 2 e GDPR.

Stack tecnologico

  • Snowflake
  • virtual warehouse
  • Snowpark
  • Stream e Task
  • dbt
  • Fivetran/Airbyte
  • dynamic table
  • accesso basato su ruoli
  • Terraform

Conformità normativa

GDPR · residenza dei dati · Idoneo HIPAA · SOC 2

UE

  • GDPR — deployment in una regione UE di Snowflake (Francoforte, Dublino, Amsterdam), dynamic data masking sui dati personali e retention a livello di colonna con limiti di time-travel.
  • EU AI Act — lineage end-to-end e log di accesso su Stream, Task e dynamic table affinché i dataset di training AI siano tracciabili e auditabili.
  • eIDAS — integrazione con provider di identità e firma qualificati, con provisioning SSO e SCIM nei ruoli Snowflake.
  • NIS2 — policy di rete, connettività privata (PrivateLink), MFA obbligatorio e audit trail pronti per gli incidenti per gli obblighi degli operatori essenziali.

USA

  • HIPAA — deployment con BAA Snowflake su un'edizione idonea HIPAA, con masking PHI, policy di row access e archiviazione tri-secret secure.
  • PCI DSS — tokenizzazione dei dati titolari di carta, warehouse segregati e ruoli con privilegi minimi per le analytics in scope.
  • SOC 2 — revisioni degli accessi, gestione delle modifiche e monitoraggio della query history allineati ai criteri di sicurezza, disponibilità e riservatezza.
  • CCPA/CPRA — inventario dei dati consumer, workflow di cancellazione e applicazione dell'opt-out costruiti su colonne di dati personali taggati.

Cosa dicono i clienti

“
Aggregare i prezzi in tempo reale su più exchange mantenendo la latenza sotto i 500 ms è ingegneria davvero complessa. YuSMP ha integrato il feed multi-exchange, i grafici dei token in tempo reale e il flusso di listing in una piattaforma coerente. Non abbiamo avuto un’interruzione dal lancio.
Martin WebbCTO, EverCoin Bank
Vedi il caso →
“
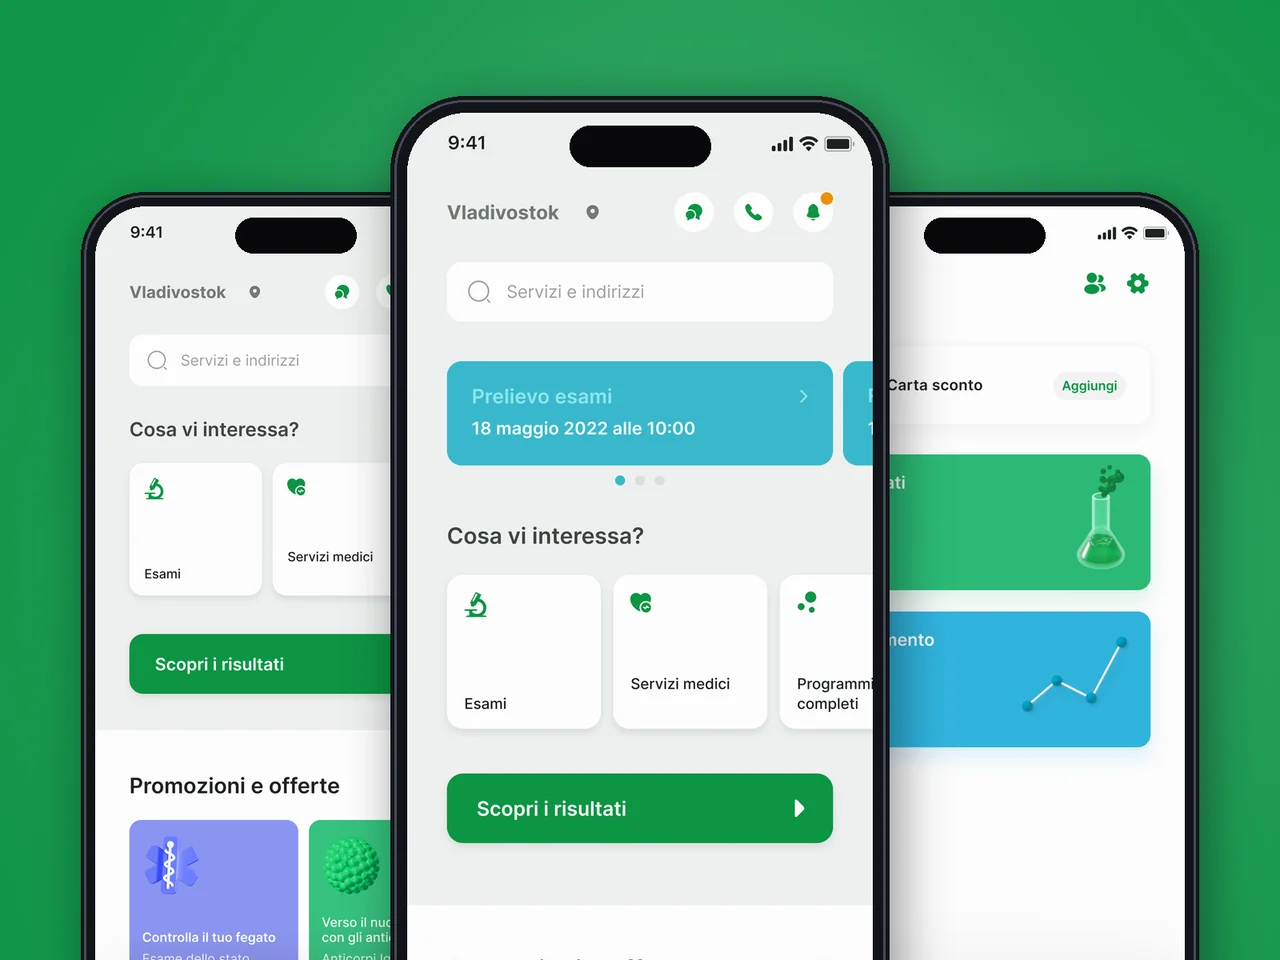
Gestire appuntamenti e referti in più città su tre piattaforme è genuinamente complesso. YuSMP ha risolto un problema di integrazione legacy che avevamo evitato per due anni e ha rilasciato un'esperienza paziente che i nostri punteggi NPS hanno immediatamente rispecchiato.
James WhitfieldHead of Digital, Unilab
Vedi il caso →
“
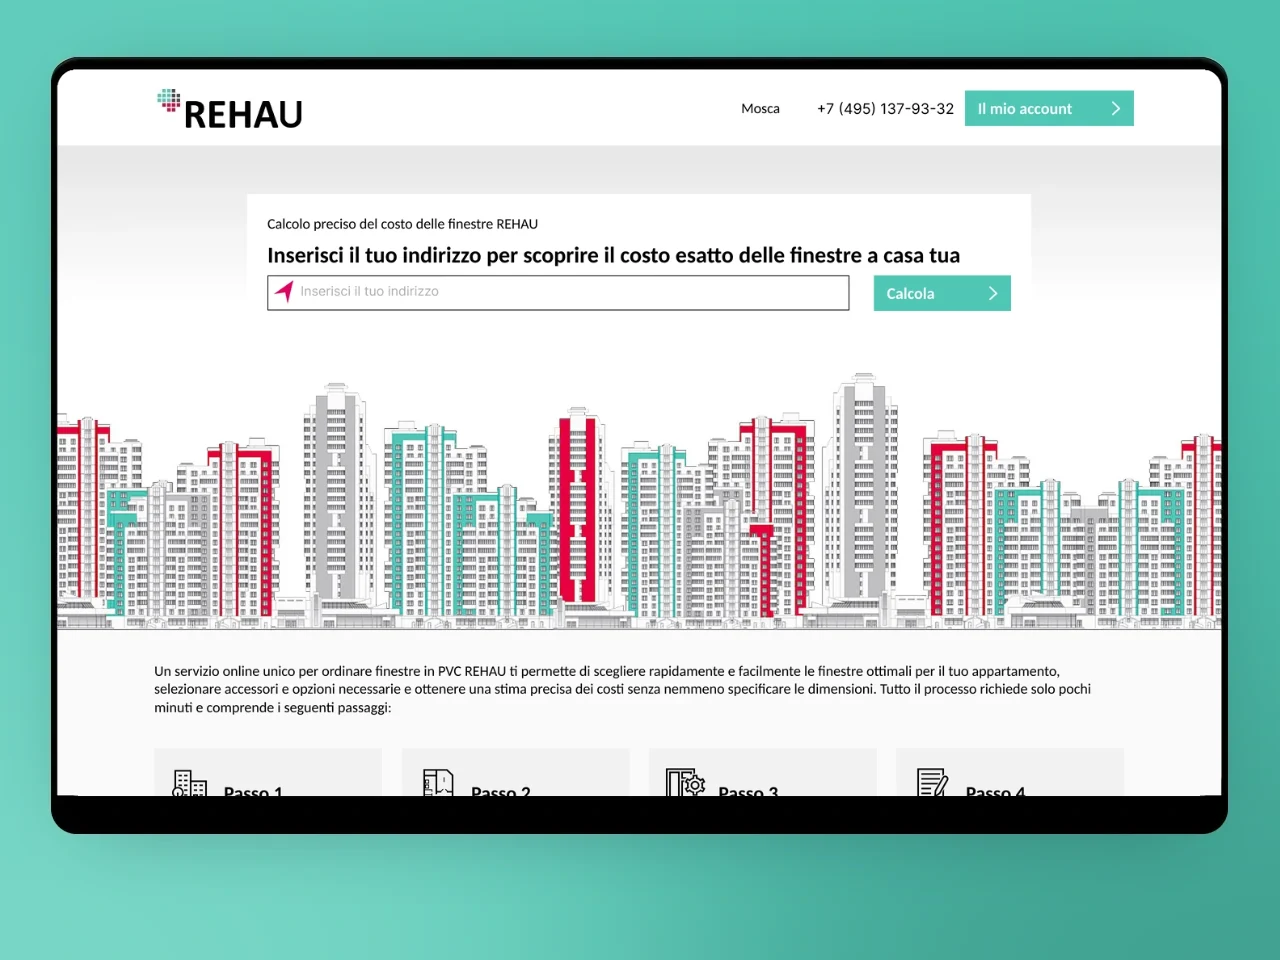
Il commercio B2B per un brand di prodotti polimerici significa configuratori di prodotti complessi, livelli di prezzo per i dealer e flussi di ordini che gli acquirenti non tecnici devono navigare. YuSMP ha costruito una piattaforma che i nostri dealer hanno adottato senza una singola sessione di formazione. I volumi di ordini tramite il portale sono raddoppiati nel primo anno.
Stefan NeumannHead of E-Commerce, REHAU
Vedi il caso →
“
Un motore di decisione sui prestiti che impiega dieci volte meno tempo per approvare non avviene per caso. YuSMP ha costruito la pipeline di scoring, l’integrazione con i bureau del credito e un back-office che i nostri sottoscrittori apprezzano davvero. I tempi di approvazione sono passati da due giorni a meno di quattro ore.
Gregory LawsonCTO, LoanFlow
Vedi il caso →

1 / 4

Perché i team di dati scelgono YuSMP per lo sviluppo Snowflake

Data engineer, non generalisti

Il nostro team lavora quotidianamente con Snowflake, dbt e Snowpark — sappiamo dove perdono credit, perché le partizioni si gonfiano e come modellare per il cambiamento piuttosto che per la demo.

Il costo è un deliverable di primo piano

Strumentiamo il consumo di credit dal primo warehouse, impostiamo resource monitor e rendiconto la spesa per team, così finanza e engineering vedono gli stessi numeri.

Costruito per la conformità USA e UE

Eseguiamo il deployment nella regione corretta, applichiamo masking e policy di accesso sin dall'inizio e documentiamo il lineage — così le revisioni GDPR, HIPAA, SOC 2 e CCPA sono routine, non emergenze.

FAQ

Domande frequenti sullo sviluppo Snowflake

Come si confronta Snowflake con BigQuery, Databricks e Redshift?

Snowflake separa storage e compute con più virtual warehouse indipendenti, così i carichi di lavoro non competono mai per le risorse e si scalano singolarmente. BigQuery è serverless e ottimo per analytics ad hoc su stack Google; Databricks è leader per carichi Spark pesanti e ML/lakehouse; Redshift si adatta ai team profondamente integrati in AWS che accettano la gestione dei nodi. Aiutiamo a scegliere, e spesso eseguiamo Snowflake insieme a Databricks per la parte ML.

Come funzionano realmente i credit e i costi di Snowflake, e come si controllano?

Si paga il compute in credit, fatturati al secondo mentre un virtual warehouse è in esecuzione, più lo storage separato. I costi sfuggono di controllo quando i warehouse sono sovradimensionati, non si sospendono automaticamente o un unico warehouse serve ogni carico di lavoro. Dimensioniamo correttamente i warehouse, abilitiamo auto-suspend/resume, separiamo i carichi di lavoro e aggiungiamo resource monitor con attribuzione per team così la spesa è limitata e tracciabile.

Qual è la differenza tra ELT ed ETL in Snowflake?

ETL trasforma i dati prima del caricamento; ELT carica prima i dati grezzi, poi li trasforma all'interno di Snowflake usando il suo compute. ELT è il default moderno qui perché Snowflake scala le trasformazioni a basso costo e strumenti come dbt le rendono testabili e version-controlled. Costruiamo modelli a layer da staging a mart affinché le trasformazioni rimangano documentate e sicure da modificare.

Cos'è Snowpark e quando usarlo?

Snowpark consente di eseguire Python, Scala o Java — inclusi codice DataFrame e modelli ML — direttamente all'interno di Snowflake, accanto ai dati, invece di esportarli su un cluster separato. È indicato per la feature engineering, le trasformazioni complesse e lo scoring dove lo spostamento dei dati è il collo di bottiglia. Lo utilizziamo per consolidare le pipeline e mantenere i dati sensibili all'interno del perimetro governato.

Come funziona il data sharing in Snowflake?

Il secure data sharing espone dati live in sola lettura ad altri account Snowflake senza copiarli — i consumer interrogano i vostri dati e voi controllate l'accesso tramite share e il Marketplace. È ideale per partner, sussidiarie e data product. Progettiamo le share con policy di riga e colonna affinché si condivida esattamente il sottoinsieme corretto e nulla di più.

Snowflake può soddisfare i requisiti HIPAA e di residenza dati UE?

Sì. Snowflake offre un BAA sulle edizioni idonee HIPAA, e si sceglie la regione cloud, così i dati UE possono restare a Francoforte, Dublino o Amsterdam. Eseguiamo il deployment nella regione corretta, applichiamo masking PHI e policy di row access, e configuriamo retention e time-travel per soddisfare gli obblighi di cancellazione GDPR.

Quando Snowflake non è la scelta giusta?

Snowflake non è progettato per lookup operativi sub-secondo, scritture transazionali ad alta frequenza o streaming di eventi realmente real-time — per questi casi si adatta meglio un sistema OLTP o di streaming dedicato. Per dataset molto piccoli e a basso volume la piattaforma può essere più del necessario. Comunichiamo onestamente quando un database più leggero o un motore di streaming è la scelta migliore.

Pronti a costruire una piattaforma Snowflake che scala senza sorprese?

Diteci dove volete essere tra dodici mesi. Vi risponderemo con un piano per arrivarci.

Richiedi una proposta

Risposta entro 1 giorno lavorativo. NDA su richiesta.

Richiedi una proposta

Condividete alcuni dettagli e un consulente senior risponderà entro un giorno lavorativo.

Stima del progetto gratuita — ti inviamo un piano entro 1–2 giorni lavorativi.
  • Analisi dei requisiti e consigli sullo stack tecnologico
  • Stima di tempi, budget e composizione del team
  • Senza impegno — solo un piano chiaro

Email: sales@yusmpgroup.com

Telefono: +374 44 871 811

Uffici: KAMAR Business Center, Vazgen Sargsyan St. 2, Erevan, Armenia · Remoto — sovrapposizione con la costa est degli Stati Uniti (9:00–13:00 ET)

— campi obbligatori