Struttura del progetto scalabile
Senza una stratificazione deliberata staging → intermediate → mart, i progetti dbt si espandono in centinaia di modelli interdipendenti che nessuno riesce a navigare o rifattorizzare in sicurezza.
Costruiamo il livello di trasformazione del vostro moderno data stack con dbt — trasformando le tabelle grezze del warehouse in prodotti dati governati, testati e documentati. I nostri analytics engineer servono team dati statunitensi ed europei che necessitano di mart affidabili, lineage chiara ed esecuzioni veloci e cost-aware. Da progetti dbt greenfield al recupero di SQL intricato, consegniamo modelli manutenibili di cui analisti e stakeholder si fidano davvero.
Costruiamo il livello di trasformazione del vostro moderno data stack con dbt — trasformando le tabelle grezze del warehouse in prodotti dati governati, testati e documentati. I nostri analytics engineer servono team dati statunitensi ed europei che necessitano di mart affidabili, lineage chiara ed esecuzioni veloci e cost-aware. Da progetti dbt greenfield al recupero di SQL intricato, consegniamo modelli manutenibili di cui analisti e stakeholder si fidano davvero.
Senza una stratificazione deliberata staging → intermediate → mart, i progetti dbt si espandono in centinaia di modelli interdipendenti che nessuno riesce a navigare o rifattorizzare in sicurezza.
Le esecuzioni naive con full-refresh rielaborano l'intera cronologia ad ogni build, bruciando crediti del warehouse; scegliere la giusta strategia incrementale e gestire i dati in ritardo è genuinamente difficile.
I modelli non testati rompono silenziosamente i dashboard downstream; i team faticano a decidere cosa testare, dove e con quale rigore senza rallentare ogni esecuzione.
Jinja eccessivamente elaborato e SQL copiato-incollato violano il principio DRY e diventano illeggibili; il sottoutilizzo delle macro lascia la logica duplicata in decine di modelli.
Eseguire e testare solo ciò che è cambiato (slim CI) rispetto ad ambienti effimeri o isolati non è banale, eppure senza di esso ogni pull request mette a rischio l'intero warehouse.
Man mano che i modelli si moltiplicano, la lineage diventa oscura, la documentazione si deteriora e nessuno è responsabile di un determinato mart — rendendo impossibili l'analisi degli impatti e la fiducia.
Strutturiamo i progetti in livelli staging, intermediate e mart con naming coerente, sorgenti e convenzioni di cartelle in modo che il progetto rimanga leggibile man mano che cresce.
Implementiamo le materializzazioni e le strategie incrementali corrette (merge, insert-overwrite, microbatch), gestiamo i dati in ritardo e la policy di full-refresh, e riduciamo la spesa del warehouse.
Aggiungiamo test generici e singolari, contratti di schema, controlli di freshness e pacchetti in modo che i fallimenti emergano nel CI — non nel dashboard di uno stakeholder.
Estraiamo la logica condivisa in macro ben documentate e adottiamo pacchetti collaudati (dbt_utils, codegen, dbt_expectations) per mantenere il codebase DRY e coerente.
Configuriamo slim CI sulle pull request, separiamo i target dev/CI/prod e automatizziamo le build in modo che solo i modelli modificati e i loro figli vengano eseguiti e testati prima del merge.
Generiamo la documentazione dbt con lineage completa, aggiungiamo descrizioni, exposures e metadati di ownership, e definiamo un modello di governance su cui l'intero team può fare affidamento.
GDPR · qualità dei dati testata · lineage/governance · SOC 2
Unified crypto-ecosystem hub aggregating multiple tokens — live exchange data, search, charts, direct purchase entry point.
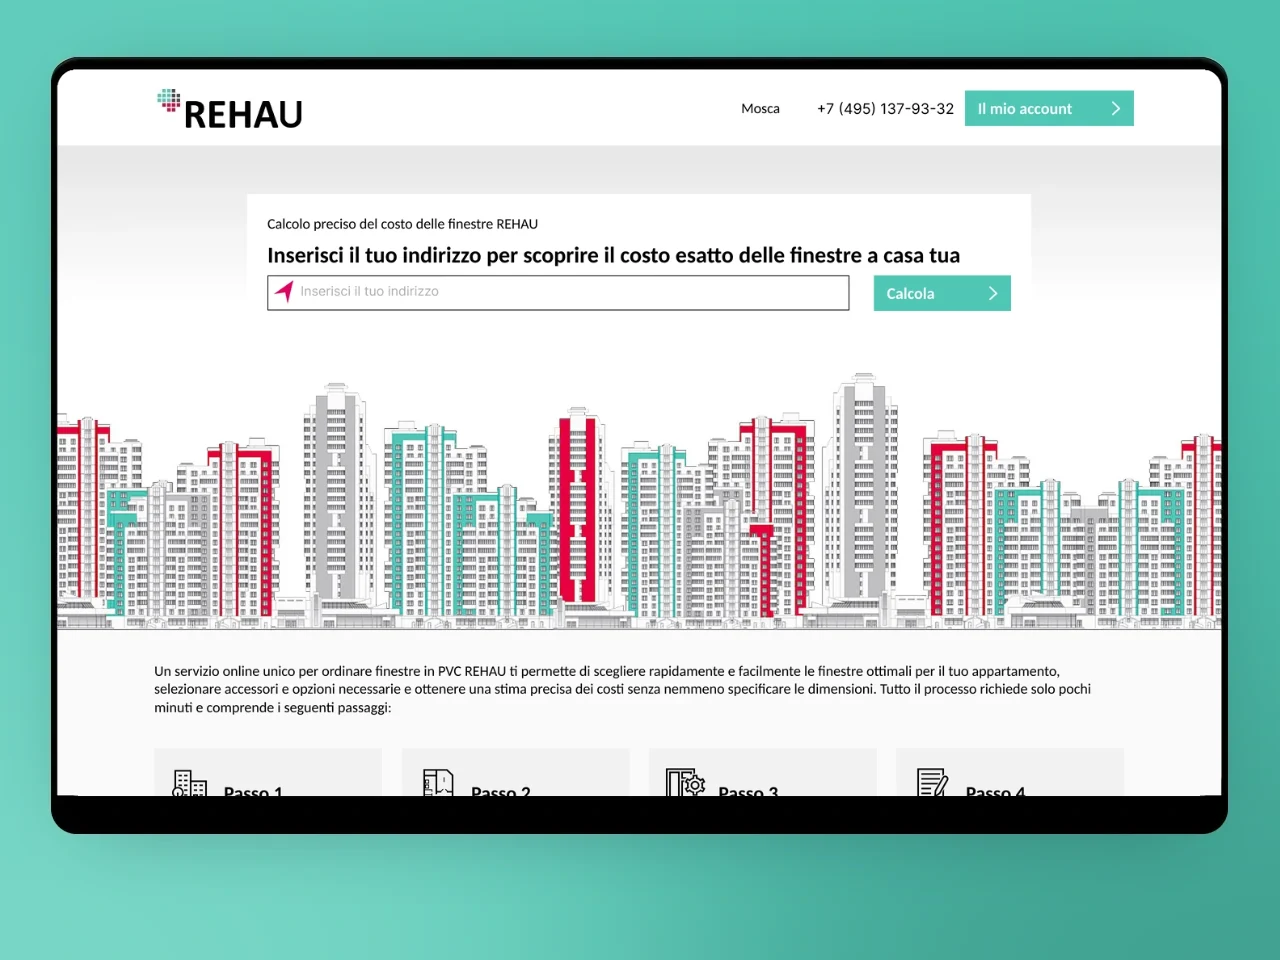
E-commerce B2B e configuratore di prodotto per un produttore globale di polimeri con prezzi multi-regione e workflow dealer.
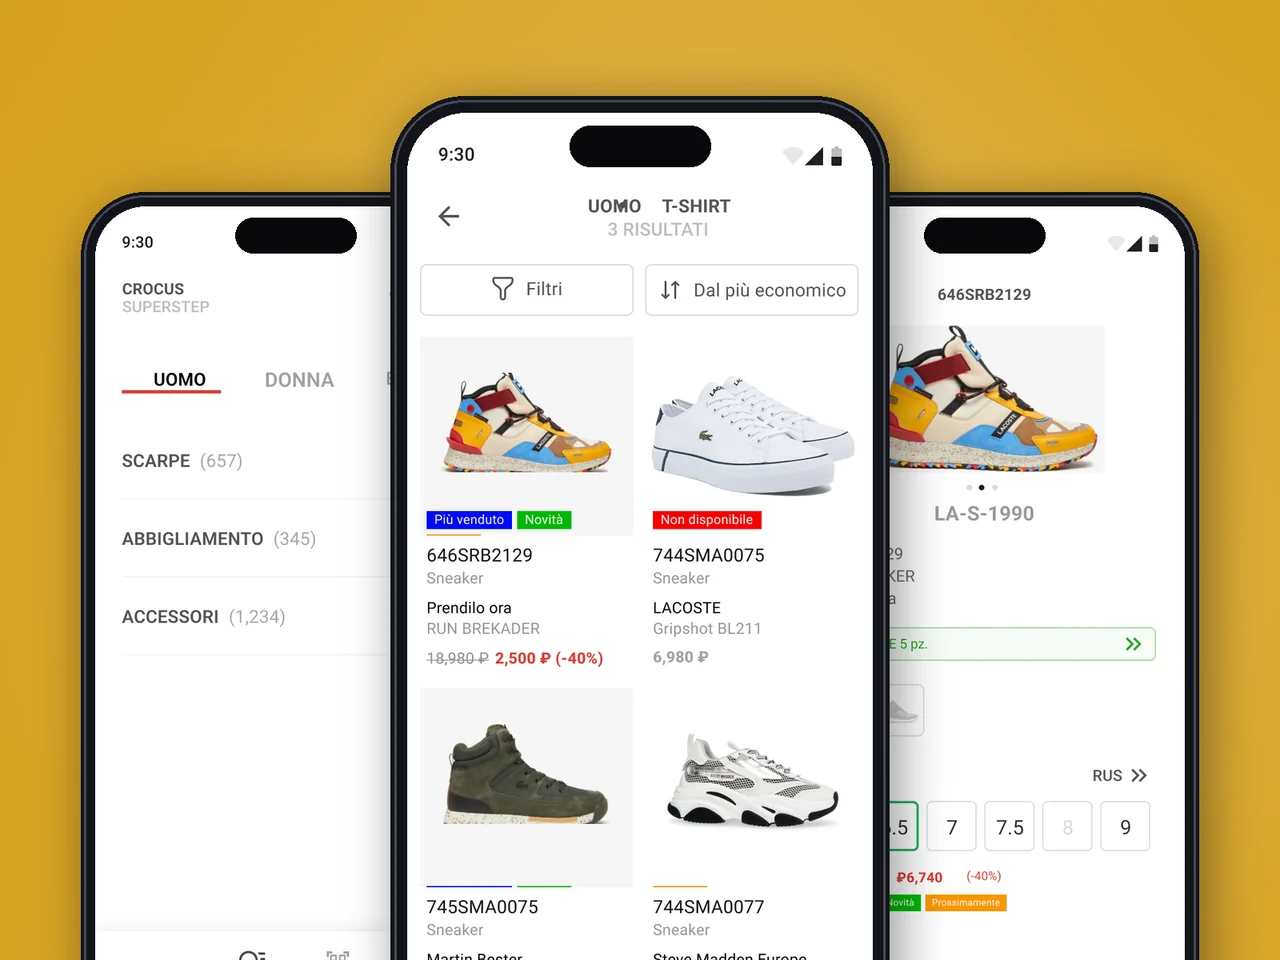
Retail POS companion app for a multi-brand boutique chain — ElasticSearch cross-store inventory search, 1C-system integration.
Aggregare i prezzi in tempo reale su più exchange mantenendo la latenza sotto i 500 ms è ingegneria davvero complessa. YuSMP ha integrato il feed multi-exchange, i grafici dei token in tempo reale e il flusso di listing in una piattaforma coerente. Non abbiamo avuto un’interruzione dal lancio.
I nostri consulenti perdevano 15 minuti per cliente nei controlli manuali dell'inventario. YuSMP ha sviluppato app native basate su ElasticSearch, collegate al nostro sistema 1C in tempo reale. Il tempo per cliente è diminuito del 40% in tutte le sedi entro una settimana dal lancio.
Il commercio B2B per un brand di prodotti polimerici significa configuratori di prodotti complessi, livelli di prezzo per i dealer e flussi di ordini che gli acquirenti non tecnici devono navigare. YuSMP ha costruito una piattaforma che i nostri dealer hanno adottato senza una singola sessione di formazione. I volumi di ordini tramite il portale sono raddoppiati nel primo anno.
Un motore di decisione sui prestiti che impiega dieci volte meno tempo per approvare non avviene per caso. YuSMP ha costruito la pipeline di scoring, l’integrazione con i bureau del credito e un back-office che i nostri sottoscrittori apprezzano davvero. I tempi di approvazione sono passati da due giorni a meno di quattro ore.
1 / 4
Sappiamo che dbt fa la T nell'ELT — trasforma i dati già presenti nel vostro warehouse, non è uno strumento di ingestione né un orchestratore — quindi progettiamo pipeline aderenti alla realtà.
Ogni modello che consegniamo è corredato di test, documentazione e lineage, in modo che analisti, dirigenti e sistemi downstream possano fare affidamento sui numeri.
Snowflake, BigQuery, Databricks o Redshift — ottimizziamo le materializzazioni, i costi e le specifiche degli adapter per la vostra piattaforma invece di usare un template uguale per tutti.
Domande frequenti
dbt (data build tool) gestisce il passaggio di trasformazione nell'ELT. Dopo che i dati grezzi vengono caricati nel warehouse, dbt esegue i modelli SQL per pulirli, unirli e aggregarli in tabelle e viste pronte per l'analisi. Non acquisisce dati e non è un orchestratore: trasforma i dati già presenti nel warehouse.
dbt Core è lo strumento a riga di comando gratuito e open-source che si esegue autonomamente nella propria infrastruttura o CI. dbt Cloud è il prodotto commerciale ospitato che aggiunge uno scheduler gestito, un IDE, integrazioni CI e un livello di docs/metadati ospitato. Lavoriamo con entrambi e aiutiamo a scegliere in base alla dimensione del team, alle esigenze di governance e al budget.
I modelli incrementali costruiscono solo le righe nuove o modificate ad ogni esecuzione invece di ricostruire l'intera tabella. Riducono drasticamente il costo del warehouse e i tempi di esecuzione su dataset grandi ad alto tasso di append. Aggiungono complessità intorno ai dati in ritardo e ai refresh completi, quindi li applichiamo dove il volume lo giustifica e manteniamo i modelli più piccoli come semplici materializzazioni di tabelle o viste.
dbt consente di dichiarare test — generici come not-null, unique e relationships, più test singolari personalizzati — che vengono eseguiti come parte di ogni build. Combinati con i controlli di freshness delle sorgenti e pacchetti come dbt_expectations, intercettano i dati errati prima che raggiungano i dashboard. Progettiamo una test suite esaustiva senza rendere le esecuzioni eccessivamente lente.
Il warehouse (Snowflake, BigQuery, ecc.) memorizza e calcola i dati; dbt definisce ed esegue le trasformazioni SQL al suo interno; e un orchestratore come Airflow pianifica e avvia le esecuzioni dbt insieme all'ingestione e ad altri task. dbt stesso non pianifica le pipeline: viene invocato da un orchestratore o dallo scheduler di dbt Cloud.
dbt supporta tutti i principali warehouse cloud tramite adapter, tra cui Snowflake, Google BigQuery, Databricks, Amazon Redshift, Postgres e altri. Ottimizziamo le materializzazioni, le prestazioni e i costi per la vostra piattaforma specifica, poiché ogni adapter ha il proprio dialetto SQL e le proprie leve di ottimizzazione.
Per un dataset ridotto con una o due tabelle semplici e nessuna logica di trasformazione reale, un paio di viste SQL o uno script leggero possono essere sufficienti: la struttura del progetto dbt, i test e il CI aggiungono un overhead che potrebbe non essere ancora necessario. dbt si ripaga quando si hanno più modelli, diversi collaboratori, problemi ricorrenti di qualità o la necessità di lineage e documentazione.
Diteci dove volete essere tra dodici mesi. Vi risponderemo con un piano per arrivarci.
Risposta entro 1 giorno lavorativo. NDA su richiesta.
Condividete alcuni dettagli e un consulente senior risponderà entro un giorno lavorativo.
Email: sales@yusmpgroup.com
Telefono: +374 44 871 811
Uffici: KAMAR Business Center, Vazgen Sargsyan St. 2, Erevan, Armenia · Remoto — sovrapposizione con la costa est degli Stati Uniti (9:00–13:00 ET)