Structure de projet évolutive
Sans une organisation délibérée en couches staging → intermediate → marts, les projets dbt prolifèrent en des centaines de modèles interdépendants que personne ne peut naviguer ni refactoriser en toute sécurité.
Nous construisons la couche de transformation de votre stack de données moderne avec dbt — transformant les tables brutes de votre entrepôt en produits de données gouvernés, testés et documentés. Nos analytics engineers accompagnent les équipes de données américaines et européennes qui ont besoin de marts fiables, d'un lignage clair et d'exécutions rapides et économes. Des projets dbt from scratch aux projets SQL enchevêtrés à sauver, nous livrons des modèles maintenables que les analystes et les parties prenantes font confiance.
Nous construisons la couche de transformation de votre stack de données moderne avec dbt — transformant les tables brutes de votre entrepôt en produits de données gouvernés, testés et documentés. Nos analytics engineers accompagnent les équipes de données américaines et européennes qui ont besoin de marts fiables, d'un lignage clair et d'exécutions rapides et économes. Des projets dbt from scratch aux projets SQL enchevêtrés à sauver, nous livrons des modèles maintenables que les analystes et les parties prenantes font confiance.
Sans une organisation délibérée en couches staging → intermediate → marts, les projets dbt prolifèrent en des centaines de modèles interdépendants que personne ne peut naviguer ni refactoriser en toute sécurité.
Les exécutions naïves en rafraîchissement complet retraitent tout l'historique à chaque build, gaspillant des crédits d'entrepôt ; choisir la bonne stratégie incrémentielle et gérer les données arrivant en retard est véritablement complexe.
Les modèles non testés cassent silencieusement les tableaux de bord en aval ; les équipes peinent à décider quoi tester, où et avec quelle rigueur, sans ralentir chaque exécution à l'excès.
Un Jinja trop sophistiqué et un SQL copié-collé violent le principe DRY et deviennent illisibles ; sous-utiliser les macros laisse la logique dupliquée dans des dizaines de modèles.
Exécuter et tester uniquement ce qui a changé (slim CI) dans des environnements éphémères ou isolés est non trivial ; sans cela, chaque pull request risque de mettre en péril l'ensemble de l'entrepôt.
À mesure que les modèles se multiplient, le lignage devient flou, la documentation se dégrade et personne ne possède un mart donné — rendant l'analyse d'impact et la confiance impossibles.
Nous structurons les projets en couches staging, intermediate et mart avec des conventions de nommage, de sources et de dossiers cohérentes, afin que le projet reste lisible à mesure qu'il grandit.
Nous implémentons les bonnes matérialisations et stratégies incrémentielles (merge, insert-overwrite, microbatch), gérons les données tardives et la politique de rafraîchissement complet, et réduisons les dépenses d'entrepôt.
Nous ajoutons des tests génériques et singuliers, des contrats de schéma, des vérifications de fraîcheur et des packages afin que les échecs remontent en CI — et non dans le tableau de bord d'une partie prenante.
Nous extrayons la logique partagée dans des macros bien documentées et adoptons des packages éprouvés (dbt_utils, codegen, dbt_expectations) pour garder la base de code DRY et cohérente.
Nous mettons en place le slim CI sur les pull requests, séparons les cibles dev/CI/prod et automatisons les builds afin que seuls les modèles modifiés et leurs descendants s'exécutent et soient testés avant la fusion.
Nous générons la documentation dbt avec un lignage complet, ajoutons des descriptions, des exposures et des métadonnées de propriété, et définissons un modèle de gouvernance sur lequel toute votre équipe peut s'appuyer.
RGPD · qualité des données testée · lignage/gouvernance · SOC 2
Hub unifié de l'écosystème crypto agrégeant plusieurs tokens — données de change en direct, recherche, graphiques, point d'entrée d'achat direct.
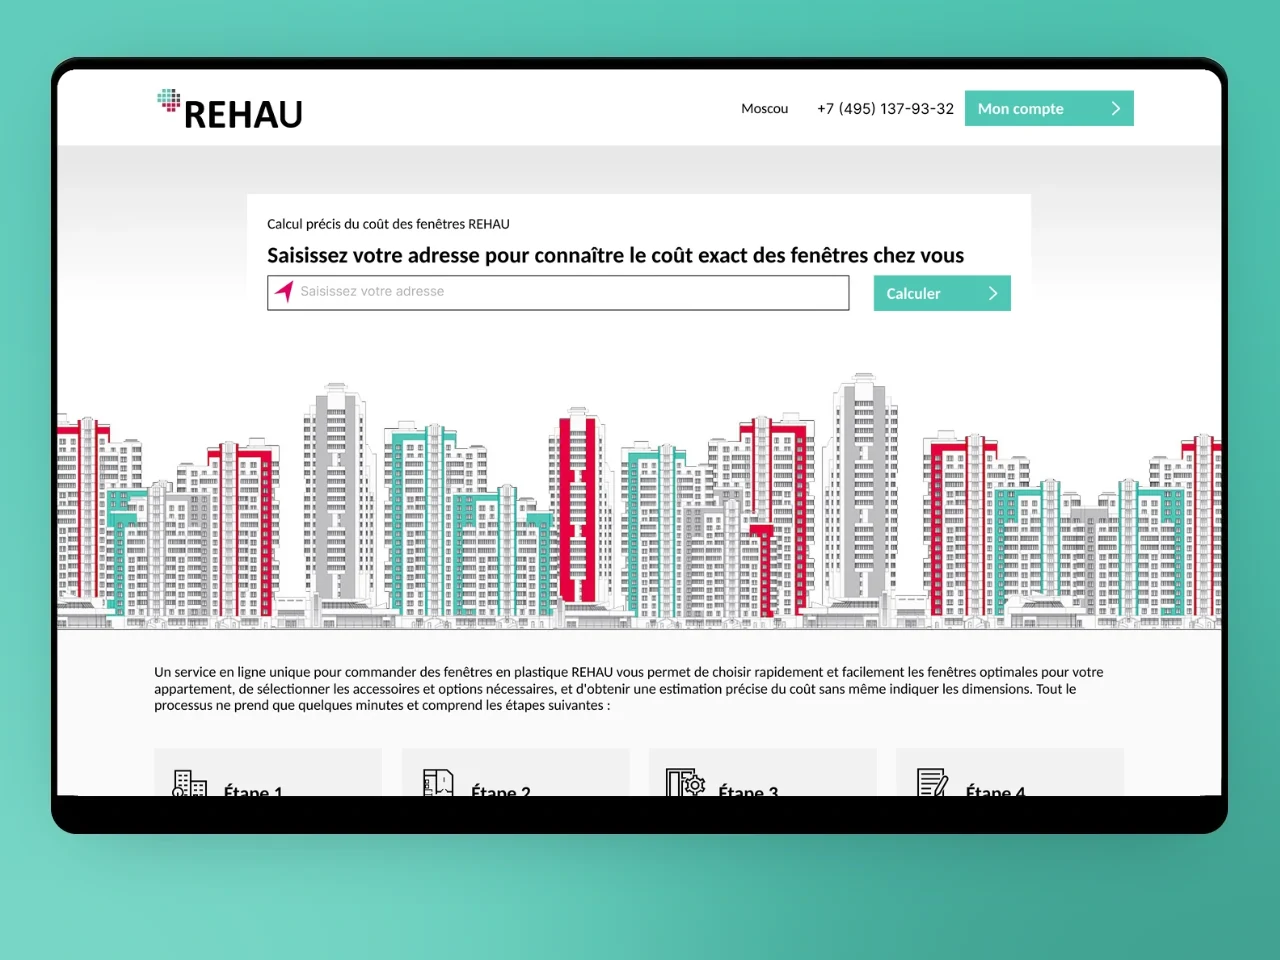
E-commerce B2B et configurateur de produits pour un fabricant mondial de polymères avec des prix multi-régions, des stocks et des workflows revendeurs.
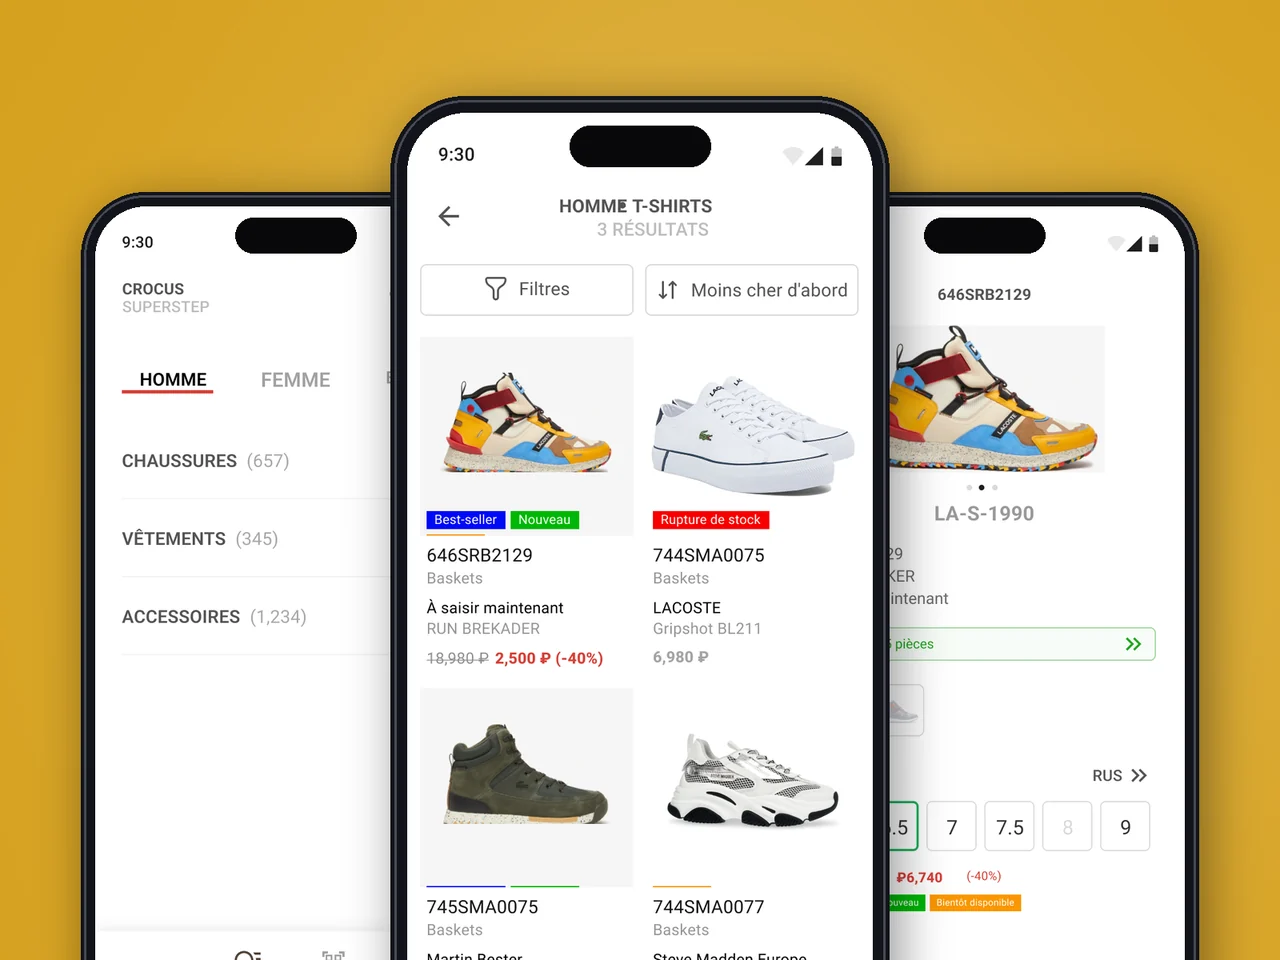
Application POS pour une chaîne de boutiques multi-marques — recherche d'inventaire cross-magasins via ElasticSearch, intégration système 1C.
Agréger les prix en direct sur plusieurs plateformes d'échange tout en maintenant une latence sous 500 ms relève d'une ingénierie réellement ardue. YuSMP a réuni le flux multi-plateformes, les graphiques de tokens en temps réel et le workflow de listing dans une plateforme cohérente. Nous n'avons connu aucune interruption depuis le lancement.
Nos conseillers perdaient 15 minutes par client sur des vérifications de stock manuelles. YuSMP a construit des applications natives adossées à ElasticSearch, connectées à notre système 1C en temps réel. Le temps par client a chuté de 40 % sur tous les points de vente en une semaine après le lancement.
Le commerce B2B pour une marque de produits en polymère implique des configurateurs de produits complexes, des paliers de prix pour les revendeurs et des flux de commande que des acheteurs non techniques doivent maîtriser. YuSMP a construit une plateforme que nos revendeurs ont adoptée sans une seule session de formation. Les volumes de commandes via le portail ont doublé la première année.
Un moteur de décision de crédit qui approuve dix fois plus vite n'arrive pas par hasard. YuSMP a construit le pipeline de scoring, l'intégration aux bureaux de crédit et un back-office que nos analystes prennent réellement plaisir à utiliser. Le délai d'approbation est passé de deux jours à moins de quatre heures.
1 / 4
Nous savons que dbt gère le T de l'ELT — il transforme les données déjà présentes dans votre entrepôt, ce n'est ni un outil d'ingestion ni un orchestrateur — et nous concevons des pipelines adaptés à la réalité.
Chaque modèle que nous livrons est accompagné de tests, d'une documentation et d'un lignage, afin que les analystes, les dirigeants et les systèmes en aval puissent se fier aux chiffres.
Snowflake, BigQuery, Databricks ou Redshift — nous ajustons les matérialisations, les coûts et les spécificités des adaptateurs à votre plateforme plutôt qu'à un modèle universel.
FAQ
dbt (data build tool) gère l'étape de transformation dans l'ELT. Une fois les données brutes chargées dans votre entrepôt, dbt exécute des modèles SQL pour les nettoyer, les joindre et les agréger en tables et vues prêtes pour l'analyse. Il n'ingère pas de données et n'est pas un orchestrateur — il transforme les données qui résident déjà dans l'entrepôt.
dbt Core est l'outil en ligne de commande gratuit et open source que vous exécutez vous-même dans votre propre infrastructure ou CI. dbt Cloud est le produit commercial hébergé qui ajoute un planificateur géré, un IDE, des intégrations CI et une couche de documentation/métadonnées hébergée. Nous travaillons avec les deux et vous aidons à choisir en fonction de la taille de l'équipe, des besoins de gouvernance et du budget.
Les modèles incrémentiels ne construisent que les lignes nouvelles ou modifiées à chaque exécution, au lieu de reconstruire l'intégralité de la table. Ils réduisent considérablement les coûts d'entrepôt et le temps d'exécution sur les jeux de données volumineux à ajouts fréquents. Ils ajoutent de la complexité autour des données arrivant en retard et des rafraîchissements complets ; nous les appliquons donc là où le volume le justifie et conservons les modèles plus petits sous forme de simples matérialisations de tables ou de vues.
dbt vous permet de déclarer des tests — des tests génériques tels que not-null, unique et relationships, ainsi que des tests singuliers personnalisés — qui s'exécutent à chaque build. Combinés aux vérifications de fraîcheur des sources et aux packages comme dbt_expectations, ils détectent les mauvaises données avant qu'elles n'atteignent les tableaux de bord. Nous concevons une suite de tests rigoureuse sans ralentir excessivement les exécutions.
L'entrepôt (Snowflake, BigQuery, etc.) stocke et calcule les données ; dbt définit et exécute les transformations SQL en son sein ; un orchestrateur comme Airflow planifie et déclenche les exécutions dbt en parallèle avec l'ingestion et d'autres tâches. dbt ne planifie pas lui-même les pipelines — il est invoqué par un orchestrateur ou par le planificateur de dbt Cloud.
dbt prend en charge tous les principaux entrepôts cloud via des adaptateurs, notamment Snowflake, Google BigQuery, Databricks, Amazon Redshift, Postgres et d'autres. Nous ajustons les matérialisations, les performances et les coûts à votre plateforme spécifique, car chaque adaptateur possède son propre dialecte SQL et ses propres leviers d'optimisation.
Pour un petit jeu de données avec une ou deux tables simples et aucune logique de transformation réelle, quelques vues SQL ou un script léger peuvent suffire — la structure de projet, les tests et le CI de dbt ajoutent une charge dont vous n'avez peut-être pas encore besoin. dbt devient rentable dès lors que vous avez plusieurs modèles, plusieurs contributeurs, des problèmes de qualité récurrents ou un besoin de lignage et de documentation.
Dites-nous où vous voulez être dans douze mois. Nous reviendrons vers vous avec un plan pour y parvenir.
Réponse sous 1 jour ouvrable. NDA sur demande.
Partagez quelques détails et un consultant senior vous répondra dans un délai d'un jour ouvrable.
E-mail : sales@yusmpgroup.com
Téléphone : +374 44 871 811
Bureaux : KAMAR Business Center, Vazgen Sargsyan St. 2, Erevan, Arménie · À distance — chevauchement avec la côte est des États-Unis (9h–13h ET)