PoC / Pilot
ab $2.900
4–6 Wochen · ein Use Case
Ein abgegrenzter Proof of Concept auf Ihren echten Daten: ein Use Case, ein funktionierender End-to-End-Prototyp, ein Eval-Set und ein schriftliches Go/No-Go mit Kostenprognose.
Angebot anfordernYuSMP Group baut produktionsreife GenAI-Anwendungen, RAG-Systeme, KI-Agenten und die Datenpipelines, die sie speisen — als schlanke, festumfängliche Stufen, nicht als sechsstelliges Enterprise-Engagement. Ein PoC / Pilot ab $2.900 in 4–6 Wochen, RAG über Ihre Wissensbasis ab $8.100, ein autonomer KI-Agent ab $10.400, ein ML-Modell in Produktion ab $13.800. 80+ Senior-Entwickler in Jerewan liefern im MEZ-Arbeitstag mit Überlappung mit der US-Ostküste, mit einem modell-anbieterneutralen Stack über OpenAI, Anthropic und Bedrock. Festpreis, All-in-USD-Preise, IP am ersten Tag an Sie übertragen, DSGVO-konform und ab Tag eins für den EU AI Act vorbereitet — nicht nachträglich angepasst.
Modell-anbieterneutral · DSGVO-konform · ISO 27001 ready · SOC 2 Type II in Vorbereitung · HIPAA-fähig · EU AI Act & NIST AI RMF bewusst · MEZ-Arbeitstag mit 9–13 Uhr ET Überlappung
Wir liefern einen zusammenhängenden Scope: GenAI-Anwendungen, Retrieval-Augmented Generation, mehrstufige KI-Agenten, klassisches Machine Learning, das Data Engineering, das alles vertrauenswürdig macht, und die MLOps, die es am Laufen halten. Unsere Teams bleiben modell-anbieterneutral — Anthropic, OpenAI, Open-Weight via Bedrock oder Self-Hosted — und wählen den Stack nach Ihren Anforderungen an Datenresidenz, Latenz und Kosten. Governance ist eingebaut: DSGVO, ISO 27001 Controls, SOC 2 Type II in Vorbereitung, HIPAA-fähige Auslieferung und ein EU-AI-Act-Risikoklassifizierungsschritt in jedem Engagement. Praxisbeispiel in unserer ARIA-Fallstudie.
Copilots, Suche, Zusammenfassung und Dokumenten-Workflows mit messbaren KPIs. Wir liefern Features, die Kennzahlen bewegen — keine Demos, die im Pilot stecken bleiben.
Hybrid-Retrieval, Reranking, Evaluation und Observability. Wir tunen auf Ihren Daten, Ihren Queries und Ihren Abnahmekriterien — nicht auf Spielzeug-Benchmarks.
Reproduzierbares Training, Model Registries, Shadow Deployments und Monitoring für Drift und Bias. Jedes Modell hat einen klaren Pfad vom Notebook in die Produktion.
Moderner Data Stack auf Snowflake, BigQuery oder Databricks. ELT mit dbt, Datenverträge zwischen Teams und Lineage, dem Ihre Wirtschaftsprüfer und Analysten vertrauen.
Risikoklassifizierung, Transparenzhinweise, technische Dokumentation und menschliche Aufsicht ins Produkt eingebaut — nicht vor einem Audit nachgerüstet. Staatliche US-Gesetze berücksichtigt (Colorado AI Act 2026, NYC AEDT, CCPA ADM-Regeln).
Golden-Datasets, automatisierte Regressionen und Offline-Evals bei jeder Prompt- und Modelländerung. Qualität ist eine Zahl, kein Gefühl.
Sie brauchen ein fokussiertes Engagement statt eines End-to-End-Builds? Jede Fähigkeit unten ist ein eigener YuSMP-Service mit eigenem Senior-Team, Delivery-Playbook und US- & EU-Compliance-Posture. Noch unklar, welcher KI-Use-Case sich lohnt? Starten Sie mit unserem AI Consulting (Seite auf Englisch): Readiness-Audit, priorisierte Roadmap und PoC vor dem Build.
Binden Sie GenAI in Ihr bestehendes Produkt ein — Copilots, Zusammenfassung und Content-Workflows auf einem modell-neutralen Stack.
Hybrid-Retrieval, Reranking und Evaluation über Ihre eigene Wissensbasis, mit Observability und Guardrails.
Mehrstufige Agenten, die Aktionen über Ihre Tools ausführen, mit Human-in-the-Loop auf risikoreichen Pfaden.
Detektions-, Klassifikations- und OCR-Pipelines für Industrie- und Produktteams, trainiert und überwacht auf Ihren Daten.
Fine-Tuning, Evals und die MLOps, um Modelle auszuliefern und zu überwachen, wenn RAG allein Ihre Kosten- oder Latenzziele nicht erreicht.
Risikoklassifizierung, technische Dokumentation und Human-Oversight-Design, damit Ihre KI audit-bereit in der EU ausgeliefert wird.
Wir bewerten Anwendungsfälle nach Geschäftsnutzen, Datenreife und dualer Risikoklassifizierung — EU-AI-Act-Risikoklasse plus NIST AI RMF Govern/Map/Measure/Manage-Profil — und wählen die zwei oder drei mit dem stärksten Hebel aus.
Referenzarchitektur, Evaluations-Harness, Datenpipelines und Human-in-the-Loop-Grenzen werden entworfen, bevor ein Modell ins Produkt verkabelt wird.
Zweiwöchige Sprints mit Offline-Evals, A/B-Tests an echten Nutzern, Prompt- und Modellversionierung sowie Observability für Kosten, Latenz und Qualität.
Drift-, Bias- und Kosten-Dashboards, geplante Re-Evaluationen und ein Backlog, der an Modell- und Regulierungsänderungen in der EU (AI Act), den USA (NIST AI RMF, staatliche Gesetze) und bei den großen Anbietern gekoppelt ist.
Für abgegrenzte KI-Proofs-of-Value, RAG-Piloten und Datenplattform-Builds mit klaren Abnahmekriterien und festem Termin.
Für sich entwickelnde KI-Produkte, in denen Prompts, Modelle und Kennzahlen wöchentlich wechseln. Senior-Squad, wöchentliche Demos, monatliche Kapazitäts-Reviews.
Eine langfristige KI- und Data-Squad, eingebettet in Ihre Produktorganisation. Verantwortet Datenqualität, Modell-Lifecycle und Compliance-Dokumentation.
Die meisten Anbieter behalten die Zahl für ein Verkaufsgespräch. Hier sind unsere schlanken, festumfänglichen Stufen, damit Sie schon vor der Discovery budgetieren können. Alles ist all-in, in USD kalkuliert, mit IP am ersten Tag an Sie übertragen, kein Recruiting-Aufschlag, keine Tool-Gebühren und keine versteckten Kosten. Sie sehen das Budget nach Positionen, bevor Code geschrieben wird, und geben es frei. Cloud- und GPU-Kosten laufen auf euren eigenen Konten, sodass Sie den Kostenhebel behalten.
PoC / Pilot
ab $2.900
4–6 Wochen · ein Use Case
Ein abgegrenzter Proof of Concept auf Ihren echten Daten: ein Use Case, ein funktionierender End-to-End-Prototyp, ein Eval-Set und ein schriftliches Go/No-Go mit Kostenprognose.
Angebot anfordernRAG über Ihre Wissensbasis
ab $8.100
auf Ihrem Korpus
Retrieval-Augmented Generation auf Ihrer eigenen Wissensbasis: Ingestion und Chunking, Hybrid-Retrieval und Reranking, ein Eval-Harness in CI, Guardrails und Observability.
Angebot anfordernKI-Agent (autonom)
ab $10.400
mehrstufig, tool-nutzend
Ein mehrstufiger Agent, der Aktionen über Ihre Tools ausführt, mit Human-in-the-Loop auf risikoreichen Pfaden, deterministischen Evals, Output-Filtern und einem Runbook, das Ihr Team besitzt.
Angebot anfordernML-Modell in Produktion
ab $13.800
Notebook bis Serving
Ein individuelles ML-Modell in Produktion ausgeliefert: Datenpipelines, Training und Ablations, MLOps mit Drift- und Bias-Monitoring und ein dokumentierter Pfad vom Notebook bis zum Serving.
Angebot anfordernWas die Zahl bewegt: wie viele Use Cases Sie ausliefern und wie tief jeder RAG-Korpus reicht; die Eval-Set-Größe, die nötig ist, um Outputs zu vertrauen; Latenzziele (p95 unter 500 ms erzwingt Modell- und Infra-Entscheidungen); und der Compliance-Scope — DSGVO ist standardmäßig im Scope, aber HIPAA-fähige Datenflüsse, EU-only-Residenz oder Zero-Retention-Anbieterverträge bringen zusätzliche Kontrollarbeit. GPU, Drittanbieter-Tooling und Cloud-Ausgaben laufen auf euren eigenen Konten. Alles außerhalb des unterzeichneten Scopes kommt mit dimensionierten Schätzungen auf eine Roadmap statt in eine stille Terminverlängerung. Preise sind indikativ und werden in einem schriftlichen Angebot für Ihren konkreten Scope fixiert.
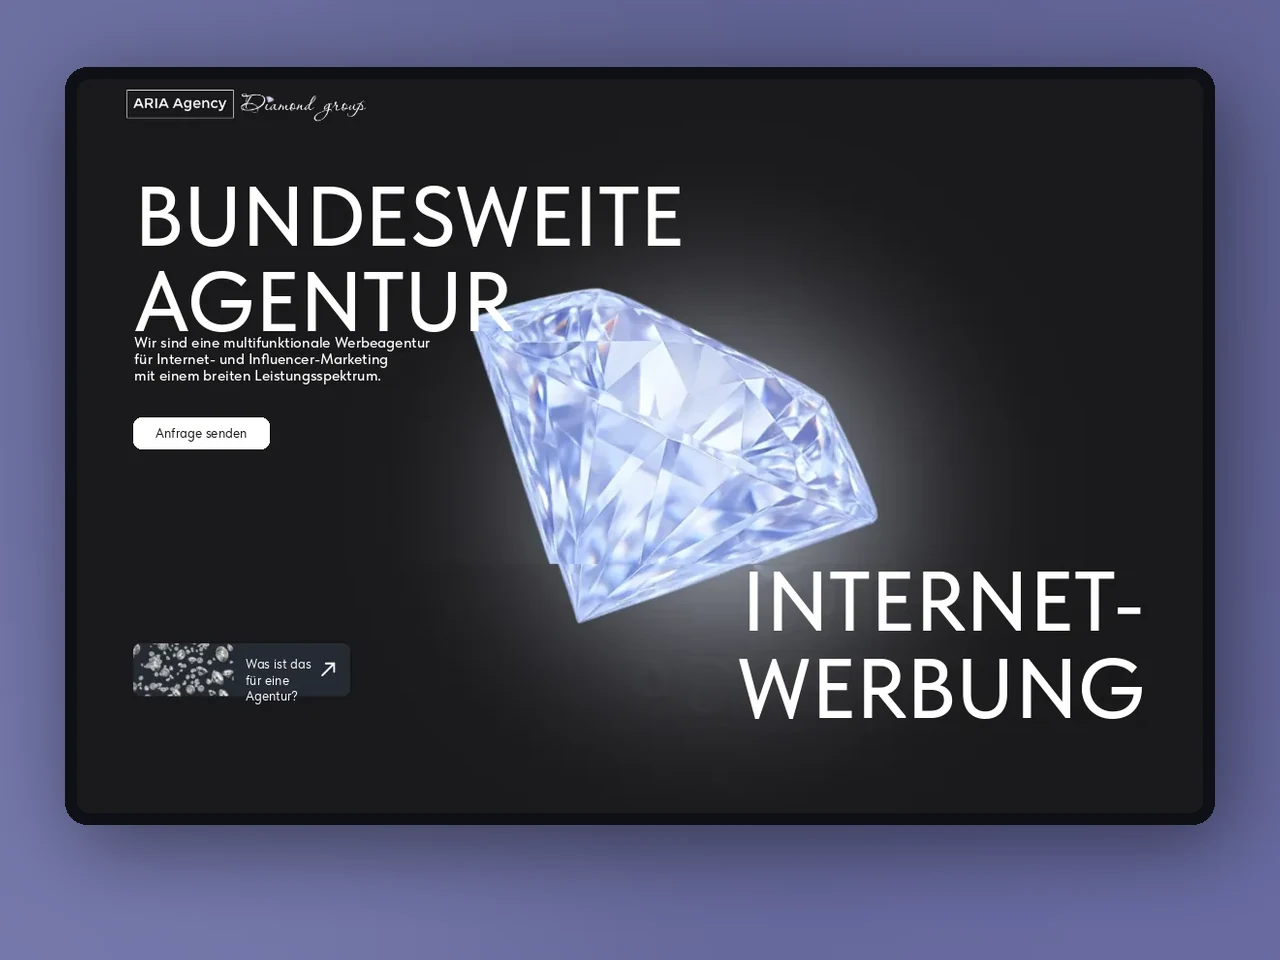
Einseitige Tilda-Landingpage mit Telegram-Bot-Lead-Erfassung für eine Werbeagentur — in zwei Wochen ausgeliefert, für USA und EU bereit.
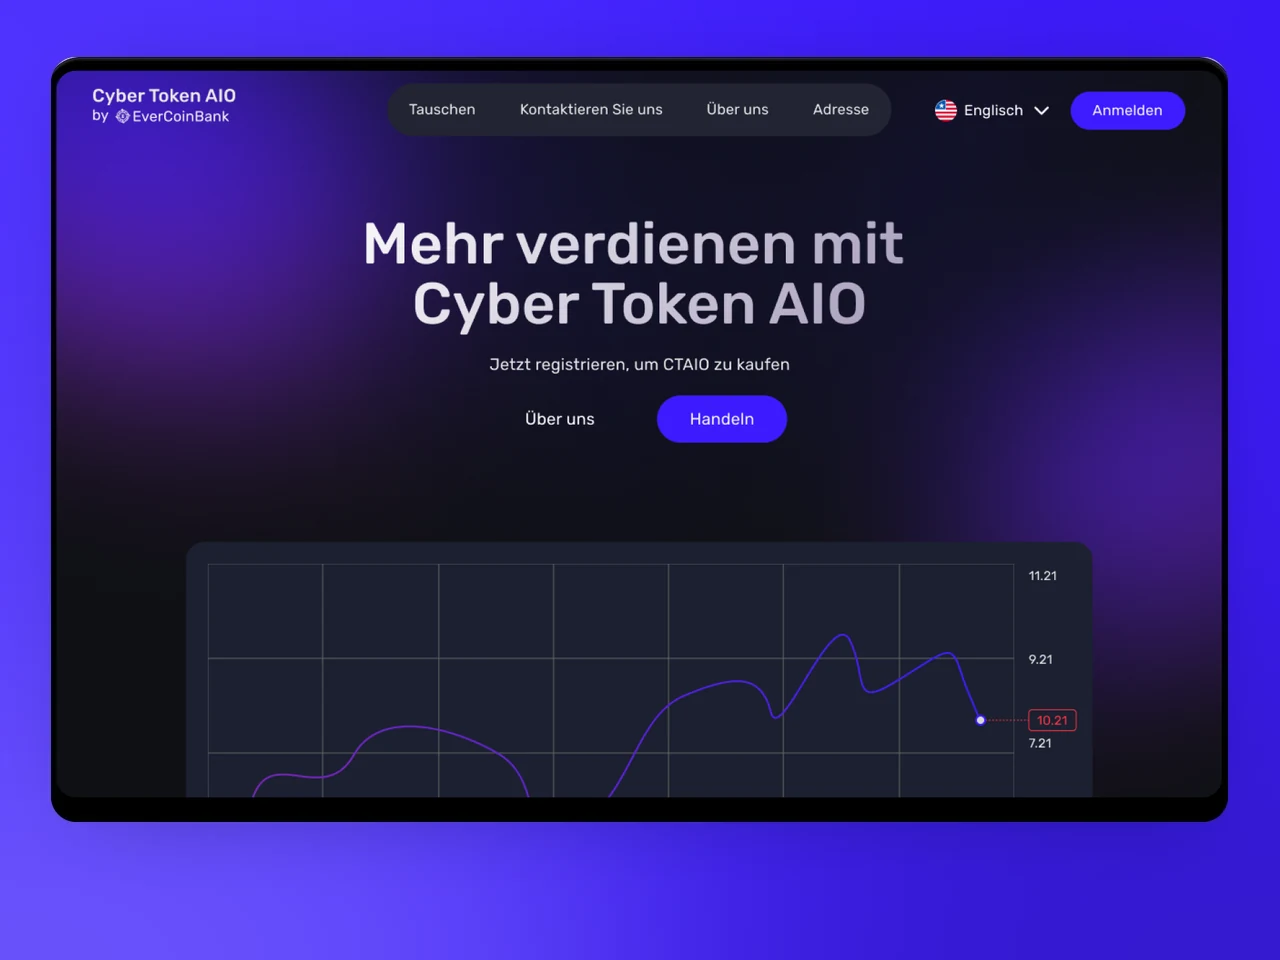
Vollständiger ERC-20-Token-Launch — Solidity-Vertrag, Sicherheitsaudit, Börsenlistings, MetaMask-Checkout auf der Projektseite.
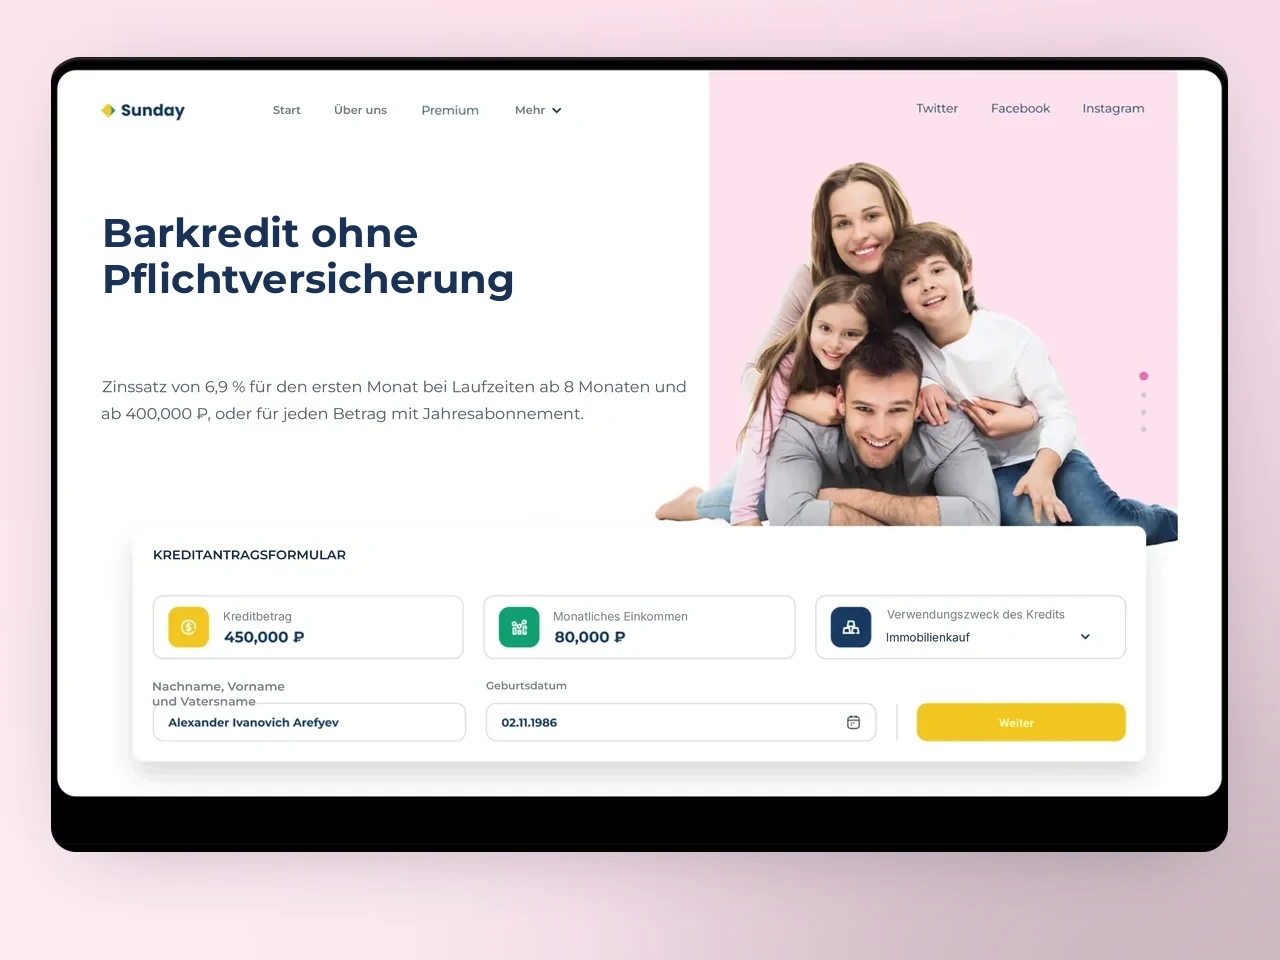
Hochdurchsatz-Kreditentscheidungs-Engine auf Laravel — automatisiertes Scoring, Kreditbüro-Integration und 10-fach schnellere Entscheidungen für US- und EU-Kreditgeber.
KI ist nur nützlich, wenn sie die Daten-, Latenz- und Regulierungsrealität Ihrer Branche respektiert. Wir kombinieren ML und Data Engineering mit branchenspezifischer Compliance über US- & EU-Märkte.
Scoring-, Fraud-Signal- und Dokumentenverarbeitungs-Modelle mit auditierbaren Entscheidungen und PCI-DSS-scoped Datenflüssen.
HIPAA-fähiges, DSGVO-konformes ML auf klinischen und Patientendaten, mit dokumentierten Datenflüssen und BAAs.
Such-, Empfehlungs- und Nachfrageprognose-Modelle plus die Datenplattformen, die sie speisen.
Routing-, ETA- und Dispatch-Modelle auf Echtzeit-Event-Pipelines mit Daten von Drittanbieter-Carriern.
DSGVO-konform · ISO-27001-bereit · SOC 2 Type II in Vorbereitung · HIPAA-fähig · CCPA-berücksichtigt
Data Engineers und ML Leads im MEZ-Arbeitstag mit Überlappung mit der US-Ostküste (9–13 Uhr ET), in Ihren Standups, mit Same-Day-Entscheidungen zu Prompts, Modellen und Rollouts.
ML-Engineers und Data-Platform-Leads mit ausgelieferten produktiven Systemen für US- und EU-Kunden. Wir lernen keine Vektor-Datenbanken auf Ihrer Roadmap.
Region-gebundene Endpunkte (EU-Datenresidenz · US-Optionen auf Anfrage), Zero-Retention-Konfigurationen, unterzeichnete AVV und BAAs, ISO-27001-orientierte Controls mit SOC 2 Type II in Vorbereitung. PCI-DSS-Scoping, wo ML Zahlungen berührt; HIPAA-fähig, wo ML PHI berührt.
Duale KI-Governance ist Teil jeder Architekturentscheidung: In der EU wenden wir den AI Act an (Risikoklasse pro Anwendungsfall, Systemdokumentation, menschliche Aufsicht, Evidenz für Hochrisiko-Szenarien wie Recruiting, Kreditbewertung und biometrische Verarbeitung); in den USA wenden wir die föderalen KI-Exekutivverordnungen, NIST AI RMF (Govern / Map / Measure / Manage), OMB M-24-10-Erwartungen und staatliche Gesetze an — Colorado AI Act (wirksam 2026), NYC AEDT (Local Law 144), NY AI Bill of Rights und CCPA/CPRA-Regeln zur automatisierten Entscheidungsfindung.
Eine Kreditentscheidungs-Engine, die zehnmal schneller genehmigt, entsteht nicht zufällig. YuSMP entwickelte die Scoring-Pipeline, die Integration mit Kreditbüros und ein Back-Office, das unsere Underwriter gerne nutzen. Die Genehmigungszeit sank von zwei Tagen auf unter vier Stunden.
Live-Preise über mehrere Börsen zu aggregieren und dabei die Latenz unter 500 ms zu halten ist wirklich hartes Engineering. YuSMP entwickelte den Multi-Exchange-Feed, Echtzeit-Token-Charts und den Listing-Workflow zu einer kohärenten Plattform. Wir hatten seit dem Launch keinen einzigen Ausfall.
1 / 2
Die richtige Entscheidung zur KI-Infrastruktur hängt von der Sensibilität Ihrer Daten, dem Abfragevolumen, den Latenzanforderungen und der organisatorischen Fähigkeit ab, KI-Systeme im Produktivbetrieb zu steuern.
Die GPT-4-API ist die richtige Wahl für allgemeine Aufgaben, bei denen domänenspezifische Genauigkeit nicht entscheidend ist, die Time-to-Market oberste Priorität hat und die Kosten pro Abfrage bei Ihrem erwarteten Volumen vertretbar sind.
Das Fine-Tuning von Open-Source-Modellen (Llama 3 70B, Mistral 7B) wird wirtschaftlich sinnvoll, sobald Sie mehr als 1 Million Tokens pro Tag verarbeiten (API-Kosten übersteigen die GPU-Hosting-Kosten), eine Inferenzlatenz unter 500 ms benötigen, Daten aus Compliance-Gründen On-Premise bleiben müssen, oder ein konsistentes Ausgabeformat benötigen, das Prompt Engineering allein nicht zuverlässig liefert.
Parameter-effiziente Fine-Tuning-Techniken wie LoRA und QLoRA reduzieren den GPU-Speicher- und Trainingszeitbedarf für das Fine-Tuning großer Modelle um 80–90 %, wodurch Fine-Tuning auf einzelnen A100-GPUs oder Cloud-Spot-Instanzen zugänglich wird. Wir entwerfen Fine-Tuning-Pipelines, kuratieren domänenspezifische Trainingsdatensätze und führen systematische Benchmark-Evaluierungen durch, die das fein abgestimmte Modell mit der GPT-4-Baseline für Ihre konkrete Aufgabe vergleichen, bevor wir die Infrastrukturinvestition empfehlen.
Open-Source-LLMs (Llama 3, Mistral, Falcon, Qwen) geben Ihnen vollständige Kontrolle über die Datenverarbeitung, ermöglichen Offline- und Air-Gapped-Deployments, eliminieren API-Kosten pro Token im großen Maßstab und können ohne Herstellergenehmigung angepasst werden.
Proprietäre Modelle (GPT-4, Claude, Gemini Ultra) bieten State-of-the-Art-Leistung bei komplexen Reasoning-Aufgaben, erfordern kein Infrastrukturmanagement und ermöglichen eine schnellere Pilot-Time-to-Market.
Die Entscheidung hängt von Ihren Anforderungen an die Datensensibilität, dem Inferenzvolumen, den Leistungsbenchmarks für Ihre konkreten Aufgaben und der organisatorischen KI-Fähigkeit ab. Für das Gesundheitswesen und Finanzdienstleistungen mit strikten Anforderungen an die Datenresidenz sind auf privater Infrastruktur bereitgestellte Open-Source-Modelle oft zwingend. Für Produktteams, die KI-gestützte Funktionen schnell bauen, sind proprietäre APIs mit starken Rate-Limits und konsistenter Leistung meist der pragmatische Einstiegspunkt.
Cloud-GPU-Inferenz (AWS SageMaker, GCP Vertex AI, Azure ML) ist optimal für variable Workloads, Pilotprojekte und Teams ohne Erfahrung im Management von GPU-Clustern, mit Kosten von 2–8 $/Stunde pro A100-GPU.
On-Premises-Inferenz wird wirtschaftlich, wenn die GPU-Auslastung dauerhaft über 60 % liegt, wenn regulatorische Anforderungen das Senden von Daten an Cloud-Anbieter verbieten, oder wenn Latenzziele für die Inferenz über Cloud-API-Round-Trips nicht erreicht werden können.
Wir analysieren Ihr Workload-Profil, Ihre Anforderungen an die Datenresidenz und die Kostenprognose über 3 Jahre, um die richtige Infrastrukturstrategie zu empfehlen. Für die meisten Enterprise-KI-Anwendungen balanciert ein hybrider Ansatz — Cloud-GPUs für Modelltraining und Batch-Inferenz, On-Prem oder dedizierte Cloud-Instanzen für Echtzeit-Serving von Produktionsmodellen — Kosteneffizienz mit Latenzanforderungen und regulatorischer Compliance aus.
Engagements sind festumfänglich und schlank, all-in und in USD kalkuliert. Ein PoC / Pilot ab $2.900 (4–6 Wochen); RAG über Ihre Wissensbasis ab $8.100; ein autonomer KI-Agent ab $10.400; ein ML-Modell in Produktion ab $13.800. Die genaue Zahl hängt davon ab, wie viele Use Cases Sie ausliefern, von Korpustiefe und Eval-Set-Größe, Latenzzielen und Compliance-Scope. Sie sehen das Budget nach Positionen am Ende der Discovery und geben es frei, bevor Code geschrieben wird. Es gibt kein Recruiting-Aufschlag und keine Tool-Gebühren, und Cloud- und GPU-Kosten laufen auf euren eigenen Konten, sodass Sie den Kostenhebel behalten.
Wir benchmarken Kandidatenmodelle auf Ihren echten Aufgaben, bevor wir empfehlen. Region-gebundenes Mistral / Claude / OpenAI auf Bedrock, Vertex oder Azure OpenAI (EU-gehostet für EU-Kunden, US-gehostet für US-Kunden) sowie Open-Source-Modelle auf EU- oder US-Clustern schlagen häufig die naheliegende Wahl bei Kosten und Datenresidenz — sobald Sie End-to-End-Latenz und Genauigkeit messen.
Für die meisten wissensgebundenen Anwendungsfälle schlägt Retrieval-Augmented Generation mit starken Evals das Fine-Tuning. Wir wechseln nur dann zu Fine-Tuning oder LoRA, wenn Stil-, Latenz- oder Kostenziele mit RAG nicht erreichbar sind — und wir messen den Mehrwert.
Prompt-Versionierung, deterministische Evals, Red-Team-Prompts, Output-Filter und Human-in-the-Loop auf risikoreichen Pfaden. Jedes Release liefert ein messbares Qualitäts- und Sicherheits-Dashboard — keine Bauchgefühl-Prüfung.
Die meisten SaaS-Produkte setzen KI in begrenzt-risikoreichen oder minimal-risikoreichen Rollen ein und benötigen Transparenzhinweise und Basis-Logging. Wir helfen, Ihre Anwendungsfälle zu klassifizieren, das System zu dokumentieren und auf High-Risk-Pflichten vorzubereiten — falls Recruiting, Kreditbewertung oder Biometrie im Scope sind.
Für US-Deployments ordnen wir Kontrollen dem NIST AI Risk Management Framework (Govern / Map / Measure / Manage) zu, richten uns an den föderalen KI-Exekutivverordnungen und OMB M-24-10-Erwartungen aus und prüfen Anwendungsfälle gegen staatliche Gesetze vorab — den Colorado AI Act (wirksam 2026), NYC AEDT (Local Law 144), den NY AI Bill of Rights und die CCPA/CPRA-Regeln zur automatisierten Entscheidungsfindung. Wir dokumentieren Risikoklasse, Transparenzhinweise, menschliche Aufsicht und Folgenabschätzungen in einer einzigen KI-Systemkarte pro Deployment.
Ja. Wir verwenden region-gebundene Endpunkte von Bedrock, Vertex, Azure OpenAI und Mistral — EU-gehostet für EU-Kunden (EU-Datenresidenz), US-gehostet für US-Kunden (US-Optionen auf Anfrage, BAAs für HIPAA-fähige Workloads verfügbar). Self-Hosted Open-Source-Modelle auf EU- oder US-Clustern, wenn Datenresidenz kritisch ist. AVV, BAAs und Zero-Retention-Konfigurationen sind Teil jedes Architektur-Reviews.
Sagen Sie uns, wo Sie in zwölf Monaten stehen möchten. Wir liefern Ihnen einen Plan, um dorthin zu gelangen.
Praxisnahe Leitfäden und Analysen unserer Ingenieure für 2026.
Teilen Sie uns einige Details mit, und ein Senior-Consultant antwortet innerhalb eines Werktages.
E-Mail: sales@yusmpgroup.com
Telefon: +374 44 871 811
Büros: KAMAR Business Center, Vazgen Sargsyan Str. 2, Yerevan, Armenien · Remote — Überlappung mit der US-Ostküste (9–13 Uhr ET)