PoC
ab 2.900 $
4–6 Wochen · ein Use Case
Use-Case-Bewertung, ROI-Modell, Eval-Set-Design, ein funktionierender Prototyp und ein schriftliches Go/No-Go — bevor Sie sich auf einen Build festlegen.
Angebot anfordernGenerative-KI-Beratung für B2B-Betreiber, die ausgelieferte Systeme brauchen — keine Foliendecks, kein sechsstelliges Enterprise-Engagement, sondern schlanke Festpreis-Stufen. Wir bewerten Use Cases nach Umsatzimpact, wählen das richtige LLM pro Aufgabe auf einem echten Eval-Harness, bauen RAG- und Prompt-Pipelines, die echte Nutzer überstehen, und liefern MLOps, das Ihr Team besitzen kann. Ein PoC ab 2.900 $ in 4–6 Wochen, RAG über Ihre Wissensbasis ab 8.100 $, ein autonomer KI-Agent ab 10.400 $, ein ML-Modell in Produktion ab 13.800 $. Senior-Entwickler mit Erfahrung in produktiven LLM-Workloads im großen Maßstab — keine Prompt-Ingenieure, die Twitter lesen. Fixed-scope, All-in-Preise in USD, IP am ersten Tag an Sie übertragen.
DSGVO-konform · ISO-27001-bereit · SOC 2 Type II in Vorbereitung · HIPAA-fähig · CCPA-berücksichtigt · MEZ-Arbeitstag mit Überlappung 9–13 Uhr ET
Die meisten generativen KI-Projekte scheitern aus denselben drei Gründen. Der falsche Use Case — ein Chatbot, der eine Suchleiste ersetzt, die niemand genutzt hat. Das falsche Eval — „sieht gut aus bei fünf Beispielen" bis Produktionsnutzer das sechste finden. Die falsche Architektur — ein 14-Schritte-LangChain-Agent, wo zwei Funktionsaufrufe ausgereicht hätten. Wir beginnen mit einem schriftlichen ROI-Modell und einem 200-Item-Eval-Set, bevor eine einzige Zeile Orchestrierungscode geschrieben wird. Wir wählen LLM-Anbieter nach gemessener Latenz, Qualität und Kosten pro 1.000 Anfragen bei Ihrem Traffic-Mix — nicht nach dem Demo, das letzte Woche viral ging. Nach Woche 10 verfügen Sie über ein funktionsfähiges System, einen Regressions-Harness, Observability und ein Runbook, das Ihr Team besitzt. Sehen Sie es in der Praxis in unserer ARIA-Fallstudie.
Wir befragen Produkt-, Operations- und Support-Teams und bewerten dann 8 bis 15 Kandidaten-Use-Cases nach Umsatzimpact, Entwicklungskosten, Machbarkeit und Risiko. Sie erhalten eine priorisierte Shortlist, ein schriftliches ROI-Modell für die Top-3 und eine klare „nicht bauen"-Liste mit Begründung.
Eval-gestützte Auswahl über OpenAI, Anthropic, Bedrock und Vertex. Wir messen Qualität, p50/p95-Latenz und Kosten an einem 150 bis 400-Item aufgabenspezifischen Eval-Set. Ergebnis ist ein ADR mit dem gewählten Modell, einem Fallback-Modell und dem Auslöser für eine Neubewertung.
Corpus-Ingestion, Chunking-Strategie kalibriert auf Ihre Dokumentverteilung, Embedding-Modellauswahl, Vector-Store-Dimensionierung, Hybrid-Retrieval. Wir dimensionieren für Ihre tatsächliche Corpus-Wachstumsrate, nicht für eine Standard-100.000-Vektor-Demo.
Versionierte Prompts in Git, Regressions-Eval-Sets in CI, Ragas- und DeepEval-Rubriken, LLM-as-Judge mit menschlicher Stichprobenprüfung. Wir mergen keine Prompt-Änderungen, die eine Tier-1-Metrik verschlechtern — auch unsere eigenen nicht.
PII-Entfernung beim Eingang (Presidio oder Fine-Tuned-Klassifikator), Zero-Retention-Anbieterverträge, EU-Endpoints für EU-Daten, Egress-Scans auf halluzinierte PII. DPAs und Sub-Prozessor-Listen abgestimmt auf Ihre Kundenverträge.
Observability über LangSmith, Langfuse oder Helicone. Anfragebezogene Protokollierung von Prompt-Version, Modell, Tokens, Latenz, Kosten. Kostenalarme, Latenz-SLOs, automatisierte A/B-Prompts und ein schriftliches Runbook für Modell-Upgrades und Anbieterausfälle.
 AnthropicKI / MLBedrockKI / ML
 Vertex AIKI / ML
 LangChainKI / MLLlamaIndexKI / MLPineconeVektor-DBWeaviateVektor-DB
 QdrantVektor-DB
 OpenSearchSuche
 pgvectorVektor-DB
 PhoenixBackend
 MLflowKI / ML
Wochen 1–3: Stakeholder-Interviews, Use-Case-Bewertung, ROI-Modell, Eval-Set-Design. Ergebnis ist eine priorisierte Shortlist plus ein Architekturvorschlag, den Gründer und Board lesen können.
Wochen 4–5: Eval-Harness aufbauen, Kandidatenmodelle am aufgabenspezifischen Set testen, ADR mit gewähltem Modell, Fallback-Modell und Neubewertungsauslöser schreiben. Prompts in Git eingecheckt.
Wochen 6–10: End-to-End-System, RAG oder Agent-Orchestrierung, Observability, PII-Handling, Customer-Zero-Deployment hinter einem Feature-Flag. Regressions-Evals laufen in CI vor jedem Prompt-Merge.
Ab Woche 11: Eval-Set erweitern, Fallbacks hinzufügen, Ihr Team im Runbook schulen, Kosten- und Latenz-SLOs festlegen, erstes vierteljährliches Modell-Upgrade-Review durchführen. Wir ziehen uns zurück, wenn Ihr Team es eigenständig betreibt.
Schlanke Festpreis-Stufen, damit Sie schon vor der Discovery budgetieren können. Alles ist all-in, in USD angegeben, mit IP-Übertragung an Sie am ersten Tag, ohne Recruiting-Aufschlag, ohne Tool-Zuschläge und ohne versteckte Kosten. Sie sehen das Budget mit Einzelposten, bevor Code geschrieben wird, und geben es frei. Cloud- und Token-Kosten laufen auf Ihren eigenen Konten, sodass Sie den Kostenhebel behalten. Wollen Sie die Token-Kosten zuerst abschätzen? Modellieren Sie sie in unserem kostenlosen LLM Spend Calculator. Sie wissen nicht, wie viele Tokens Ihre Prompts verbrauchen? Prüfen Sie es zuerst mit unserem kostenlosen Token-Zähler. Noch unklar, welcher Use Case den Aufwand wert ist? Unser AI Consulting (Seite auf Englisch) bewertet die Kandidaten und plant die Roadmap vorab.
PoC
ab 2.900 $
4–6 Wochen · ein Use Case
Use-Case-Bewertung, ROI-Modell, Eval-Set-Design, ein funktionierender Prototyp und ein schriftliches Go/No-Go — bevor Sie sich auf einen Build festlegen.
Angebot anfordernRAG über Ihre Wissensbasis
ab 8.100 $
verankert auf Ihrem Corpus
RAG- oder Prompt-Pipeline über Ihren eigenen Corpus, Eval-Harness in CI, Observability und PII-Handling — ein Customer-Zero-Deployment, das Ihre Entwickler besitzen.
Angebot anfordernKI-Agent (autonom)
ab 10.400 $
mehrstufig, Tool-nutzend
Ein mehrstufiger Agent, der Aktionen über Ihre Tools ausführt, mit Human-in-the-Loop auf kritischen Pfaden, deterministischen Evals und Output-Filtern.
Angebot anfordernML-Modell in Produktion
ab 13.800 $
vom Notebook zum Serving
Ein individuelles oder fine-getuntes Modell in Produktion: Datenpipelines, Training und Ablationen, MLOps mit Drift-Monitoring.
Angebot anfordernWas die Zahl bewegt: wie viele Use Cases Sie ausliefern und wie tief jeder RAG-Corpus geht; die Größe des Eval-Sets, das nötig ist, um Outputs zu vertrauen (150 bis 400 Items pro Task); Latenzziele, denn p95 unter 500 ms erzwingt Modell- und Infra-Entscheidungen; und der Compliance-Scope — DSGVO-konform, HIPAA-fähig oder Zero-Retention-Anbieterverträge heben die Latte. Ein einzelner verankerter Assistent auf einem stabilen Corpus liegt am unteren Ende; ein Multi-Modell-System, das unter einem DPA in Produktion schreibt, am oberen. Cloud- und Token-Kosten laufen auf Ihren eigenen Konten, sodass Sie den Kostenhebel behalten. Brauchen Sie Modellanpassung statt Integration? Siehe LLM-Fine-Tuning und RAG as a Service.
4–6 Wochen. Ein Use Case, Use-Case-Bewertung und ROI-Modell, ein Eval-Set, ein funktionierender Prototyp und ein schriftliches Go/No-Go mit Kostenprognose. Am besten für Teams, die noch nicht wissen, welche KI-Wette es wert ist. Ab 2.900 $.
Retrieval-Augmented Generation auf Ihrem eigenen Corpus: Ingestion und Chunking, Hybrid-Retrieval und Reranking, Eval-Harness in CI, PII-Handling, Guardrails und Observability. Ab 8.100 $.
Ein mehrstufiger Agent, der Aktionen über Ihre Tools ausführt, mit Human-in-the-Loop auf kritischen Pfaden, deterministischen Evals, Output-Filtern und einem Runbook, das Ihr Team besitzt. Ab 10.400 $.
Ein individuelles oder fine-getuntes Modell in Produktion: Datenpipelines, Training und Ablationen, MLOps mit Drift-Monitoring und ein dokumentierter Weg vom Notebook zum Serving. Ab 13.800 $.
Alle Engagements beginnen mit einem gegenseitigen NDA, IP-Abtretung und einem DPA. Die Preise sind all-in und in USD, mit IP-Übertragung an Sie am ersten Tag, ohne Recruiting-Aufschlag und ohne Tool-Zuschläge. Cloud- und Token-Kosten laufen auf Ihren eigenen Konten, sodass Sie den Kostenhebel behalten.
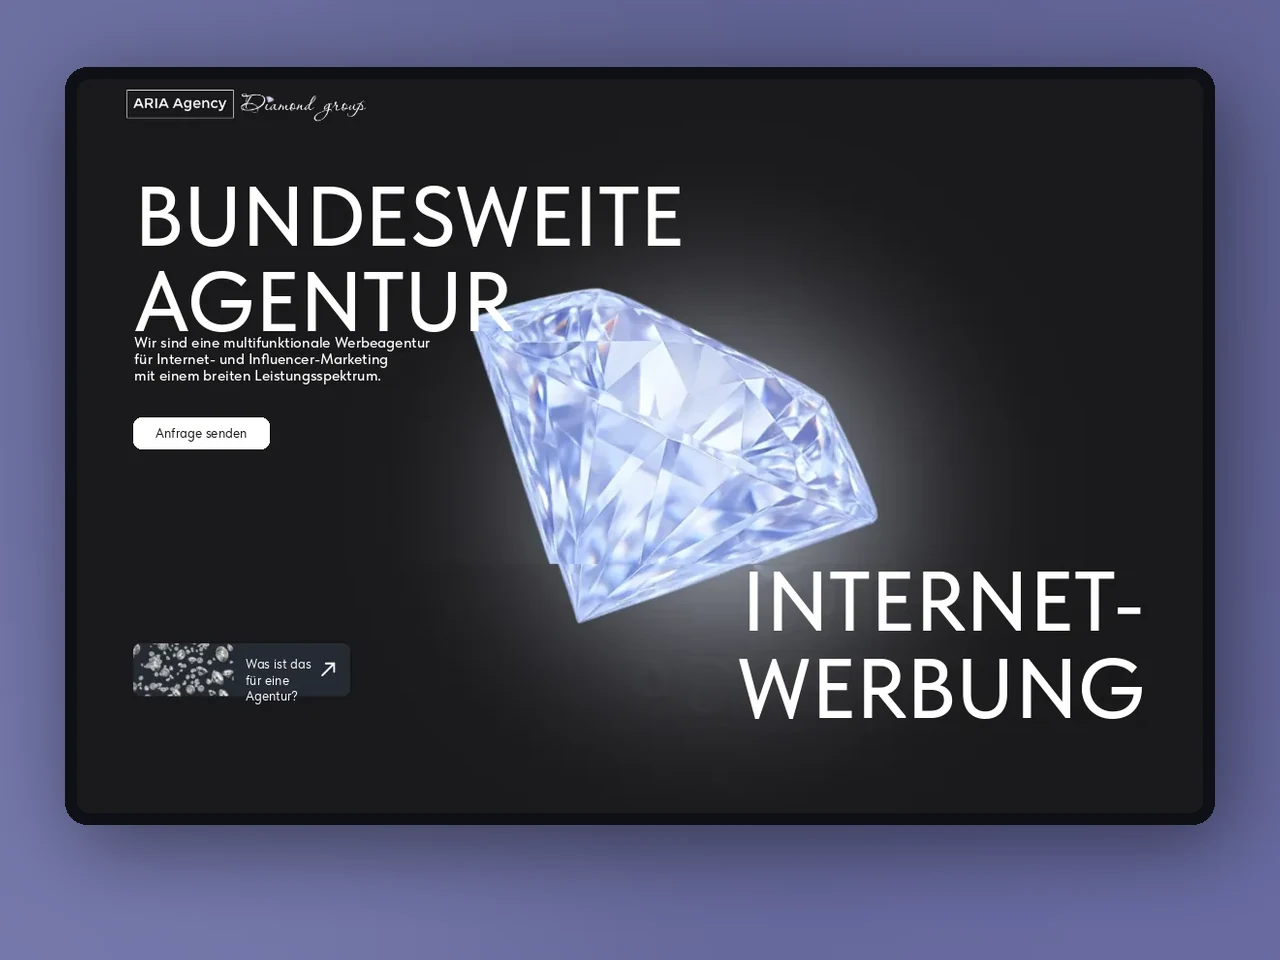
Einseitige Tilda-Landing-Page mit Telegram-Bot-Lead-Capture für eine Werbeagentur — in zwei Wochen ausgeliefert, US- & EU-bereit.
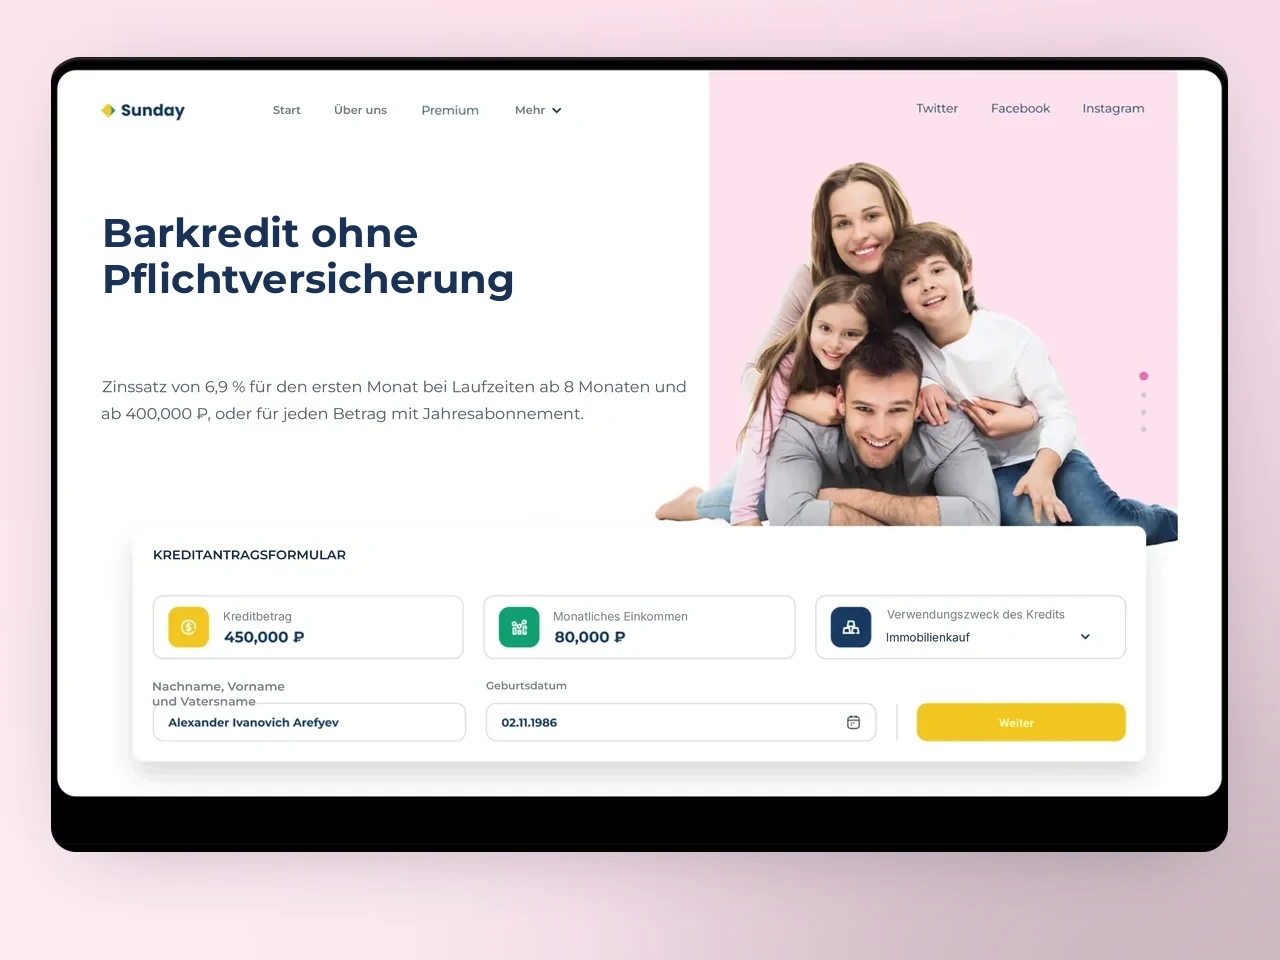
Hochdurchsatz-Kredit-Entscheidungsmaschine auf Laravel — automatisiertes Scoring, Kreditbüro-Integration und 10x schnellere Entscheidungen für Kreditgeber in den USA & der EU.
Ein GenAI-Feature ist nur so sicher wie seine Passung zu Ihrer regulatorischen und operativen Realität. Wir kombinieren LLM-Integration mit branchenspezifischer Compliance über US- & EU-Märkte hinweg und ziehen unsere Schwester-Teams KI, ML & Data, KI-Agenten-Entwicklung und EU-AI-Act-Compliance hinzu, wenn ein Workload sie braucht.
Verankerte Assistenten für Richtlinien- und Vertrags-Q&A, Streitfall-Zusammenfassungen und Analysten-Copiloten — mit PII-Entfernung beim Eingang und Datenhandling im PCI-DSS-Scope.
HIPAA-fähiges, DSGVO-konformes RAG über Akten und Protokolle, Aufnahme-Zusammenfassungen und Care-Ops-Entwürfe — mit dokumentierten Datenflüssen und Egress-Scans auf halluzinierte PII.
Katalog-Anreicherung, Support-Antwort-Generierung und Merchandising-Copiloten, verankert in Ihrem eigenen Produkt-Corpus unter strengen Eval-Gates und Kostenobergrenzen pro Anfrage.
Zusammenfassungen zur Ausnahmebehandlung, Sendungs- und ETA-Q&A und Back-Office-Entwürfe über wechselnden operativen Zustand — mit Zero-Retention-Anbieterverträgen und EU-Endpoints für EU-Daten.
DSGVO-konform · ISO-27001-bereit · SOC 2 Type II in Vorbereitung · HIPAA-fähig · CCPA-berücksichtigt
Jedes Engagement beginnt mit einem 150 bis 400-Item-Eval-Set vor der Architekturentscheidung. Wir liefern keine Prompts, die noch keinen Regressionslauf gesehen haben. Demos sind kein Nachweis.
Unsere LLM-Leads haben produktives ML ausgeliefert, bevor Transformer en vogue waren — Ranking, Klassifikation, Suchrelevanz. Sie diskutieren über Latenzbudgets und Postgres-Abfragepläne, nicht über Twitter-Threads.
DSGVO, SOC 2, HIPAA, CCPA — wir haben Zero-Retention-Verträge mit OpenAI und Anthropic verhandelt, DPAs geschrieben, die Kundenprüfungen standhalten, und Auditoren durch den LLM-Scope geführt.
Wir betrachten die LLM-Anbieterauswahl als vierteljährliche Entscheidung, nicht als Glaubenssache. Wenn sich die Frontier bewegt, sagen es uns Ihre Evals — nicht der Quartalsbericht eines Anbieters.
Eine Kreditentscheidungs-Engine, die zehnmal schneller genehmigt, entsteht nicht zufällig. YuSMP entwickelte die Scoring-Pipeline, die Integration mit Kreditbüros und ein Back-Office, das unsere Underwriter gerne nutzen. Die Genehmigungszeit sank von zwei Tagen auf unter vier Stunden.
Die Anbieterauswahl ist ein Eval-Problem, kein Marketing-Problem. Wir bauen ein aufgabenspezifisches Eval-Set mit 150 bis 400 repräsentativen Inputs und bewerten Kandidatenmodelle nach Qualität (LLM-as-Judge plus menschliche Stichprobenprüfung), Latenz und Kosten pro 1.000 Anfragen. Typisches Lineup: GPT-4o oder Claude 3.7 Sonnet für Reasoning, GPT-4o-mini oder Claude 3.5 Haiku für Klassifikation, gpt-4o-realtime für Voice, ein Open-Weights-Modell auf vLLM für kostenintensive Batch-Verarbeitung. Wir führen das Eval jedes Quartal erneut durch, weil sich die Frontier bewegt.
RAG ist richtig, wenn Antworten in einem Corpus liegen, der sich schneller aktualisiert als Fine-Tuning möglich ist (Richtlinien, Produktdokumentation, Tickets, Verträge). Es ist die falsche Antwort, wenn das Modell die Domäne bereits kennt, wenn die Latenz unter 500 ms p95 liegt oder wenn Sie deterministische Outputs benötigen. Wir kombinieren häufig: RAG für Verankerung, ein kleines Fine-Tuned-Modell für Output-Struktur, Prompt Engineering für Orchestrierung. Reines RAG ist in der Produktion selten. Reines Fine-Tuning noch seltener.
Drei Schichten. Beim Eingang erkennt ein PII-Detektor (Microsoft Presidio oder ein Fine-Tuned-Klassifikator) personenbezogene Daten und entfernt oder tokenisiert diese, bevor der Prompt unsere Infrastruktur verlässt. Beim Anbieter schließen wir Zero-Data-Retention-Verträge ab und bevorzugen EU-gehostete Endpoints für EU-Daten. Beim Ausgang wird der Output auf halluzinierte personenbezogene Daten geprüft. DPAs werden vor Projektstart unterzeichnet.
Prompts sind Code. Sie leben in der Versionskontrolle, werden in Pull Requests geprüft und mit semantischen Versionen getaggt, die bei jeder Inferenz protokolliert werden. Jede Prompt-Änderung wird in CI gegen ein Regressions-Eval-Set geprüft, und wir mergen nicht, wenn eine Tier-1-Metrik um mehr als 2 Prozent zurückgeht. In der Produktion protokollieren wir Prompt-Version, Modell, Latenz und Token-Kosten pro Anfrage über LangSmith, Helicone oder Langfuse.
Ja. Die meisten Engagements integrieren sich in ein bestehendes Backend (Node, Python, Go, Java) und bestehende Infrastruktur (AWS, GCP, Azure). Wir drängen Sie nicht zu einem anbieterspezifischen Orchestrator. Wir arbeiten paarweise mit Ihren Entwicklern und schreiben ADRs für Architekturentscheidungen. Wissenstransfer ist vertraglich vereinbart: Am Ende des Piloten besitzt Ihr Team die Codebasis, die Evals und das Runbook.
Engagements sind fixed-scope und schlank, all-in und in USD angegeben. Ein PoC läuft ab 2.900 $ (4–6 Wochen); RAG über Ihre Wissensbasis ab 8.100 $; ein autonomer KI-Agent ab 10.400 $; ein ML-Modell in Produktion ab 13.800 $. Die genaue Zahl hängt davon ab, wie viele Use Cases Sie ausliefern, von Corpus-Tiefe und Eval-Set-Größe, Latenzzielen und Compliance-Scope. Sie sehen das Budget mit Einzelposten am Ende der Discovery und geben es frei, bevor Code geschrieben wird. Es gibt keinen Recruiting-Aufschlag und keine Tool-Zuschläge, und Cloud- und Token-Kosten laufen auf Ihren eigenen Konten, sodass Sie den Kostenhebel behalten.
Sagen Sie uns, wo Sie in zwölf Monaten stehen möchten. Wir liefern Ihnen einen Plan, um dorthin zu gelangen.
Praxisnahe Leitfäden und Analysen unserer Ingenieure für 2026.
Teilen Sie uns einige Details mit, und ein Senior-Consultant antwortet innerhalb eines Werktages.
E-Mail: sales@yusmpgroup.com
Telefon: +374 44 871 811
Büros: KAMAR Business Center, Vazgen Sargsyan Str. 2, Yerevan, Armenien · Remote — Überlappung mit der US-Ostküste (9–13 Uhr ET)