PII che fuoriescono nei log di OpenAI
I prompt degli utenti contengono spesso nomi, email e dati sanitari. Implementiamo rilevamento e redazione di PII e configurazione dell'endpoint ZDR prima che qualsiasi prompt lasci il perimetro.
Integriamo i modelli GPT di OpenAI in SaaS in produzione con output strutturati, function calling e harness di valutazione — non demo. Ogni progetto viene consegnato con un documento di classificazione del rischio EU AI Act, configurazione GDPR ZDR e un fallback ad Anthropic o modelli self-hosted, così da non essere mai vincolati ai prezzi o alla disponibilità di un solo provider.
Forniamo ingegneria di integrazione OpenAI per quattro profili di acquirente: team di prodotto SaaS che aggiungono funzionalità basate su GPT — estrazione, classificazione, riassunto, reranking della ricerca; settori regolamentati che richiedono conformità EU AI Act e configurazione GDPR ZDR; clienti enterprise che costruiscono assistenti AI interni su corpus privati; e piattaforme che sostituiscono flussi di revisione manuale con automazione basata su LLM. La neutralità rispetto al vendor è integrata — ogni integrazione viene instradata attraverso un layer di astrazione che consente di passare tra OpenAI, Anthropic e modelli self-hosted senza riscrivere la logica dell'applicazione.
I prompt degli utenti contengono spesso nomi, email e dati sanitari. Implementiamo rilevamento e redazione di PII e configurazione dell'endpoint ZDR prima che qualsiasi prompt lasci il perimetro.
La spesa in token aumenta in modo imprevedibile senza budget per funzionalità e avvisi di anomalia. Strumentalizziamo ogni chiamata al modello con metriche di conteggio token e generiamo avvisi prima che i budget mensili vengano superati.
I modelli GPT-4 allucinano su recuperi poco specificati o istruzioni ambigue. Fondiamo le risposte con RAG, usiamo output strutturati per vincolare il formato e applichiamo gate sui punteggi di fedeltà RAGAS.
L'input controllato dall'utente incorporato nei prompt di sistema crea vettori di iniezione. Applichiamo schemi strutturati, delimitatori espliciti, validazione dell'output e set di test avversariali in CI.
Le modifiche ai prompt vengono rilasciate senza controlli di qualità e degradano silenziosamente gli output. Costruiamo harness di valutazione basati su RAGAS e richiediamo il superamento delle valutazioni come gate di merge in CI.
I regolatori si aspettano una classificazione del rischio documentata prima che le funzionalità AI vadano in produzione. Conduciamo il workshop di classificazione il primo giorno e produciamo un fascicolo tecnico, non un foglio di calcolo.
Retrieval-augmented generation su documenti interni, knowledge base e database — con pgvector o Qdrant, attribuzione delle fonti e controlli sulle allucinazioni.
Agenti GPT che chiamano API interne, database e strumenti — con schemi tipizzati, logica di retry e gate di approvazione human-in-the-loop per azioni sensibili.
Parsing di documenti, estrazione da moduli e classificazione con modalità JSON e validazione dello schema Pydantic — in sostituzione dei flussi di revisione manuale.
Pipeline di moderazione che combinano l'API di moderazione OpenAI con classificatori personalizzati per categorie di policy specifiche della piattaforma.
Ricerca ibrida BM25 + embedding con reranking basato su GPT — migliora significativamente la pertinenza per ricerche di catalogo, knowledge base e codice.
Layer di routing neutral rispetto al provider che instrada verso OpenAI, Anthropic o modelli self-hosted in base al tipo di attività, al budget dei costi e all'SLA di latenza.
Conforme GDPR · Consapevole EU AI Act · Capacità SOC 2 · Capacità HIPAA · CCPA considerato
Comune: OWASP LLM Top 10, rafforzamento contro le prompt injection, SBOM per le dipendenze dei modelli.
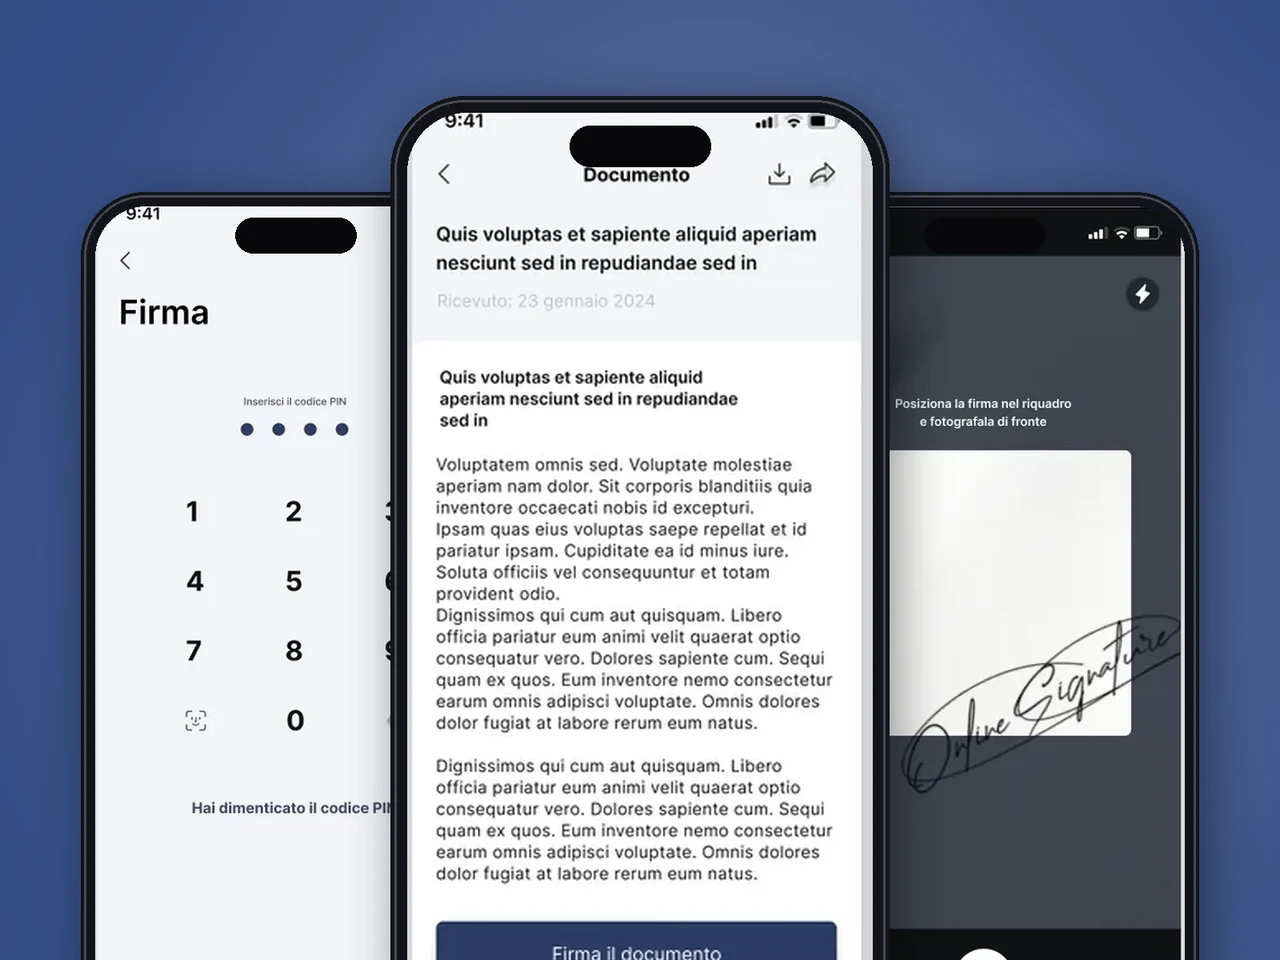
App iOS e Android native per firma digitale con CRM Symfony + React per uno studio legale transfrontaliero — onboarding KYC e pista probante per pratiche USA e UE.
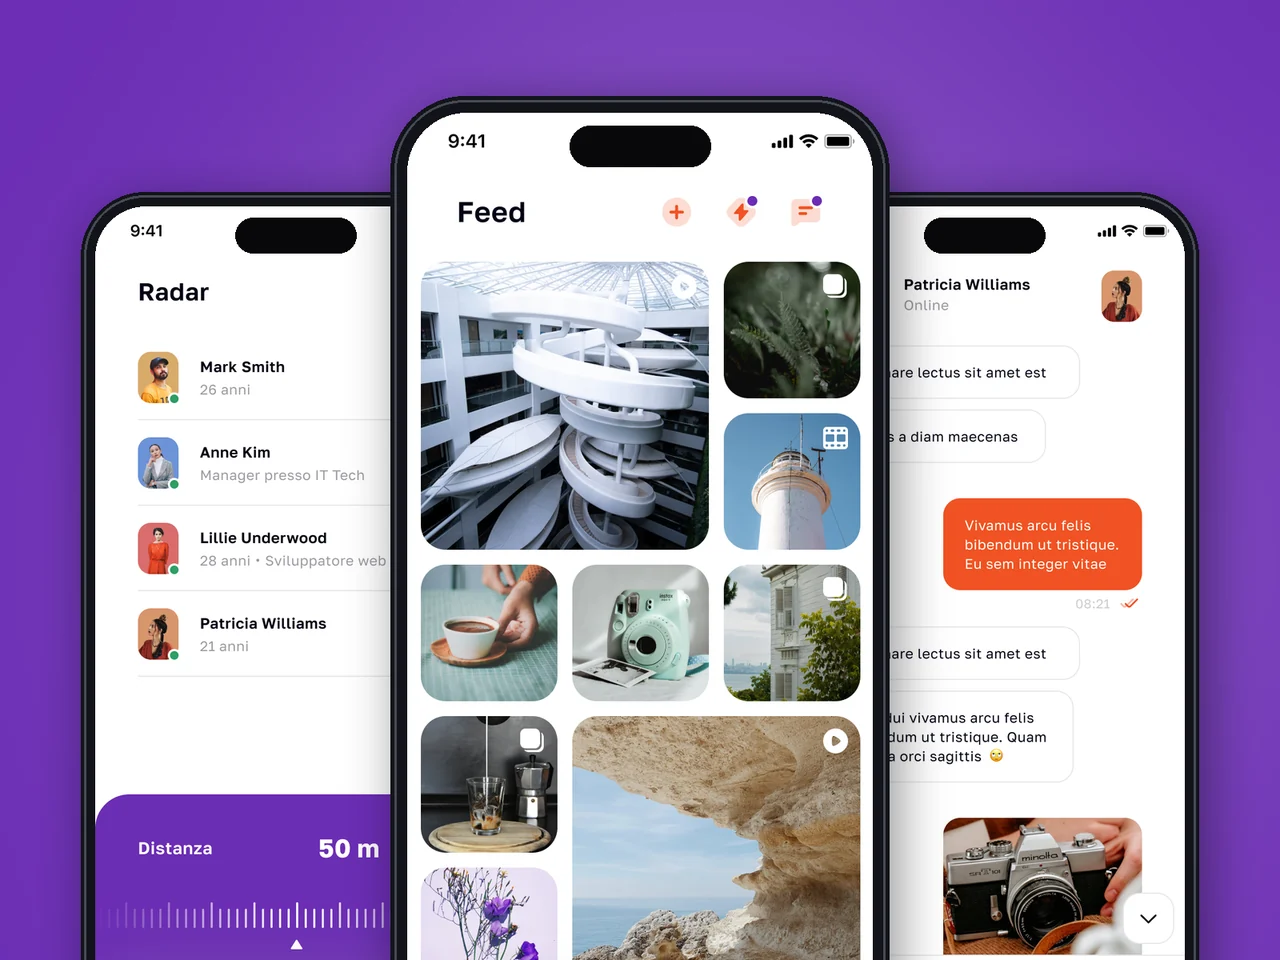
Piattaforma social in produzione su App Store e Google Play con geo Radar, messaggistica cifrata ed economia virtuale negli Stati Uniti e in Europa.
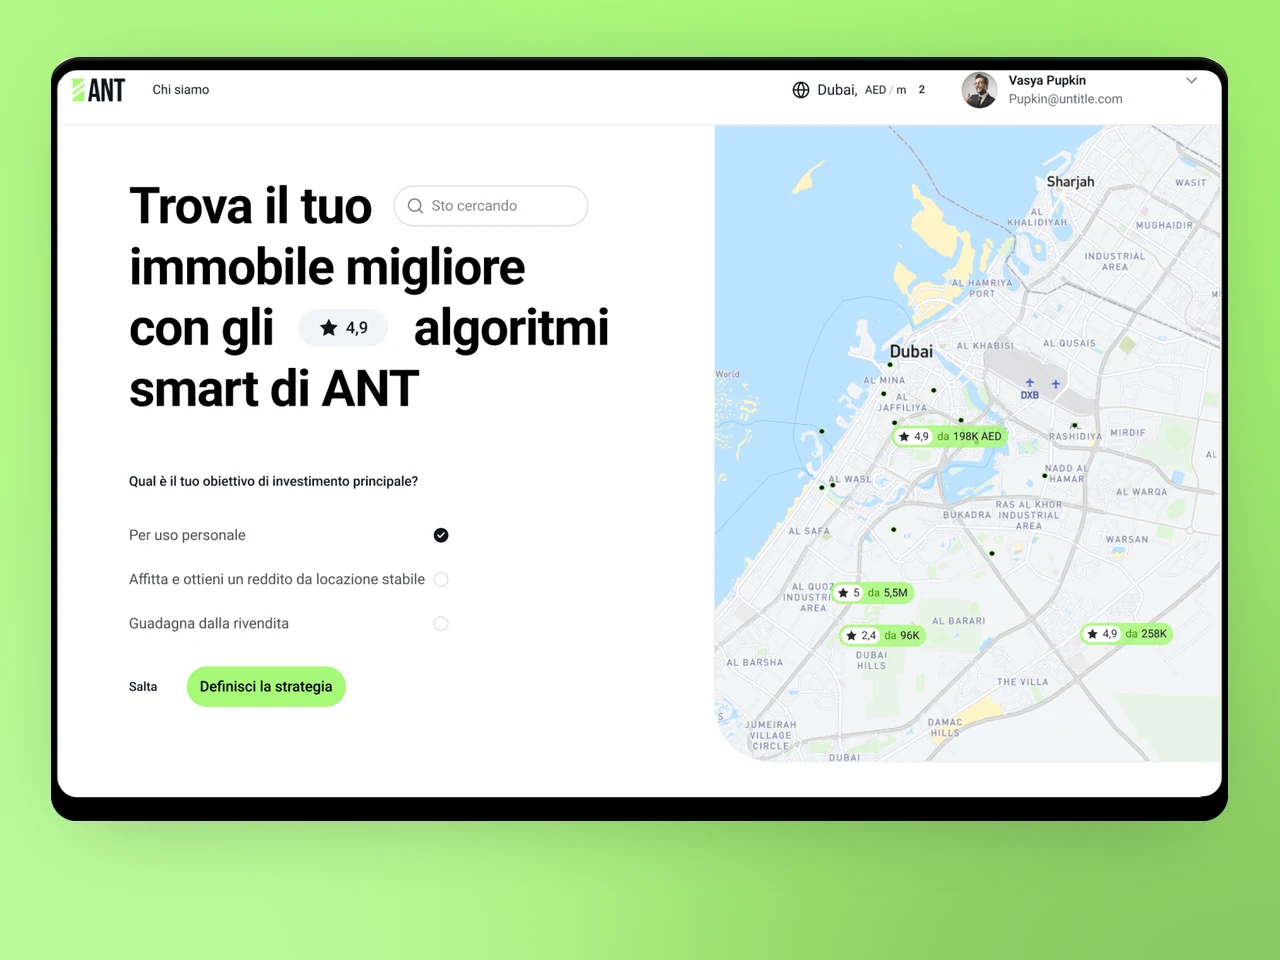
Piattaforma web marketplace immobiliare con CMS listing, ricerca e console admin B2B per operatori negli Stati Uniti e in Europa.
La firma elettronica di documenti da remoto è un campo minato dal punto di vista legale. YuSMP ha realizzato sia il flusso di firma mobile che il CRM Symfony in un unico ingaggio, ha gestito l'onboarding KYC e ha consegnato una documentazione API che il nostro team di compliance ha approvato in pochi giorni.
Costruire una piattaforma social da zero è un lavoro ad alto rischio. YuSMP ha consegnato il feed degli interessi, il Radar geografico, le Stories e l'economia delle monete virtuali nei tempi previsti, con una codebase che il nostro team interno ha recepito il primo giorno di consegna.
Un motore di decisione sui prestiti che impiega dieci volte meno tempo per approvare non avviene per caso. YuSMP ha costruito la pipeline di scoring, l’integrazione con i bureau del credito e un back-office che i nostri sottoscrittori apprezzano davvero. I tempi di approvazione sono passati da due giorni a meno di quattro ore.
Pubblichiamo decine di articoli sportivi al giorno. YuSMP ha costruito una pipeline editoriale usando un bot Telegram come CMS — i redattori pubblicano una volta sola, il contenuto arriva sul web, su iOS e su Android istantaneamente. L'architettura non richiede alcuna manutenzione quotidiana.
1 / 4
Integriamo OpenAI, Anthropic, Mistral e modelli self-hosted attraverso un router unificato — così potete cambiare provider senza riscrivere la logica dell'applicazione.
Nessun prompt viene rilasciato senza una valutazione di regressione. Metriche RAGAS, confronti golden-set e benchmark specifici per il business vengono eseguiti in CI a ogni merge.
Ogni progetto AI inizia con un workshop di classificazione del rischio. I sistemi ad alto rischio ricevono piani di valutazione della conformità; i sistemi a rischio limitato ricevono modelli di divulgazione trasparente.
Domande frequenti
Configuriamo endpoint API con zero data retention (ZDR) dove disponibili, implementiamo rilevamento e redazione di PII con Microsoft Presidio o modelli NER personalizzati prima che i prompt lascino il perimetro, e instradamo i dati personali UE esclusivamente tramite Azure OpenAI con endpoint in regioni UE e configurazione no-logging.
Gli endpoint ZDR istruiscono OpenAI a non conservare alcun dato della richiesta API oltre la risposta immediata. Disponibili su modelli selezionati tramite accordo API. Documentiamo la configurazione ZDR nel vostro accordo sul trattamento dei dati e la includiamo nel fascicolo tecnico EU AI Act.
Implementiamo caching semantico (GPTCache o Redis personalizzato) per evitare di interrogare nuovamente prompt identici, selezioniamo i livelli di modello per attività (gpt-4o-mini per il routing, gpt-4o per l'analisi), impostiamo budget max_tokens, monitoriamo il consumo di token per funzionalità in tempo reale e generiamo avvisi in caso di anomalie.
Costruiamo un harness di valutazione prima di scrivere il primo prompt: Q&A golden-set, metriche RAGAS per la qualità del recupero e metriche specifiche per ogni funzionalità. Ogni modifica al template di prompt esegue la suite di valutazione in CI. Nessun prompt viene rilasciato senza un gate di regressione.
Conduciamo un workshop strutturato che copre scopo previsto, popolazione utenti, autonomia decisionale e settore per assegnare il corretto livello di rischio. I sistemi ad alto rischio (scoring CV, supporto decisionale medico) ricevono un piano di valutazione della conformità; i sistemi a rischio limitato ricevono modelli di divulgazione trasparente. La classificazione è documentata in un fascicolo tecnico.
RAG per corpus dinamici dove l'attribuzione delle fonti è importante — documenti legali, cataloghi prodotti, knowledge base di supporto. Fine-tuning per tono, formato o vocabolario di dominio stabili che il RAG da solo non può produrre in modo affidabile. Raccomandiamo il RAG come prima scelta e valutiamo il fine-tuning solo quando il RAG raggiunge il plateau.
Schema di output strutturati (modalità JSON + Pydantic), chiara separazione dei contenuti sistema/utente con delimitatori espliciti, validazione dello schema di output, set di test di iniezione avversariale in CI e monitoraggio di pattern di output anomali in produzione.
Sì. Implementiamo un router di modelli che instrada verso OpenAI, Anthropic Claude, Mistral o un modello self-hosted in base al tipo di attività, al budget dei costi e all'SLA di latenza. Il layer applicativo chiama il router, non un modello specifico — pertanto la sostituzione del provider non richiede modifiche al codice dell'applicazione.
Diteci dove volete essere tra dodici mesi. Vi risponderemo con un piano per arrivarci.
Risposta entro 1 giorno lavorativo. NDA su richiesta.
Condividete alcuni dettagli e un consulente senior risponderà entro un giorno lavorativo.
Email: sales@yusmpgroup.com
Telefono: +374 44 871 811
Uffici: KAMAR Business Center, Vazgen Sargsyan St. 2, Erevan, Armenia · Remoto — sovrapposizione con la costa est degli Stati Uniti (9:00–13:00 ET)