Blog News Contact Demander une proposition

Services d'intégration OpenAI pour Applications GPT en Production

Nous intégrons les modèles GPT d'OpenAI dans des SaaS de production avec des sorties structurées, du function calling et des harnais d'évaluation — pas des démos. Chaque engagement est livré avec un document de classification des risques selon le règlement européen sur l'IA, une configuration RGPD ZDR, et un basculement vers Anthropic ou des modèles auto-hébergés pour ne jamais être lié aux tarifs ou à la disponibilité d'un seul fournisseur.

  • OpenAI GPT-4.1
  • GPT-4o
  • Whisper
  • Structured Outputs

Nous livrons des projets d'ingénierie d'intégration OpenAI pour quatre profils d'acheteurs : les équipes produit SaaS qui ajoutent des fonctionnalités propulsées par GPT — extraction, classification, résumé, reclassement de recherche ; les secteurs réglementés exigeant la conformité au règlement européen sur l'IA et la configuration RGPD ZDR ; les clients entreprise qui construisent des assistants IA internes sur des corpus privés ; et les plateformes qui remplacent les flux de révision manuelle par une automatisation propulsée par LLM. La neutralité fournisseur est intégrée — chaque intégration est routée via une couche d'abstraction qui permet de passer d'OpenAI à Anthropic ou à des modèles auto-hébergés sans réécrire la logique applicative.

Défis métier que nous résolvons

Fuite de données personnelles vers les journaux OpenAI

Les prompts utilisateurs contiennent souvent des noms, e-mails et données de santé. Nous implémentons la détection et la suppression des données personnelles ainsi que la configuration ZDR avant que tout prompt ne quitte le périmètre.
Dérapage des coûts sans surveillance

Les dépenses en tokens augmentent de façon imprévisible sans budgets par fonctionnalité et alertes d'anomalies. Nous instrumentons chaque appel de modèle avec des métriques de comptage de tokens et alertons avant que les budgets mensuels soient dépassés.

Hallucinations sur les contextes longs

Les modèles GPT-4 hallucinent sur des récupérations sous-spécifiées ou des instructions ambiguës. Nous ancrons les réponses avec RAG, utilisons des sorties structurées pour contraindre le format, et conditionnons les seuils sur les scores de fidélité RAGAS.

Attaques par injection de prompts

Les entrées contrôlées par l'utilisateur intégrées dans les prompts système créent des vecteurs d'injection. Nous appliquons des schémas structurés, des délimiteurs explicites, une validation des sorties et des jeux de tests adversariaux en CI.

Gestion des évaluations et des régressions

Les modifications de prompts sont déployées sans contrôle qualité et dégradent silencieusement les sorties. Nous construisons des harnais d'évaluation basés sur RAGAS et exigeons des évaluations réussies comme porte d'entrée CI pour les fusions.

Pression de classification selon le règlement européen sur l'IA

Les régulateurs attendent une classification des risques documentée avant la mise en ligne des fonctionnalités IA. Nous conduisons l'atelier de classification le premier jour et produisons un dossier technique, pas une simple feuille de calcul.

Solutions que nous construisons

RAG sur corpus privés

Génération augmentée par récupération sur des documents internes, des bases de connaissances et des bases de données — avec pgvector ou Qdrant, attribution des sources et contrôles des hallucinations.

Agents avec function calling

Agents GPT qui appellent des API internes, des bases de données et des outils — avec des schémas typés, une logique de nouvelle tentative et des portes d'approbation humaine pour les actions sensibles.

Extraction par sortie structurée

Analyse de documents, extraction de formulaires et classification avec le mode JSON et la validation de schéma Pydantic — remplaçant les flux de révision manuelle.

Modération de contenu

Pipelines de modération combinant l'API de modération OpenAI avec des classifieurs personnalisés pour les catégories de politique spécifiques à la plateforme.

Reclassement de recherche

Recherche hybride BM25 + embedding avec reclassement propulsé par GPT — améliore significativement la pertinence pour les catalogues, bases de connaissances et recherches de code.

Routage multi-LLM

Couche de routage neutre fournisseur qui dispatche vers OpenAI, Anthropic ou des modèles auto-hébergés selon le type de tâche, le budget de coût et le SLA de latence.

Stack technologique

  • OpenAI GPT-4.1
  • GPT-4o
  • Whisper
  • Structured Outputs
  • Assistants API
  • Embeddings
  • LangChain
  • LlamaIndex
  • pgvector
  • Qdrant
  • LangSmith
  • Ragas
  • FastAPI
  • Python

Conformité & réglementations

Conforme au RGPD · Sensible au règlement européen sur l'IA · Compatible SOC 2 · Compatible HIPAA · CCPA pris en compte

UE

  • Règlement UE sur l'IA, Art. 50 — divulgations de transparence pour les contenus générés par IA.
  • Règlement UE sur l'IA, Art. 5 — revue des pratiques interdites et documentation.
  • RGPD Art. 22 — prise de décision automatisée, AIPD, surveillance humaine.
  • RGPD — configuration ZDR des endpoints, résidence des données, base légale.

États-Unis

  • NIST AI RMF — alignement gouverner, cartographier, mesurer, gérer.
  • CCPA/CPRA — opt-out de la prise de décision automatisée et droits des personnes concernées.
  • SR 11-7 — gestion des risques des modèles pour l'IA financière.
  • HIPAA — minimum nécessaire, dé-identification pour l'IA en santé.

Commun : OWASP LLM Top 10, durcissement contre l'injection de prompts, SBOM pour les dépendances de modèles.

Ce que disent nos clients

“
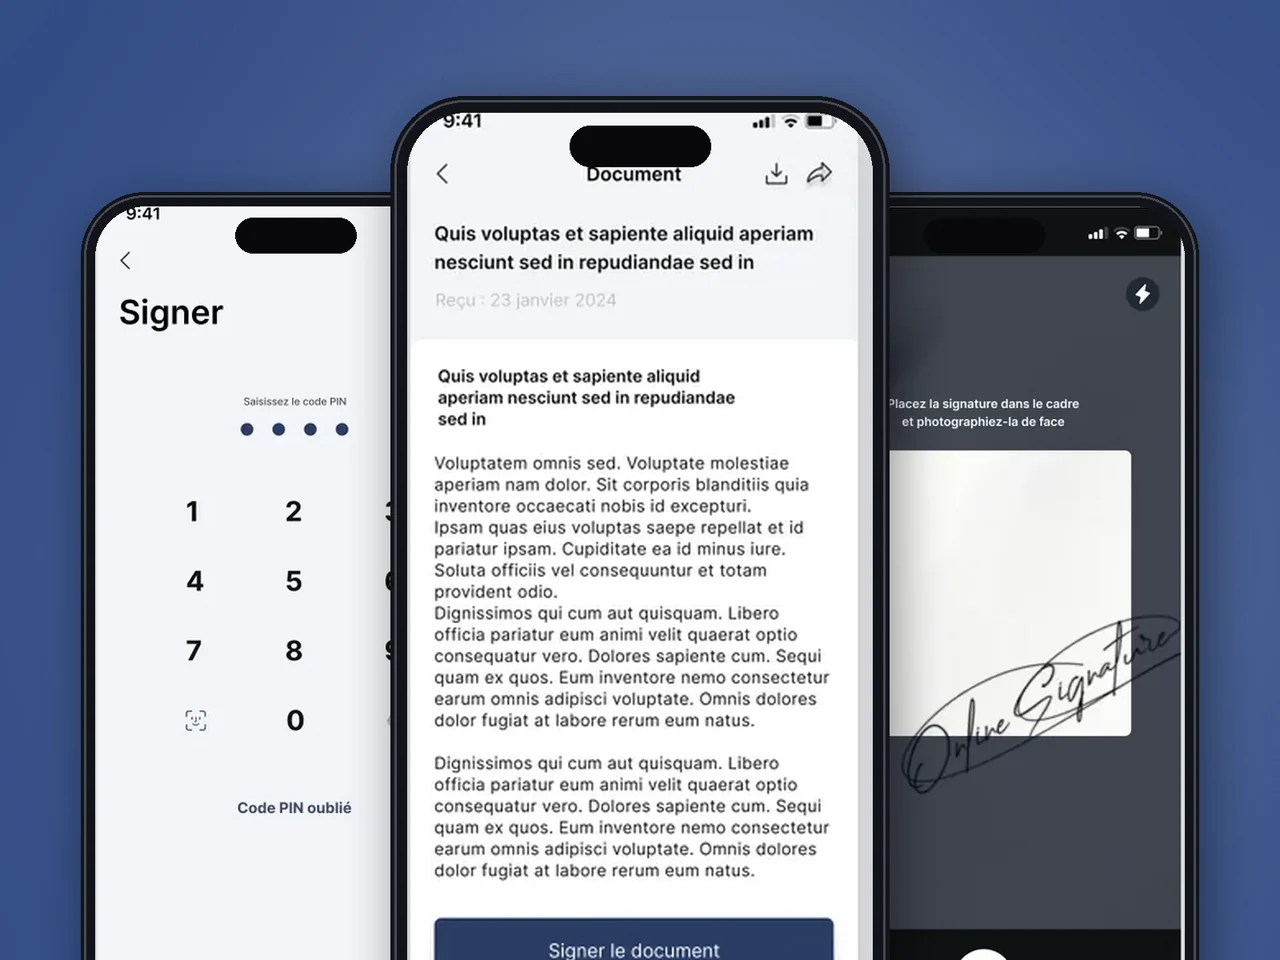
La signature de documents à distance est un champ de mines juridique. YuSMP a construit à la fois le parcours de signature mobile et le CRM Symfony dans une seule mission, a géré l'onboarding KYC et a livré une documentation d'API que notre équipe conformité a validée en quelques jours.
David MercerCEO, Signatory Pro
Voir le cas →
“
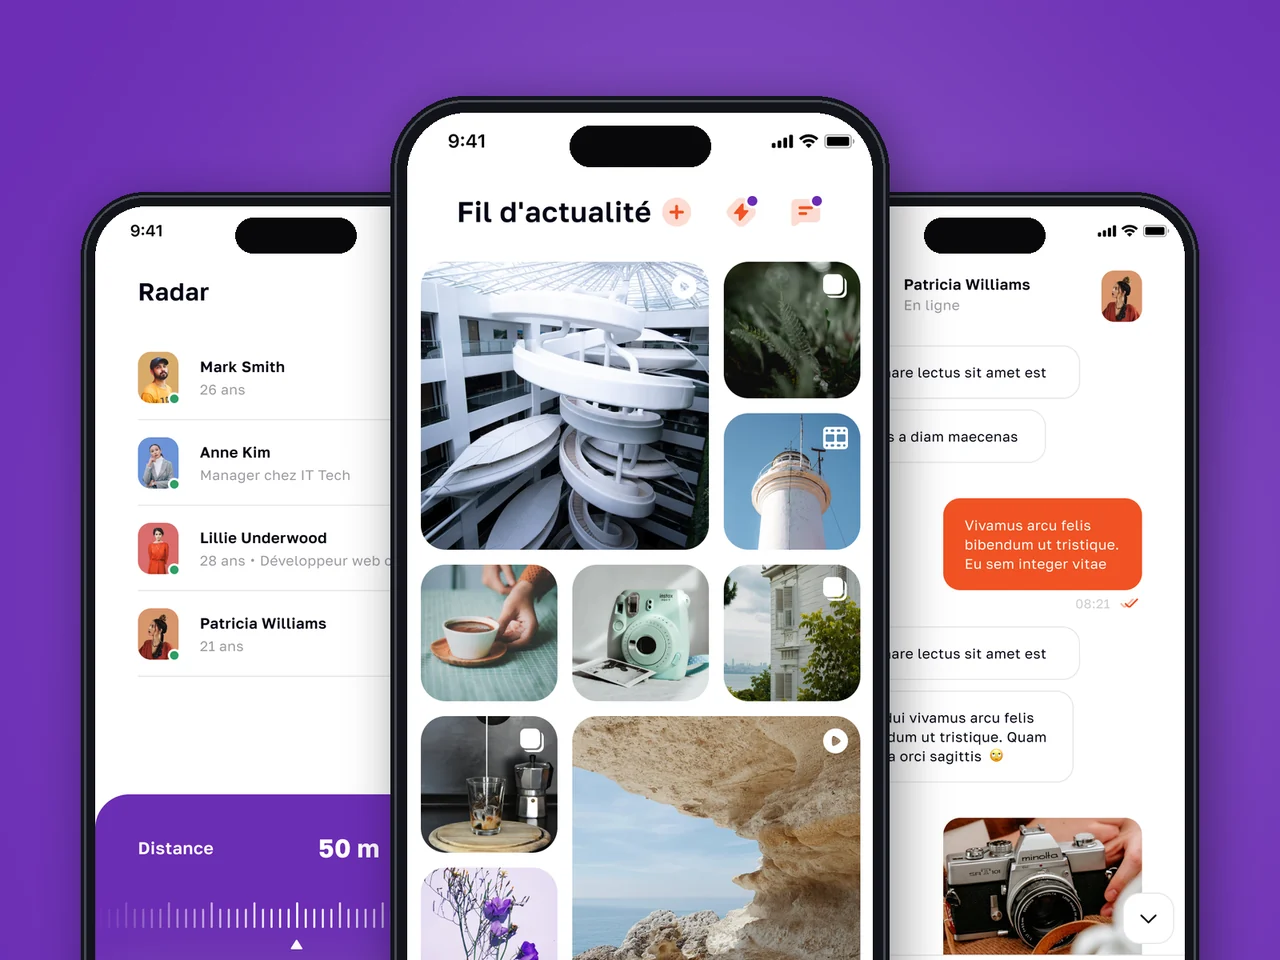
Construire une plateforme sociale de zéro est un travail à fort enjeu. YuSMP a livré le fil d'intérêts, le Radar géographique, les Stories et l'économie de pièces virtuelles dans les délais, avec une base de code que notre équipe interne a prise en main dès le premier jour du transfert.
Michael HartleyCEO, JoyJet
Voir le cas →
“
Un moteur de décision de crédit qui approuve dix fois plus vite n'arrive pas par hasard. YuSMP a construit le pipeline de scoring, l'intégration aux bureaux de crédit et un back-office que nos analystes prennent réellement plaisir à utiliser. Le délai d'approbation est passé de deux jours à moins de quatre heures.
Gregory LawsonCTO, LoanFlow
Voir le cas →
“
Nous publions des dizaines d'articles sportifs par jour. YuSMP a construit un pipeline éditorial utilisant un bot Telegram comme CMS — les rédacteurs publient une seule fois et le contenu apparaît instantanément sur le web, iOS et Android. L'architecture ne demande aucune maintenance quotidienne.
Ryan O'ConnorCEO, Media Arena
Voir le cas →

1 / 4

Pourquoi les équipes IA choisissent YuSMP

Expérience en routage multi-LLM

Nous intégrons OpenAI, Anthropic, Mistral et des modèles auto-hébergés via un routeur unifié — pour changer de fournisseur sans réécrire la logique applicative.

Harnais d'évaluation à chaque modification de prompt

Aucun prompt n'est déployé sans évaluation de régression. Métriques RAGAS, comparaisons de référence et benchmarks métier spécifiques s'exécutent en CI à chaque fusion.

Classification règlement UE sur l'IA dès le premier jour

Chaque engagement IA commence par un atelier de classification des risques. Les systèmes à haut risque reçoivent des plans d'évaluation de conformité ; les systèmes à risque limité reçoivent des modèles de divulgation de transparence.

FAQ

FAQ Intégration OpenAI

Comment évitez-vous que les données personnelles UE ne transitent dans les journaux OpenAI ?

Nous configurons les endpoints API à rétention zéro (ZDR) lorsqu'ils sont disponibles, implémentons la détection et la suppression des données personnelles avec Microsoft Presidio ou des modèles NER personnalisés avant que les prompts ne quittent notre périmètre, et routons les données personnelles UE exclusivement via Azure OpenAI avec des endpoints en région UE et une configuration sans journalisation.

Qu'est-ce que l'endpoint Zero Data Retention d'OpenAI ?

Les endpoints ZDR demandent à OpenAI de ne stocker aucune donnée de requête API au-delà de la réponse immédiate. Disponibles sur certains modèles via accord API. Nous documentons la configuration ZDR dans votre accord de traitement des données et l'incluons dans le dossier technique du règlement européen sur l'IA.

Comment contrôlez-vous les coûts LLM ?

Nous implémentons la mise en cache sémantique (GPTCache ou Redis personnalisé) pour éviter de réémettre des requêtes identiques, sélectionnons les niveaux de modèle par tâche (gpt-4o-mini pour le routage, gpt-4o pour l'analyse), définissons des budgets max_tokens, surveillons les dépenses en tokens par fonctionnalité en temps réel et alertons sur les anomalies.

Comment évaluez-vous la qualité des sorties GPT avant de déployer des modifications ?

Nous construisons un harnais d'évaluation avant d'écrire le premier prompt : questions-réponses de référence, métriques RAGAS pour la qualité de récupération, et métriques métier spécifiques par fonctionnalité. Chaque modification de template de prompt exécute la suite d'évaluation en CI. Aucun prompt n'est déployé sans test de régression.

Quel est votre processus de classification selon le règlement européen sur l'IA ?

Nous conduisons un atelier structuré couvrant la finalité prévue, la population d'utilisateurs, l'autonomie décisionnelle et le secteur pour assigner le bon niveau de risque. Les systèmes à haut risque (scoring de CV, aide à la décision médicale) reçoivent un plan d'évaluation de conformité ; les systèmes à risque limité reçoivent des modèles de divulgation de transparence. La classification est documentée dans un dossier technique.

Fine-tuning ou RAG — lequel convient à notre cas d'usage ?

RAG pour les corpus dynamiques où l'attribution des sources est importante — documents juridiques, catalogues produits, bases de connaissances support. Le fine-tuning pour un ton, un format ou un vocabulaire de domaine stables que le RAG seul ne peut pas produire de manière fiable. Nous recommandons RAG en premier et n'évaluons le fine-tuning que lorsque le RAG plafonne.

Comment vous défendez-vous contre l'injection de prompts ?

Schémas de sortie structurée (mode JSON + Pydantic), séparation claire du contenu système/utilisateur avec des délimiteurs explicites, validation du schéma de sortie, jeux de tests d'injection adversariaux en CI, et surveillance des patterns de sortie anormaux en production.

Pouvez-vous construire une couche de routage multi-LLM pour éviter la dépendance fournisseur ?

Oui. Nous implémentons un routeur de modèles qui dispatche vers OpenAI, Anthropic Claude, Mistral ou un modèle auto-hébergé selon le type de tâche, le budget de coût et le SLA de latence. La couche applicative appelle le routeur, non un modèle spécifique — ainsi changer de fournisseur ne nécessite aucune modification du code applicatif.

Déployez des fonctionnalités OpenAI avec couverture règlement UE sur l'IA et RGPD

Dites-nous où vous voulez être dans douze mois. Nous reviendrons vers vous avec un plan pour y parvenir.

Demander une proposition

Réponse sous 1 jour ouvré. NDA sur demande.

Demander une proposition

Partagez quelques détails et un consultant senior vous répondra dans un délai d'un jour ouvré.

Estimation de projet gratuite — nous revenons vers vous avec un plan sous 1 à 2 jours ouvrés.
  • Analyse du besoin et recommandations sur la stack
  • Estimation des délais, du budget et de l’équipe
  • Sans engagement — simplement un plan clair

E-mail : sales@yusmpgroup.com

Téléphone : +374 44 871 811

Bureaux : KAMAR Business Center, Vazgen Sargsyan St. 2, Erevan, Arménie · Télétravail — chevauchement avec la côte est des États-Unis (9h–13h ET)

— champs obligatoires