Scegliere l'indice giusto
HNSW o IVFFlat? Scegliere il tipo di indice e i suoi parametri (m, ef_construction, lists, probes) in modo errato significa build lenti, memoria gonfia o recall scarsa.
Aiutiamo i team USA e UE ad aggiungere la ricerca di similarità vettoriale di qualità produttiva a PostgreSQL con l'estensione pgvector — nessun database vettoriale separato da provisionare, proteggere o pagare. I vostri embedding risiedono accanto alle righe relazionali che descrivono, così le query ibride, i join e il controllo degli accessi restano in un unico motore che già gestite. Dall'ottimizzazione degli indici ai backend RAG completi, rendiamo pgvector veloce, preciso e facile da mantenere.
Aiutiamo i team USA e UE ad aggiungere la ricerca di similarità vettoriale di qualità produttiva a PostgreSQL con l'estensione pgvector — nessun database vettoriale separato da provisionare, proteggere o pagare. I vostri embedding risiedono accanto alle righe relazionali che descrivono, così le query ibride, i join e il controllo degli accessi restano in un unico motore che già gestite. Dall'ottimizzazione degli indici ai backend RAG completi, rendiamo pgvector veloce, preciso e facile da mantenere.
HNSW o IVFFlat? Scegliere il tipo di indice e i suoi parametri (m, ef_construction, lists, probes) in modo errato significa build lenti, memoria gonfia o recall scarsa.
La ricerca approssimativa bilancia accuratezza e velocità. Ottimizzare questo trade-off per i vostri dati e il carico di query non è banale ed è facile sbagliare.
Milioni di vettori ad alta dimensione mettono sotto pressione la memoria e i tempi di build degli indici; senza una strategia di partitioning e dimensionamento, le performance crollano.
Le query reali combinano la similarità vettoriale con filtri SQL, join e full-text search. I piani naivi scansionano tutto e ignorano i vostri indici.
Cambiare il modello di embedding o la dimensione invalida i vettori memorizzati, e il drift silenzioso del modello degrada lentamente la qualità del recupero nel tempo.
Gli embedding devono aggiornarsi quando cambiano le righe sorgente. Senza una pipeline affidabile, il vostro indice diventa obsoleto e restituisce risultati errati.
Installiamo e configuriamo pgvector, scegliamo HNSW o IVFFlat per ogni carico di lavoro e ottimizziamo i parametri degli indici sui vostri dati reali per la recall e la velocità di cui avete bisogno.
Scriviamo query che combinano la ricerca di similarità con filtri SQL, join e full-text, con piani di query che usano effettivamente i vostri indici.
Costruiamo backend di retrieval-augmented generation — chunking, embedding, retrieval e re-ranking — interamente sul vostro PostgreSQL con LlamaIndex o LangChain.
Dimensioniamo la memoria, partizioniamo le tabelle grandi e effettuiamo benchmark dei build degli indici affinché la ricerca vettoriale resti veloce con la crescita del corpus.
Costruiamo pipeline che ri-embeddano e re-indicizzano automaticamente quando cambiano le righe sorgente, mantenendo i vettori coerenti con i vostri dati.
Migramo i carichi di lavoro da database vettoriali standalone come Pinecone o Qdrant verso pgvector, unificando due datastore in uno solo.
GDPR · residenza dei dati · HIPAA-ready · SOC 2
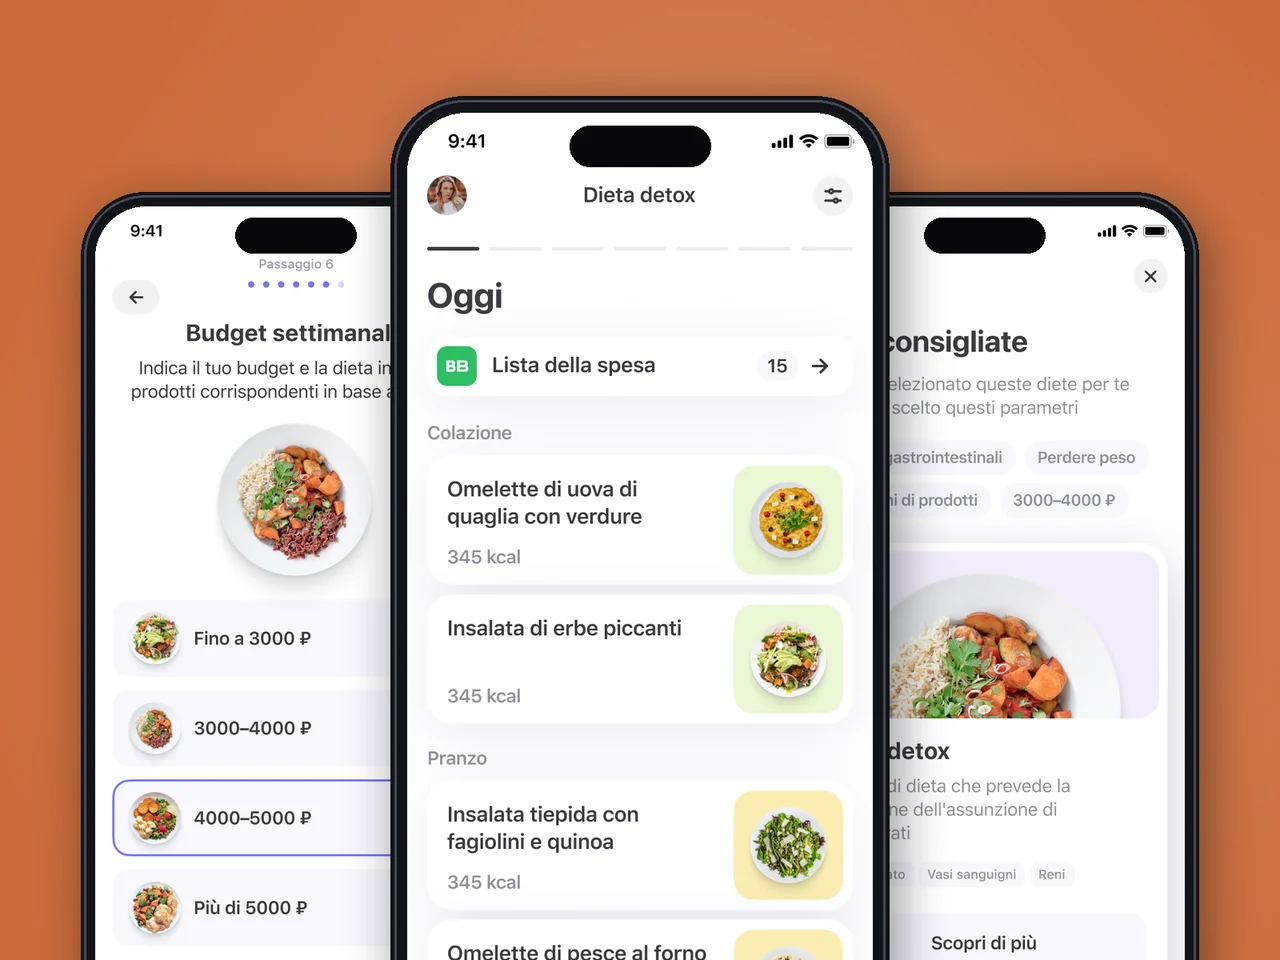
App multipiattaforma per dieta e pianificazione dei pasti su Flutter — motore calorico, libreria di ricette, piano alimentare settimanale, ordinazione della spesa.
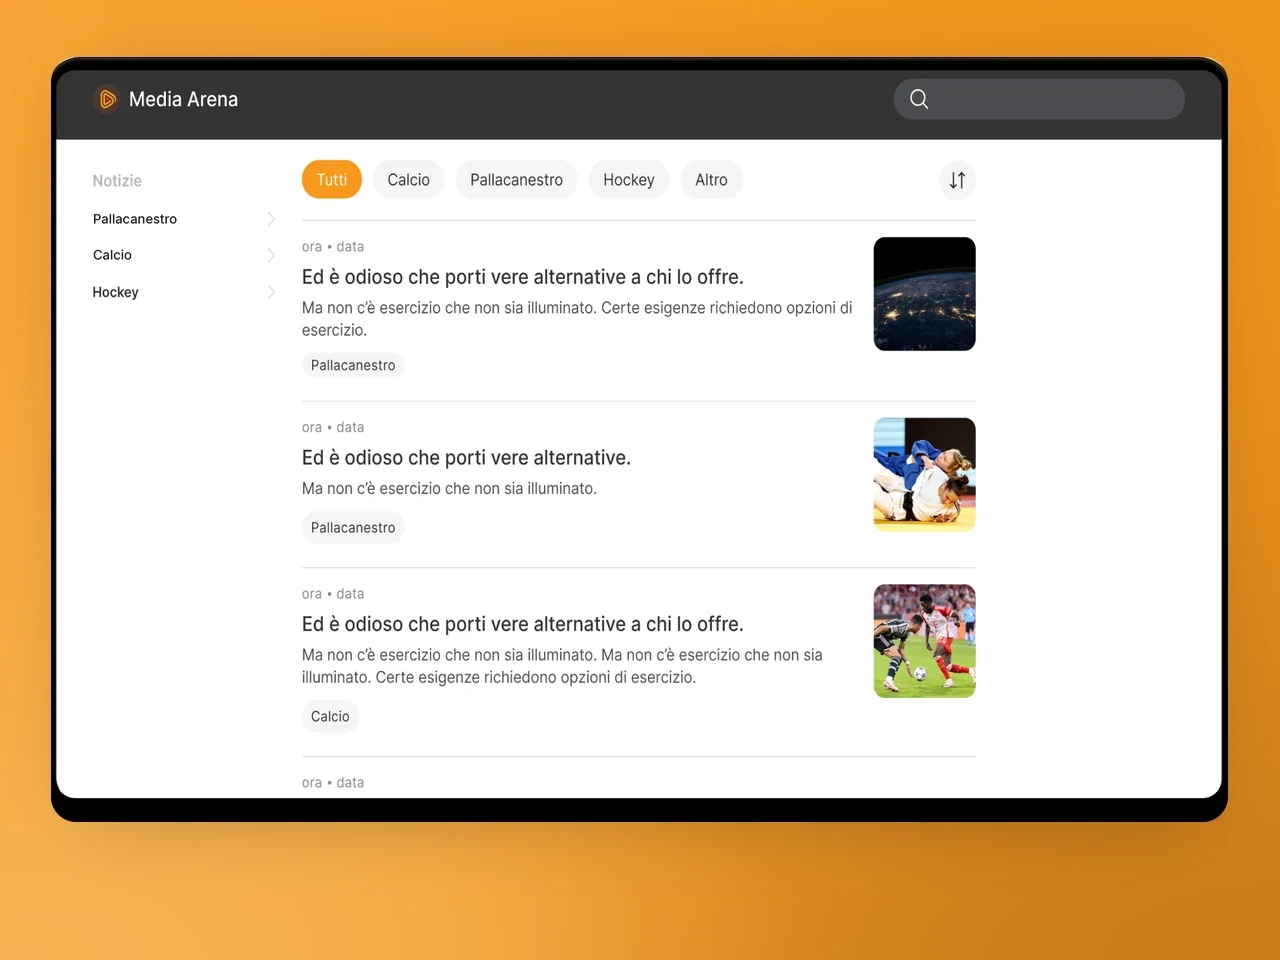
App di notizie sportive multipiattaforma e portale web — CMS basato su bot Telegram invece di un admin personalizzato, pipeline di pubblicazione Markdown.
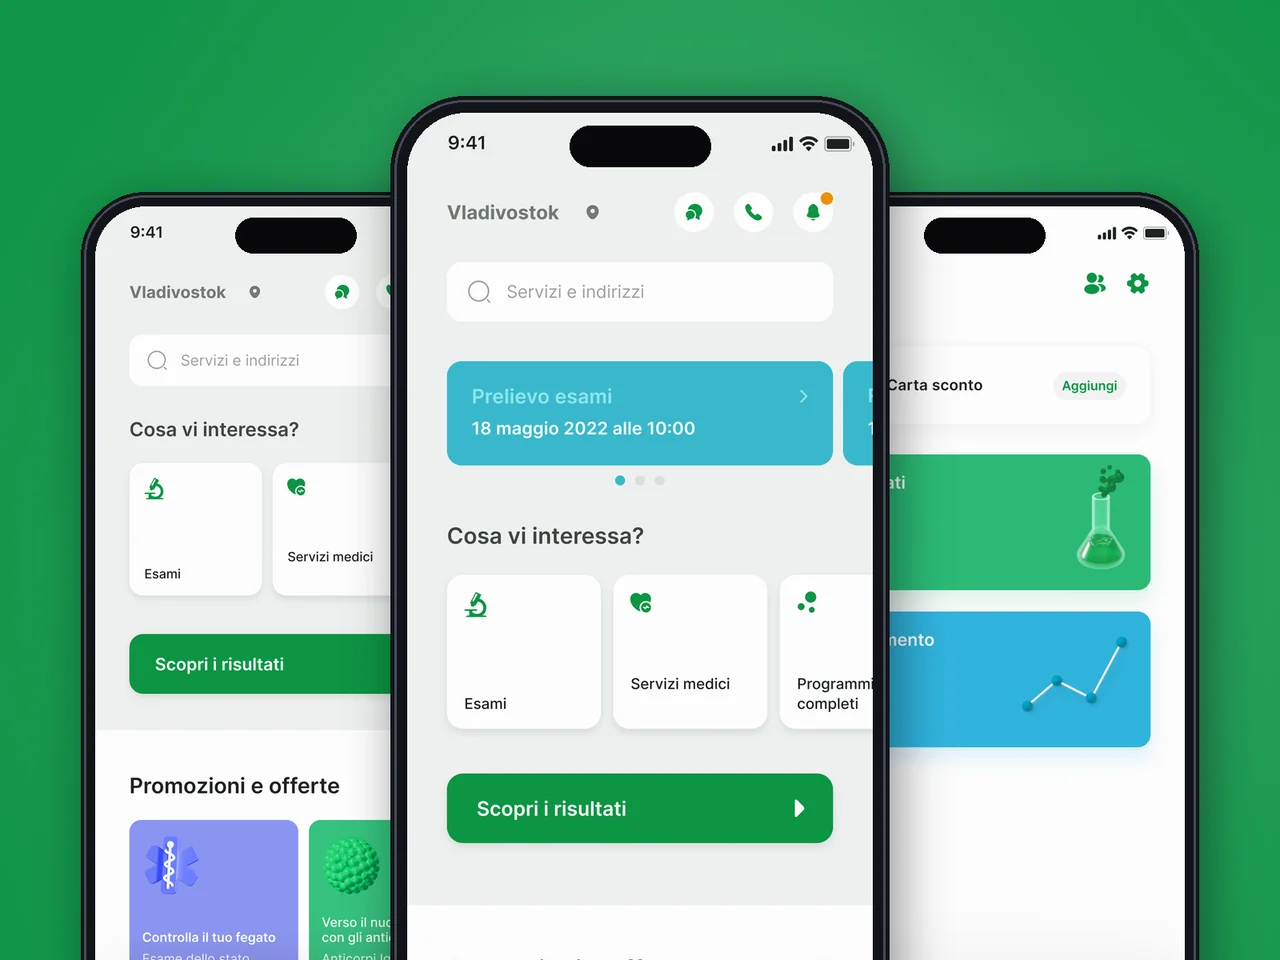
App paziente per una rete di laboratori in 40 città — prenotazione appuntamenti, risultati digitali, oltre 2.500 analisi, integrazioni di pianificazione e contabilità.
Pubblichiamo decine di articoli sportivi al giorno. YuSMP ha costruito una pipeline editoriale usando un bot Telegram come CMS — i redattori pubblicano una volta sola, il contenuto arriva sul web, su iOS e su Android istantaneamente. L'architettura non richiede alcuna manutenzione quotidiana.
Avevamo un'idea e tempistiche stringenti. YuSMP ha trasformato uno scheletro Flutter in un'app per la nutrizione pronta per la produzione con motore calorico, piani alimentari e abbonamenti App Store in quattro mesi. La retention a 90 giorni ha superato il nostro benchmark del 30%.
Gestire appuntamenti e referti in più città su tre piattaforme è genuinamente complesso. YuSMP ha risolto un problema di integrazione legacy che avevamo evitato per due anni e ha rilasciato un'esperienza paziente che i nostri punteggi NPS hanno immediatamente rispecchiato.
Un motore di decisione sui prestiti che impiega dieci volte meno tempo per approvare non avviene per caso. YuSMP ha costruito la pipeline di scoring, l’integrazione con i bureau del credito e un back-office che i nostri sottoscrittori apprezzano davvero. I tempi di approvazione sono passati da due giorni a meno di quattro ore.
1 / 4
I vostri vettori rimangono nel PostgreSQL che già gestite, fate il backup e proteggete — nessun database vettoriale separato da provisionare, monitorare o pagare, e un unico motore su cui ragionare.
Ottimizziamo indici, memoria e piani di query sui vostri dati e carichi reali, non sui valori predefiniti, affinché recall e latenza soddisfino i vostri target in produzione.
Per i clienti USA e UE manteniamo gli embedding dei dati regolamentati all'interno della vostra regione conforme, con i controlli degli accessi, il logging e i percorsi di cancellazione che gli auditor si aspettano.
Domande frequenti
Se i vostri dati si trovano già in PostgreSQL, pgvector vi consente di mantenere gli embedding accanto ad essi — query ibride, join, transazioni, backup e controllo degli accessi restano tutti in un unico motore. Questo elimina un intero datastore da gestire, proteggere e pagare. I database vettoriali dedicati si guadagnano il loro posto a scala molto grande o con funzionalità specializzate, ma la maggior parte dei team raggiunge quei limiti più tardi del previsto.
HNSW offre alta recall e query veloci con build più lente e più avide di memoria, ed è la scelta predefinita per la maggior parte dei carichi di lavoro con molte letture. IVFFlat costruisce più velocemente e usa meno memoria ma richiede liste e probes ottimizzati ed è più sensibile alla distribuzione dei dati. Effettuiamo benchmark di entrambi sui vostri dati prima di procedere.
pgvector gestisce comodamente milioni di vettori su un'istanza ben dimensionata, e decine di milioni con partitioning e attento tuning della memoria. Oltre a ciò, i tempi di build degli indici, la RAM e la latenza delle query diventano i vincoli — effettuiamo benchmark del vostro corpus per trovare il limite reale prima che lo raggiungiate.
Sì — è uno dei motivi principali per usare pgvector. Scriviamo query ibride che combinano la ricerca di similarità con filtri WHERE, join e full-text search, e ottimizziamo il piano di query affinché sia l'indice vettoriale che i vostri indici relazionali vengano utilizzati in modo efficiente.
Ottimizziamo i parametri dell'indice (ef_search per HNSW, probes per IVFFlat) e misuriamo la recall rispetto a una baseline di ricerca esatta sui vostri dati. Voi definite il target — ad esempio 95% di recall entro un budget di latenza — e noi ottimizziamo per raggiungerlo, documentando poi le impostazioni.
Costruiamo una pipeline di embedding che rileva le righe sorgente modificate — tramite trigger, change-data-capture o una coda — le ri-embeds e aggiorna l'indice, così i vostri vettori non si disallineano mai rispetto alle righe che descrivono.
Quando i build degli indici, la RAM o la latenza delle query smettono di soddisfare i target anche dopo il tuning e il partitioning, o quando avete bisogno di funzionalità che pgvector non offre. Vi diremo onestamente quando si arriverà a quel punto e pianificheremo una migrazione verso un database vettoriale dedicato, riutilizzando la pipeline di embedding già costruita.
Diteci dove volete essere tra dodici mesi. Vi risponderemo con un piano per arrivarci.
Risposta entro 1 giorno lavorativo. NDA su richiesta.
Condividete alcuni dettagli e un consulente senior risponderà entro un giorno lavorativo.
Email: sales@yusmpgroup.com
Telefono: +374 44 871 811
Uffici: KAMAR Business Center, Vazgen Sargsyan St. 2, Erevan, Armenia · Remoto — sovrapposizione con la costa est degli Stati Uniti (9:00–13:00 ET)