Choisir le bon index
HNSW ou IVFFlat ? Choisir le mauvais type d'index et ses paramètres (m, ef_construction, lists, probes) signifie des constructions lentes, une mémoire surdimensionnée ou un rappel insuffisant.
Nous aidons les équipes américaines et européennes à ajouter une recherche par similarité vectorielle de qualité production à PostgreSQL avec l'extension pgvector — sans base de données vectorielle séparée à provisionner, sécuriser ou financer. Vos embeddings résident à côté des lignes relationnelles qu'ils décrivent, de sorte que les requêtes hybrides, les jointures et le contrôle d'accès restent dans un seul moteur que vous exploitez déjà. Du réglage d'index aux backends RAG complets, nous rendons pgvector rapide, précis et facile à maintenir.
Nous aidons les équipes américaines et européennes à ajouter une recherche par similarité vectorielle de qualité production à PostgreSQL avec l'extension pgvector — sans base de données vectorielle séparée à provisionner, sécuriser ou financer. Vos embeddings résident à côté des lignes relationnelles qu'ils décrivent, de sorte que les requêtes hybrides, les jointures et le contrôle d'accès restent dans un seul moteur que vous exploitez déjà. Du réglage d'index aux backends RAG complets, nous rendons pgvector rapide, précis et facile à maintenir.
HNSW ou IVFFlat ? Choisir le mauvais type d'index et ses paramètres (m, ef_construction, lists, probes) signifie des constructions lentes, une mémoire surdimensionnée ou un rappel insuffisant.
La recherche approximative échange la précision contre la vitesse. Calibrer ce compromis pour vos données et votre charge de requêtes n'est pas évident et facile à rater.
Des millions de vecteurs à haute dimension sollicitent la mémoire et les temps de construction d'index ; sans stratégie de partitionnement et de dimensionnement, les performances chutent brutalement.
Les vraies requêtes combinent la similarité vectorielle avec des filtres SQL, des jointures et la recherche en texte intégral. Les plans naïfs analysent tout et ignorent vos index.
Changer le modèle d'embedding ou la dimension invalide les vecteurs stockés, et une dérive silencieuse du modèle dégrade progressivement la qualité de récupération au fil du temps.
Les embeddings doivent se mettre à jour quand les lignes sources changent. Sans pipeline fiable, votre index devient obsolète et renvoie des résultats incorrects.
Nous installons et configurons pgvector, choisissons HNSW ou IVFFlat selon la charge de travail, et réglons les paramètres d'index sur vos données réelles pour le rappel et la vitesse dont vous avez besoin.
Nous écrivons des requêtes qui mélangent la recherche de similarité avec des filtres SQL, des jointures et le texte intégral, avec des plans de requête qui utilisent réellement vos index.
Nous construisons des backends de génération augmentée par récupération — découpage, embedding, récupération et re-classement — entièrement sur votre PostgreSQL avec LlamaIndex ou LangChain.
Nous dimensionnons la mémoire, partitionnons les grandes tables et mesurons les constructions d'index pour que la recherche vectorielle reste rapide à mesure que votre corpus grandit.
Nous construisons des pipelines qui réembèdent et réindexent automatiquement lorsque les lignes sources changent, maintenant les vecteurs cohérents avec vos données.
Nous migrons les charges de travail depuis des bases de données vectorielles autonomes comme Pinecone ou Qdrant vers pgvector, fusionnant deux datastores en un seul.
RGPD · résidence des données · compatible HIPAA · SOC 2
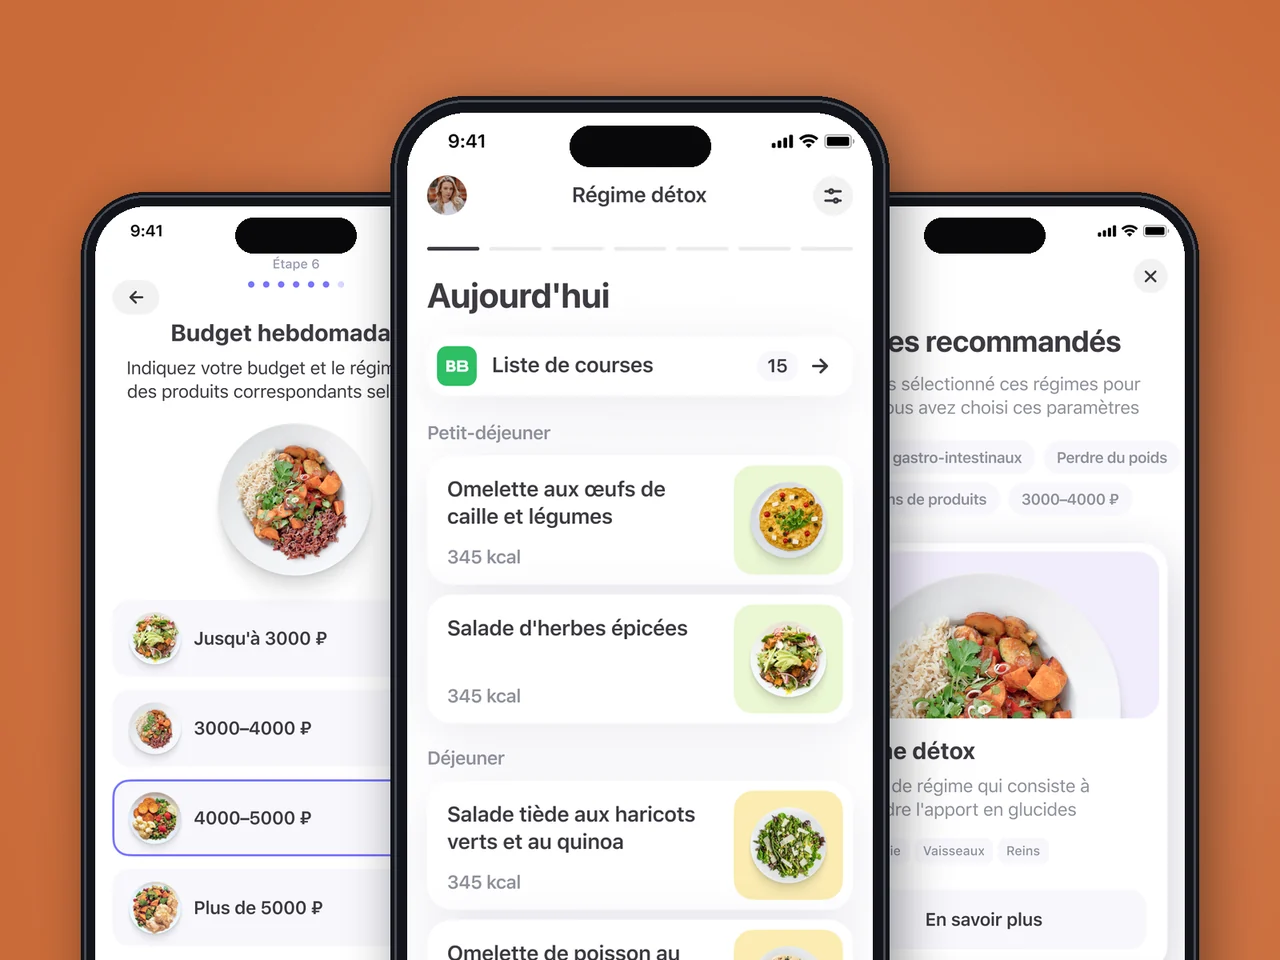
Application multiplateforme de régime et planification des repas sur Flutter — moteur calorique, bibliothèque de recettes, plan de repas hebdomadaire, commande de courses.
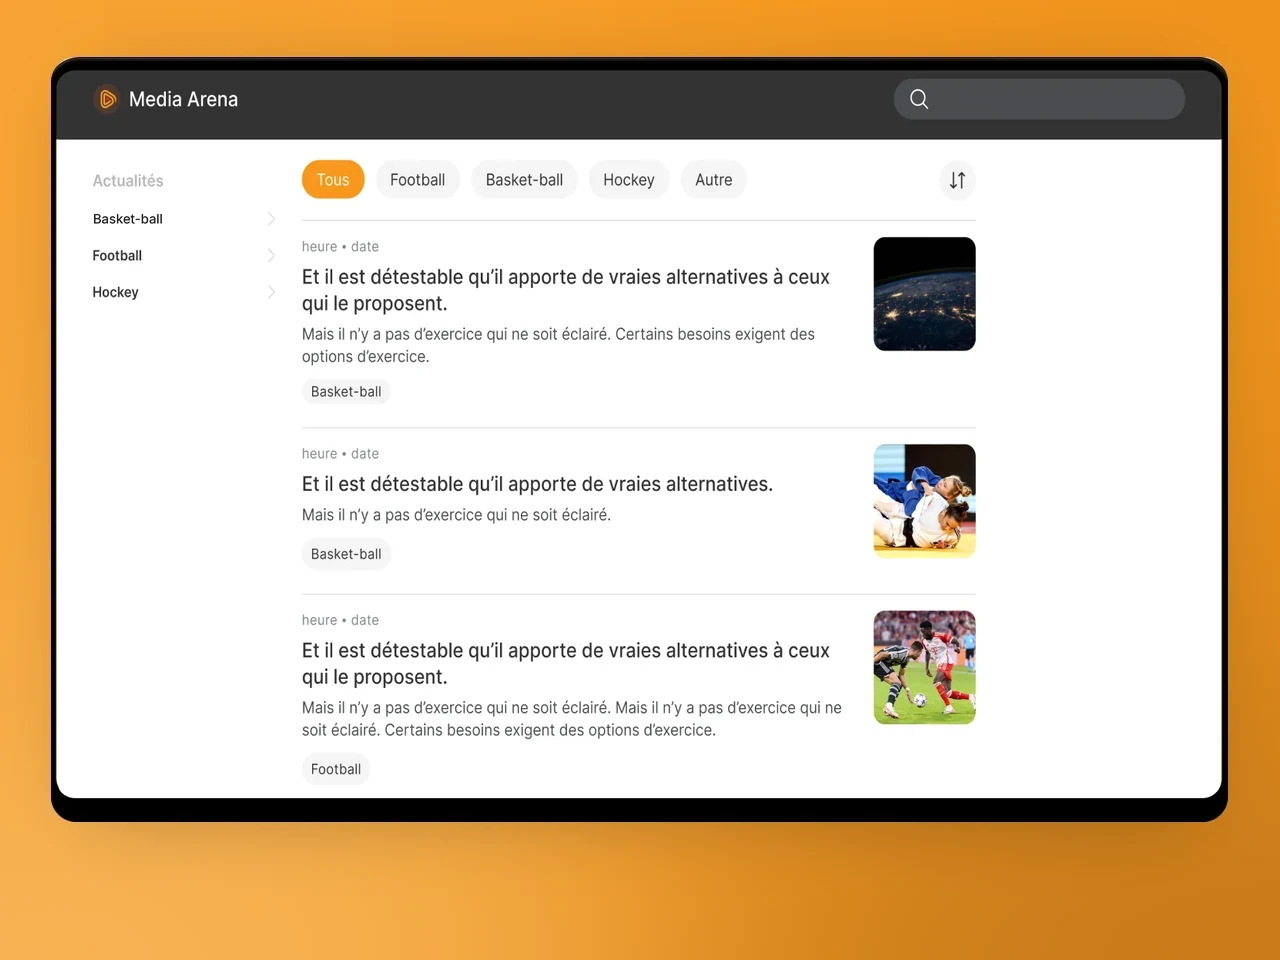
Application d'actualités sportives multiplateforme et portail web — CMS via bot Telegram plutôt qu'un admin personnalisé, pipeline de publication Markdown.
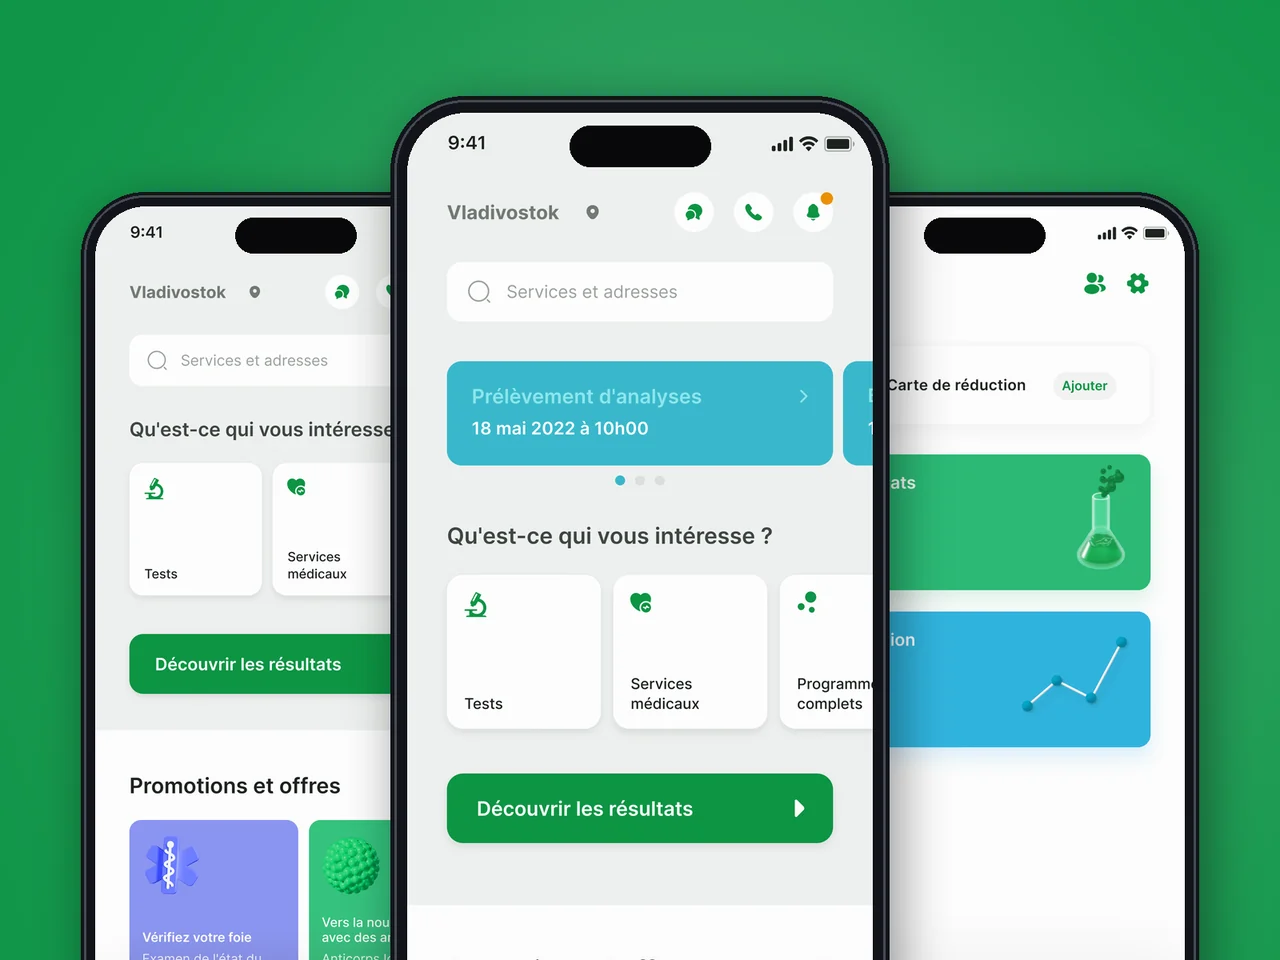
Application patient pour un réseau de laboratoires de 40 villes — prise de rendez-vous, résultats numériques, 2 500+ tests, intégrations de planification et de comptabilité.
Nous publions des dizaines d'articles sportifs par jour. YuSMP a construit un pipeline éditorial utilisant un bot Telegram comme CMS — les rédacteurs publient une seule fois et le contenu apparaît instantanément sur le web, iOS et Android. L'architecture ne demande aucune maintenance quotidienne.
Nous avions un concept et des délais serrés. YuSMP a transformé un squelette Flutter en une application de nutrition prête pour la production, avec un moteur de calories, des plans de repas et des abonnements App Store en quatre mois. La rétention à 90 jours a dépassé notre objectif de 30 %.
Gérer les rendez-vous et les résultats d'analyses dans plusieurs villes sur trois plateformes est réellement complexe. YuSMP a résolu un problème d'intégration hérité que nous évitions depuis deux ans et a livré une expérience patient que nos scores NPS ont immédiatement reflétée.
Un moteur de décision de crédit qui approuve dix fois plus vite n'arrive pas par hasard. YuSMP a construit le pipeline de scoring, l'intégration aux bureaux de crédit et un back-office que nos analystes prennent réellement plaisir à utiliser. Le délai d'approbation est passé de deux jours à moins de quatre heures.
1 / 4
Vos vecteurs restent dans le PostgreSQL que vous exploitez, sauvegardez et sécurisez déjà — pas de base de données vectorielle séparée à provisionner, surveiller ou financer, et un seul moteur à gérer.
Nous réglons les index, la mémoire et les plans de requête sur vos données et votre charge réelles, pas des valeurs par défaut, afin que le rappel et la latence atteignent vos objectifs en production.
Pour les clients américains et européens, nous maintenons les embeddings de données réglementées dans votre région conforme, avec les contrôles d'accès, la journalisation et les chemins d'effacement attendus par les auditeurs.
FAQ
Si vos données résident déjà dans PostgreSQL, pgvector vous permet de conserver les embeddings à côté d'elles — les requêtes hybrides, les jointures, les transactions, les sauvegardes et le contrôle d'accès restent dans un seul moteur. Cela élimine un datastore entier à exploiter, sécuriser et financer. Les bases de données vectorielles dédiées justifient leur existence à très grande échelle ou avec des fonctionnalités spécialisées, mais la plupart des équipes atteignent ces limites plus tard qu'elles ne le prévoient.
HNSW offre un rappel élevé et des requêtes rapides avec des constructions plus lentes et plus gourmandes en mémoire, et est le choix par défaut pour la plupart des charges de travail à lecture intensive. IVFFlat se construit plus rapidement et utilise moins de mémoire mais nécessite des listes et des probes réglés et est plus sensible à la distribution des données. Nous comparons les deux sur vos données avant de nous engager.
pgvector gère confortablement des millions de vecteurs sur une instance bien dimensionnée, et des dizaines de millions avec du partitionnement et un réglage minutieux de la mémoire. Au-delà, le temps de construction de l'index, la RAM et la latence des requêtes deviennent les contraintes — nous mesurons votre corpus pour trouver le plafond réel avant que vous ne l'atteigniez.
Oui — c'est l'une des raisons principales d'utiliser pgvector. Nous écrivons des requêtes hybrides qui mélangent la recherche de similarité avec des filtres WHERE, des jointures et la recherche en texte intégral, et nous optimisons le plan de requête pour que l'index vectoriel et vos index relationnels soient utilisés efficacement.
Nous réglons les paramètres d'index (ef_search pour HNSW, probes pour IVFFlat) et mesurons le rappel par rapport à une recherche exacte de référence sur vos données. Vous définissez l'objectif — par exemple 95 % de rappel dans un budget de latence — et nous le calibrons pour l'atteindre, puis documentons les paramètres.
Nous construisons un pipeline d'embedding qui détecte les lignes sources modifiées — via des déclencheurs, la capture des changements de données ou une file d'attente — les réembède et met à jour l'index, afin que vos vecteurs ne dérivent jamais par rapport aux lignes qu'ils décrivent.
Lorsque les constructions d'index, la RAM ou la latence des requêtes cessent de répondre aux objectifs même après réglage et partitionnement, ou lorsque vous avez besoin de fonctionnalités que pgvector n'offre pas. Nous vous dirons honnêtement quand ce point arrivera et planifierons une migration vers une base de données vectorielle dédiée, en réutilisant le pipeline d'embedding déjà construit.
Dites-nous où vous voulez être dans douze mois. Nous reviendrons vers vous avec un plan pour y parvenir.
Réponse sous 1 jour ouvrable. NDA sur demande.
Partagez quelques détails et un consultant senior vous répondra sous un jour ouvrable.
E-mail : sales@yusmpgroup.com
Téléphone : +374 44 871 811
Bureaux : KAMAR Business Center, Vazgen Sargsyan St. 2, Erevan, Arménie · À distance — chevauchement avec la côte est des États-Unis (9h–13h ET)