Progettazione DAG e idempotenza
I task non idempotenti corrompono i dati al retry, e i DAG che ignorano la semantica della data di esecuzione rendono pericolosi backfill e riesecuzioni storiche invece di renderli routine.
Realizziamo e gestiamo Apache Airflow in produzione per i team di dati negli Stati Uniti e in Europa — orchestrando ELT batch, caricamenti warehouse e pipeline analytics che girano secondo pianificazione e si riprendono correttamente dai guasti. I nostri ingegneri scrivono DAG idempotenti, scelgono l’executor giusto per i vostri volumi e collegano monitoraggio, SLA e alerting in modo che i guasti emergano prima che gli stakeholder se ne accorgano. Che si ospiti autonomamente o si utilizzi Airflow gestito su MWAA, Cloud Composer o Astronomer, si ottengono pipeline osservabili, verificabili e sicure con i dati regolamentati.
Realizziamo e gestiamo Apache Airflow in produzione per i team di dati negli Stati Uniti e in Europa — orchestrando ELT batch, caricamenti warehouse e pipeline analytics che girano secondo pianificazione e si riprendono correttamente dai guasti. I nostri ingegneri scrivono DAG idempotenti, scelgono l’executor giusto per i vostri volumi e collegano monitoraggio, SLA e alerting in modo che i guasti emergano prima che gli stakeholder se ne accorgano. Che si ospiti autonomamente o si utilizzi Airflow gestito su MWAA, Cloud Composer o Astronomer, si ottengono pipeline osservabili, verificabili e sicure con i dati regolamentati.
I task non idempotenti corrompono i dati al retry, e i DAG che ignorano la semantica della data di esecuzione rendono pericolosi backfill e riesecuzioni storiche invece di renderli routine.
Un singolo scheduler e l’executor sbagliato si bloccano sotto centinaia di task concorrenti, lasciando i DAG in coda, gli slot a corto e gli SLA mancati nei picchi.
Le credenziali hard-coded nei DAG o memorizzate in connessioni in chiaro trapelano nei log e nel source control, e la loro rotazione diventa un’operazione manuale e soggetta a errori.
Senza retry calibrati, callback di SLA miss e instradamento reale degli alert, le pipeline falliscono in silenzio e il team dei dati lo scopre da una dashboard rotta.
Spingere payload grandi o dati personali attraverso XCom gonfia il database dei metadati e fa trapelare dati sensibili; i task dovrebbero passare riferimenti, non righe.
File DAG copiati manualmente, mancanza di parità delle dipendenze e modifiche non testate causano errori di import e schedule rotte nel momento in cui un DAG raggiunge la produzione.
Progettiamo i DAG attorno a task idempotenti e sicuri al retry, con dipendenze esplicite e comportamento di backfill pulito utilizzando la logica della data di esecuzione e la TaskFlow API.
Orchestriamo l’ELT end-to-end — ingestione, trasformazioni dbt e caricamenti warehouse in Snowflake o BigQuery — con controlli di qualità dei dati che bloccano i task a valle.
Dimensioniamo e ottimizziamo l’executor Celery o Kubernetes, i pool e la concorrenza in modo che i DAG scalino orizzontalmente e le pipeline ad alta priorità non rimangano mai a corto di risorse.
Colleghiamo callback di SLA miss, alerting dei guasti verso Slack/PagerDuty e metriche in modo che ogni esecuzione sia osservabile e gli incidenti vengano rilevati tempestivamente.
Spostiamo le credenziali in un backend per i segreti (Vault, secret manager AWS/GCP) con connessioni limitate, rotazione e nessun valore sensibile nel codice o nei log.
Configuriamo o migriamo Airflow su MWAA, Cloud Composer o Astronomer — dimensionando gli ambienti, configurando il CI/CD per i DAG e passando alla nuova infrastruttura senza perdita di dati.
GDPR · cronologia delle esecuzioni a livello di audit · pronto per HIPAA · SOC 2
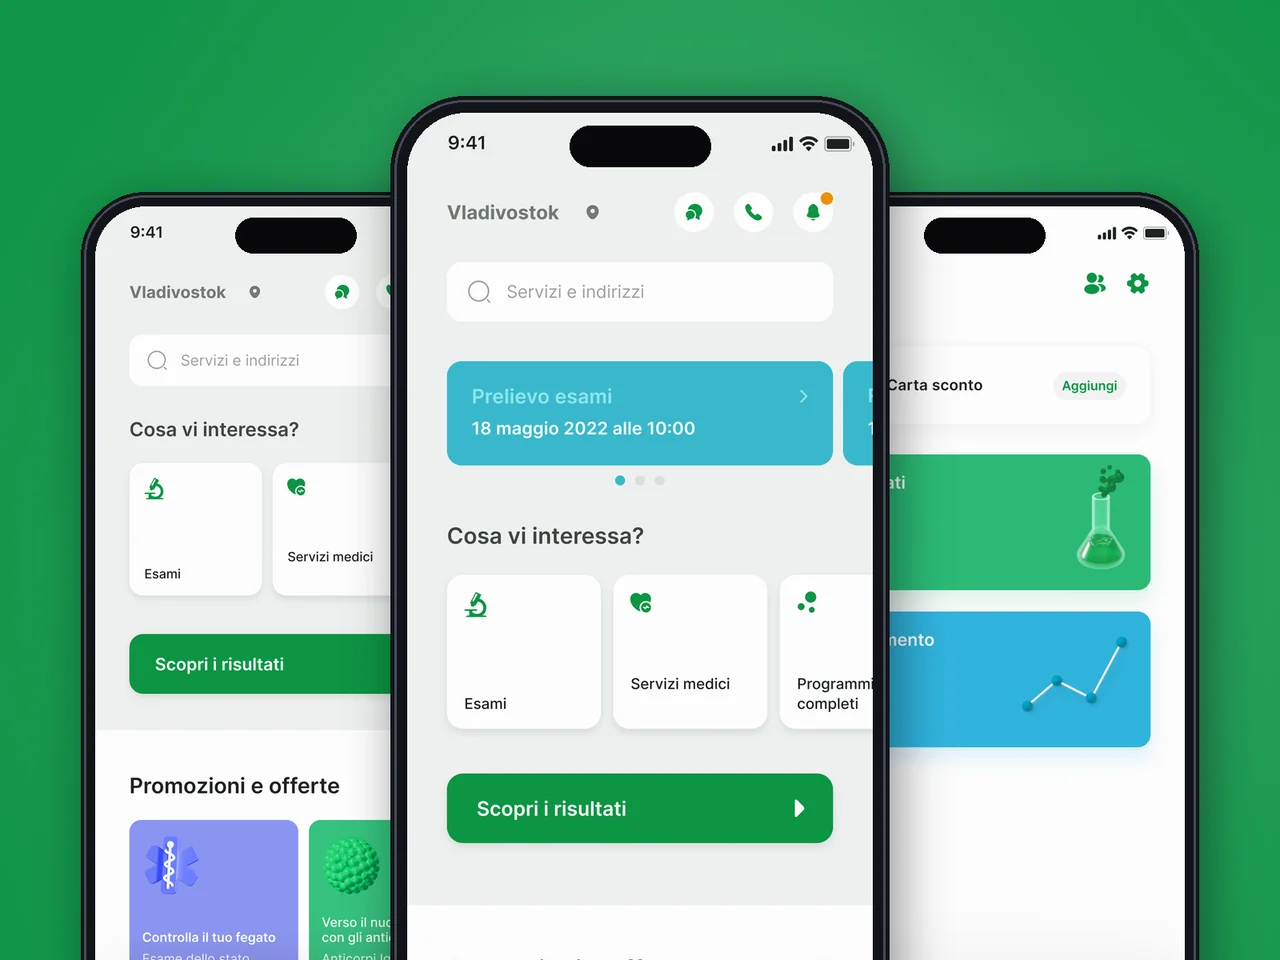
App per pazienti di una rete di laboratori in 40 città — prenotazione appuntamenti, risultati digitali, oltre 2.500 esami, integrazioni con scheduling e contabilità.
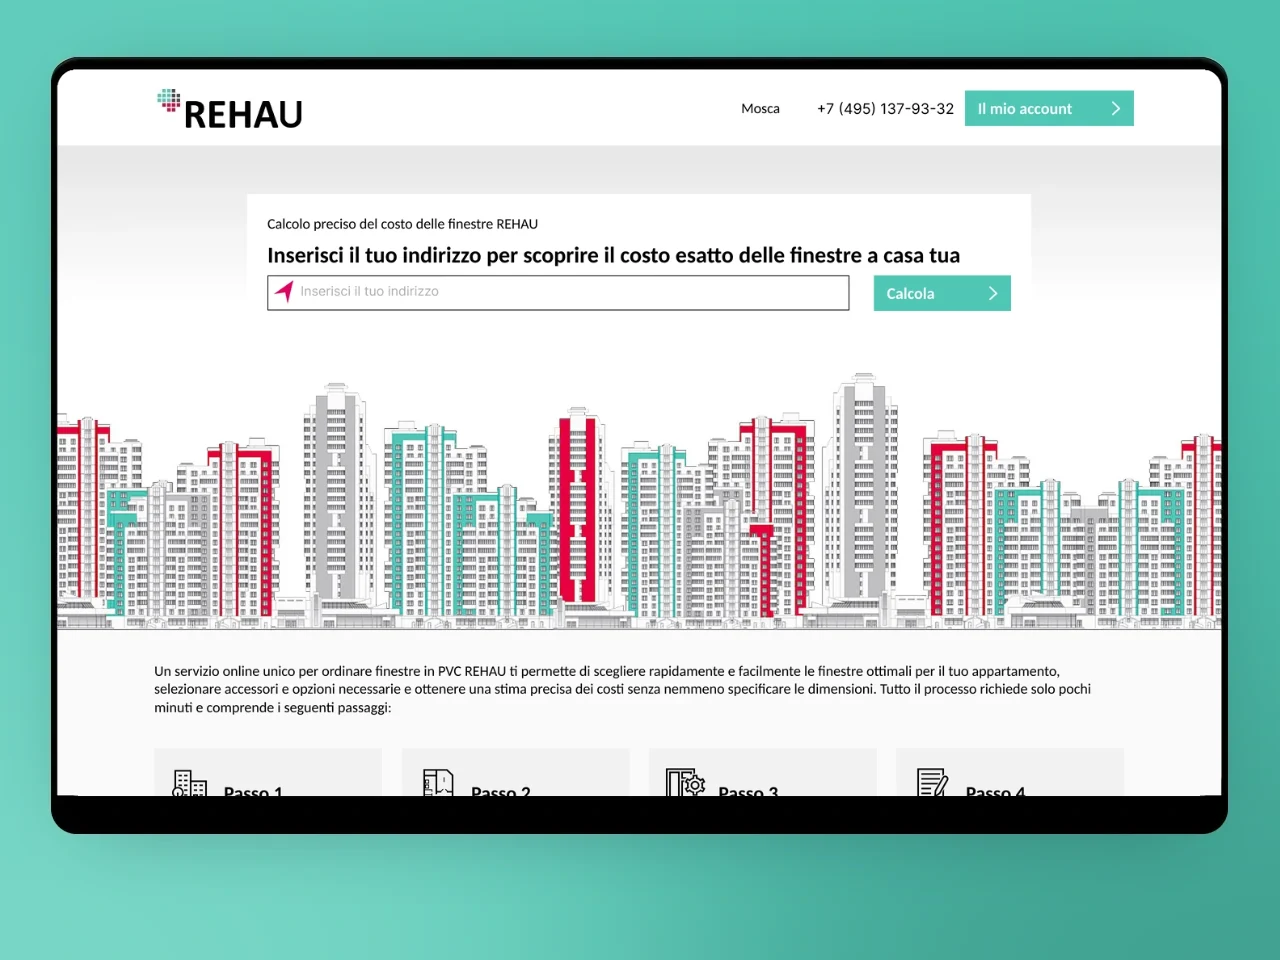
E-commerce B2B e configuratore di prodotto per un produttore globale di polimeri con prezzi multi-regione e workflow dealer.
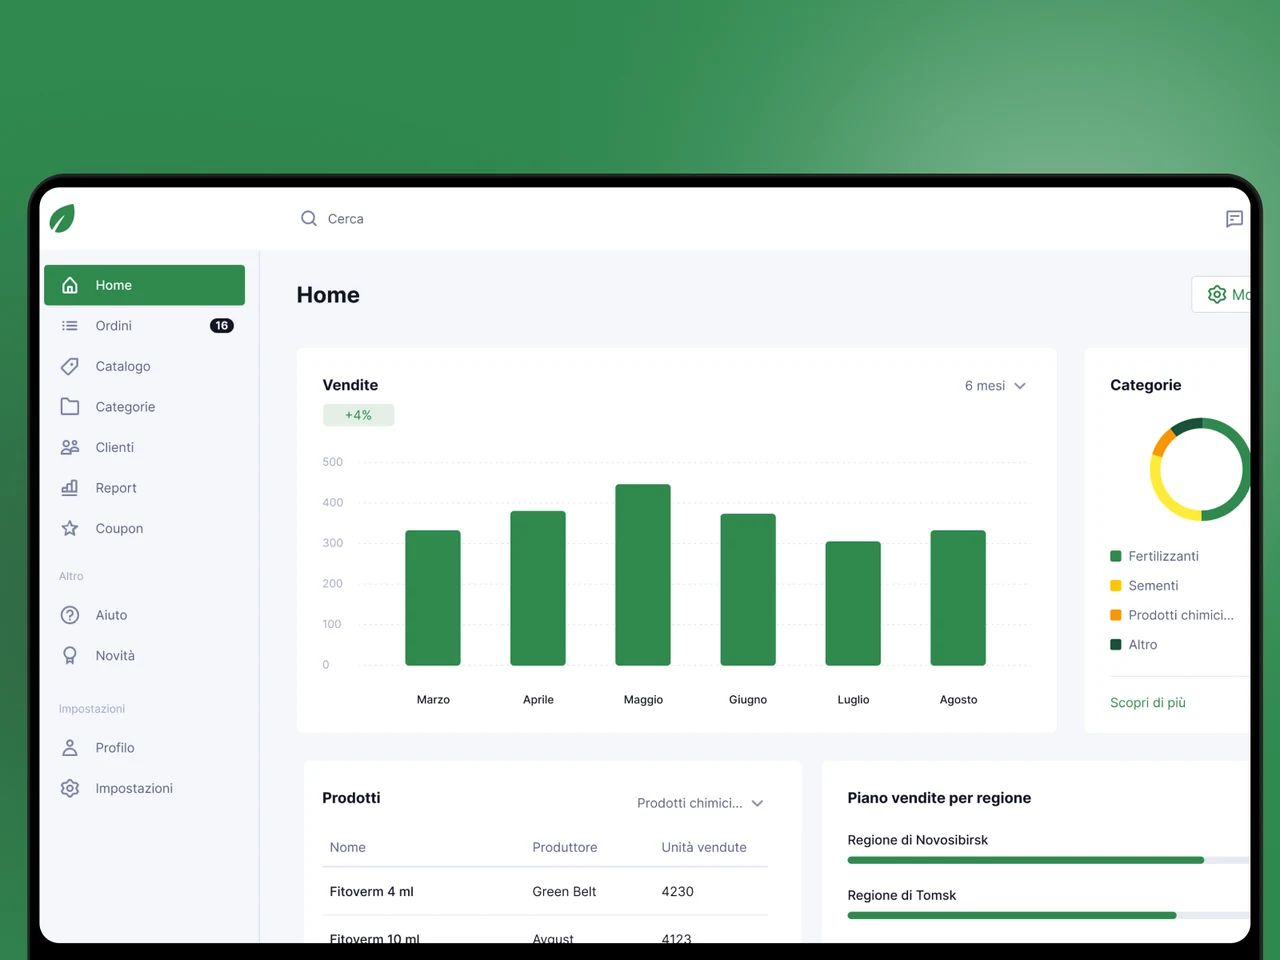
App di field sales offline-first per iOS e Android per un distributore agricolo — catalogo strutturato, reporting delle trattative, piano vs consuntivo.
Gestire appuntamenti e referti in più città su tre piattaforme è genuinamente complesso. YuSMP ha risolto un problema di integrazione legacy che avevamo evitato per due anni e ha rilasciato un'esperienza paziente che i nostri punteggi NPS hanno immediatamente rispecchiato.
Il commercio B2B per un brand di prodotti polimerici significa configuratori di prodotti complessi, livelli di prezzo per i dealer e flussi di ordini che gli acquirenti non tecnici devono navigare. YuSMP ha costruito una piattaforma che i nostri dealer hanno adottato senza una singola sessione di formazione. I volumi di ordini tramite il portale sono raddoppiati nel primo anno.
Un motore di decisione sui prestiti che impiega dieci volte meno tempo per approvare non avviene per caso. YuSMP ha costruito la pipeline di scoring, l’integrazione con i bureau del credito e un back-office che i nostri sottoscrittori apprezzano davvero. I tempi di approvazione sono passati da due giorni a meno di quattro ore.
Pubblichiamo decine di articoli sportivi al giorno. YuSMP ha costruito una pipeline editoriale usando un bot Telegram come CMS — i redattori pubblicano una volta sola, il contenuto arriva sul web, su iOS e su Android istantaneamente. L'architettura non richiede alcuna manutenzione quotidiana.
1 / 4
Si lavora con ingegneri che gestiscono Airflow con warehouse reali e dbt in produzione, non con generalisti che collegano il loro primo DAG.
Operiamo in orari sovrapposti con i team di dati statunitensi ed europei e costruiamo nel rispetto di GDPR, HIPAA e SOC 2 fin dal primo DAG.
DAG idempotenti, ottimizzazione dell’executor, sicurezza dei segreti, monitoraggio e CI/CD dei DAG sono inclusi di serie, così le vostre pipeline sono manutenibili, non fragili.
Domande frequenti
Airflow è lo standard maturo orientato al batch per l’orchestrazione pianificata dei dati, con l’ecosistema più ampio di operatori e opzioni gestite. Dagster e Prefect sono valide alternative moderne con un migliore sviluppo locale e modelli orientati agli asset e ai dati, mentre Temporal si rivolge a workflow applicativi durevoli piuttosto che a pipeline di dati. Consigliamo Airflow quando si ha necessità di ETL/ELT batch pianificato e affidabile con un’ampia libreria di operatori, e lo diciamo chiaramente quando uno degli altri strumenti si adatta meglio al vostro team.
Un DAG (Directed Acyclic Graph) è la definizione di una pipeline come codice Python — un insieme di task e le dipendenze tra loro, senza cicli. Gli operatori sono i mattoni che definiscono cosa fa ciascun task, come eseguire SQL, chiamare un’API o avviare un container, mentre i hook gestiscono le connessioni ai sistemi esterni. Insieme consentono di esprimere pipeline complesse e pianificate come codice versionato.
L’idempotenza significa che un task produce lo stesso risultato corretto sia che venga eseguito una volta sia che venga ritentato — fondamentale perché Airflow riprova i task falliti e si rieseguirà la storia. Progettiamo i task per sovrascrivere o fare upsert su una specifica partizione di data di esecuzione invece di accodare ciecamente, in modo che le riesecuzioni non duplichino né corrompano i dati. I backfill diventano così sicuri: è possibile riprodurre qualsiasi intervallo di date per caricare dati storici o recuperare da un incidente con fiducia.
L’executor Celery esegue i task su un pool di worker a lunga vita ed è efficiente per molti task brevi e frequenti con fabbisogni di risorse prevedibili. L’executor Kubernetes avvia un pod isolato per ogni task, garantendo risorse per task, isolamento delle dipendenze e scalabilità elastica fino a zero, al costo della latenza di avvio del pod. Scegliamo in base al profilo dei task e all’infrastruttura, e spesso li combiniamo in modo che i task pesanti o specializzati girino su Kubernetes mentre quelli di routine usino Celery.
Le opzioni gestite — AWS MWAA, Google Cloud Composer o Astronomer — eliminano il carico operativo di gestire lo scheduler, il database e i worker, e sono di solito la scelta giusta a meno che non vi siano requisiti specifici di controllo o di costo. L’auto-hosting su Kubernetes offre la massima flessibilità ma significa farsi carico di upgrade, scalabilità e disponibilità. Aiutiamo a valutare costi, conformità e capacità del team, quindi configuriamo o migriamo al modello più adatto.
Le credenziali non risiedono mai nel codice DAG né nelle connessioni Airflow in chiaro; integriamo un backend per i segreti come HashiCorp Vault o il secret manager cloud, con accesso limitato e rotazione. Per i dati personali teniamo i dati personali completamente fuori dai log dei task e da XCom — i task passano riferimenti e operano sui dati in loco all’interno del warehouse, con mascheramento su qualsiasi logging inevitabile. In questo modo le pipeline restano conformi a GDPR e HIPAA pur rimanendo analizzabili.
Airflow è uno scheduler batch, non un motore di streaming. Se si ha necessità di elaborazione in tempo reale o sub-minuto — stream di eventi, CDC continuo o reazioni a bassa latenza — si preferisce Kafka, Flink, Spark Streaming o un pattern di warehouse in streaming, con Airflow che orchestra facoltativamente i job batch circostanti. Diremo chiaramente quando i requisiti di latenza escludono Airflow invece di forzarne l’uso.
Diteci dove volete essere tra dodici mesi. Vi risponderemo con un piano per arrivarci.
Risposta entro 1 giorno lavorativo. NDA su richiesta.
Condividete alcuni dettagli e un consulente senior risponderà entro un giorno lavorativo.
Email: sales@yusmpgroup.com
Telefono: +374 44 871 811
Uffici: KAMAR Business Center, Vazgen Sargsyan St. 2, Erevan, Armenia · Remoto — sovrapposizione con la costa est degli Stati Uniti (9:00–13:00 ET)