Blog News Contatti Richiedi una proposta

Sviluppo BigQuery che trasforma l'analisi serverless in costi prevedibili e velocità

Realizziamo e ottimizziamo warehouse Google BigQuery per team di prodotto, finanza e analytics negli Stati Uniti e in Europa. Dal design dei dataset e il partitioning alle prenotazioni di slot, pipeline dbt e BigQuery ML, rendiamo l'analisi a scala petabyte veloce senza fatture fuori controllo. Ogni progetto viene consegnato con residenza conforme al GDPR, governance e chiare misure di protezione dei costi.

  • BigQuery
  • partitioning & clustering
  • BigQuery ML
  • query pianificate

Realizziamo e ottimizziamo warehouse Google BigQuery per team di prodotto, finanza e analytics negli Stati Uniti e in Europa. Dal design dei dataset e il partitioning alle prenotazioni di slot, pipeline dbt e BigQuery ML, rendiamo l'analisi a scala petabyte veloce senza fatture fuori controllo. Ogni progetto viene consegnato con residenza conforme al GDPR, governance e chiare misure di protezione dei costi.

Sfide del settore che affrontiamo

Modello di costo imprevedibile

La tariffazione on-demand addebita per byte scansionati, quindi una singola query non ottimizzata su una tabella ampia può costare più di un mese di compute. Senza slot o edizioni, la spesa è difficile da prevedere e da limitare.
Progettazione del partitioning e clustering

Scegliere la colonna di partizione sbagliata — o fare clustering su campi a bassa cardinalità — significa che le query continuano a scansionare intere tabelle. Un design fisico errato aumenta silenziosamente latenza e costi.

Ottimizzazione delle query

SELECT * su un columnar store legge ogni colonna e addebita tutto. I team scansionano abitualmente terabyte quando una query pruned e filtrata per partizione ne scansionnerebbe gigabyte.

Streaming insert e deduplicazione

La streaming API consegna righe a bassa latenza ma con semantica at-least-once, quindi duplicati e un buffer non immediatamente interrogabile per le cancellazioni richiedono una gestione esplicita.

Posizione del dataset e residenza

La regione di un dataset è fissa al momento della creazione — non è possibile spostarla. Sbagliare la residenza UE significa un costoso export, ricreazione e ricaricamento per correggerla in seguito.

Cancellazione GDPR su tabelle partizionate

Cancellare un singolo soggetto su grandi tabelle partizionate implica DML mirato e riscritture a livello di partizione, che devono essere progettate in anticipo o le cancellazioni diventano lente e costose.

Soluzioni che realizziamo

Progettazione warehouse e dataset

Modelliamo i dataset, scegliamo le chiavi di partition (data/ingestione/range intero) e clustering in base ai pattern reali delle query, e definiamo residenza e retention fin dal primo giorno.

Ottimizzazione dei costi

Scegliamo il modello di fatturazione corretto — on-demand, slot o prenotazioni per edizione — ottimizziamo le query per la riduzione delle partizioni e aggiungiamo budget, limiti di byte e dashboard dei costi.

Pipeline ELT

Realizziamo trasformazioni manutenibili in dbt o Dataform con test, lineage e CI, sostituendo SQL scritto a mano e fragile con modelli versionati e documentati.

Ingestione in streaming

Configuriamo pipeline Pub/Sub → Dataflow → BigQuery con deduplicazione, evoluzione degli schemi e pattern exactly-once per analytics in tempo reale che rimangono pulite.

BigQuery ML

Addestriamo e serviamo modelli di previsione, classificazione e clustering in SQL con BigQuery ML, mantenendo i dati in sede ed evitando infrastrutture ML aggiuntive.

Governance e residenza

Applichiamo sicurezza a livello di colonna e riga, policy tag, IAM a minimo privilegio e ancoraggio regionale affinché i dati sensibili rimangano governati e conformi.

Stack tecnologico

  • BigQuery
  • partitioning & clustering
  • BigQuery ML
  • query pianificate
  • dbt
  • Dataform
  • Dataflow
  • streaming Pub/Sub
  • Looker e Terraform

Conformità e normative

GDPR · Residenza dati UE · Pronto per HIPAA · SOC 2

UE

  • GDPR — posizione del dataset in multi-region UE, sicurezza a livello di colonna sui campi personali e retention consapevole delle partizioni affinché i dati vengano eliminati secondo un piano definito.
  • EU AI Act — utilizzo di BigQuery ML e dei modelli a valle documentato con lineage dei dati, provenienza delle feature e classificazione del rischio per l'analisi in perimetro.
  • eIDAS — tracce di identità e accesso verificabili tramite Cloud IAM e audit log BigQuery per supportare un'elaborazione dati affidabile e attribuibile.
  • NIS2 — controlli di accesso rafforzati, logging e monitoraggio pronto per gli incidenti su tutti i dataset per le organizzazioni in perimetro della direttiva.

US

  • HIPAA — deployment sotto un Google Cloud BAA con BigQuery come servizio coperto, cifratura, access logging e IAM a minimo privilegio per workload PHI.
  • PCI DSS — dataset segmentati, dati della carta tokenizzati e accesso alle query strettamente limitato affinché l'analisi non tocchi mai i dati grezzi dei titolari di carta.
  • SOC 2 — controlli per sicurezza, disponibilità e riservatezza, con audit log, change management e revisioni degli accessi documentate.
  • CCPA/CPRA — inventario dei dati dei consumatori, flussi di cancellazione e opt-out mappati sulle tabelle BigQuery e sulle esportazioni downstream.

Cosa dicono i clienti

“
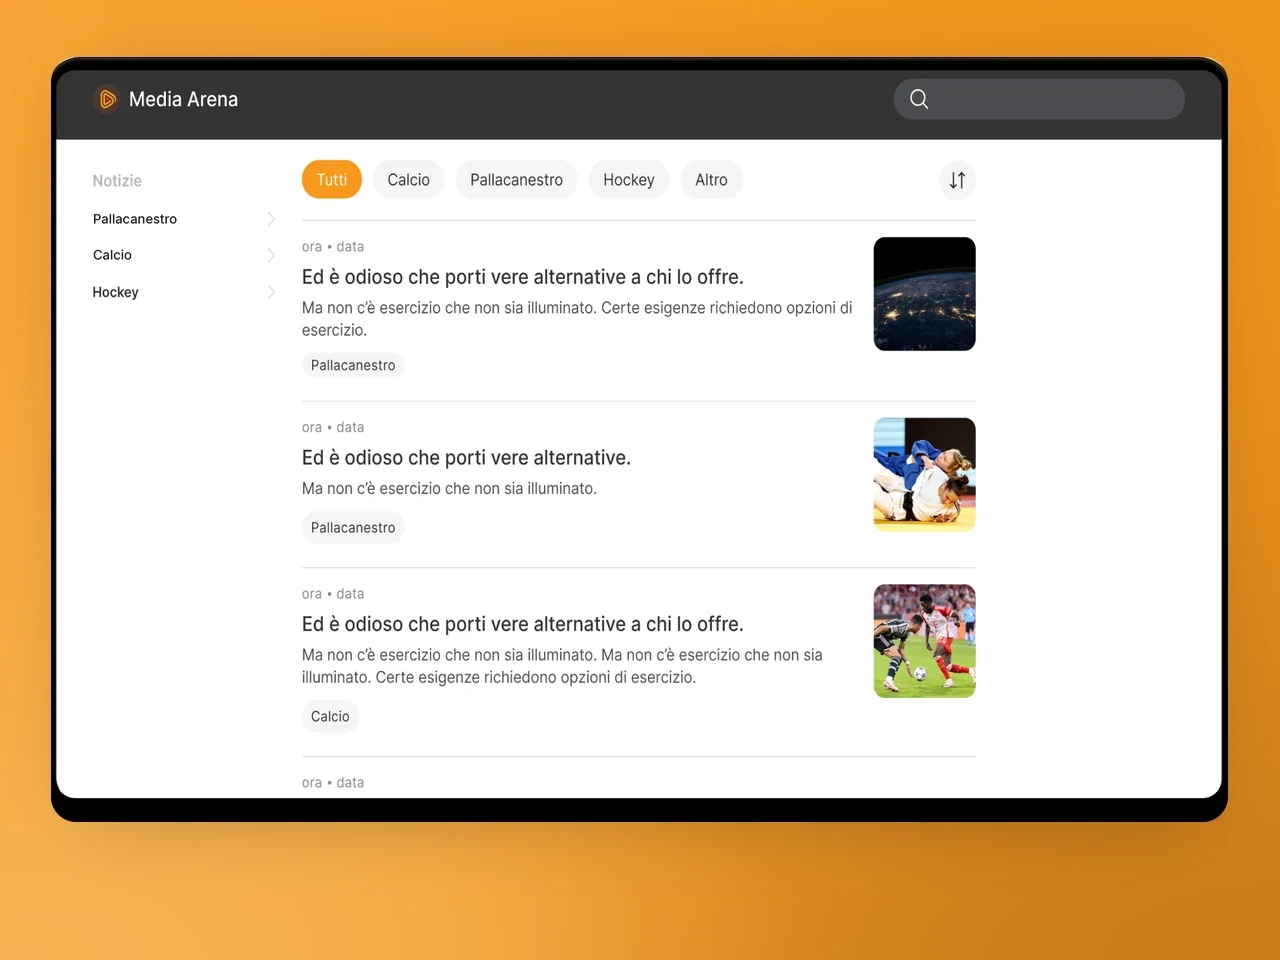
Pubblichiamo decine di articoli sportivi al giorno. YuSMP ha costruito una pipeline editoriale usando un bot Telegram come CMS — i redattori pubblicano una volta sola, il contenuto arriva sul web, su iOS e su Android istantaneamente. L'architettura non richiede alcuna manutenzione quotidiana.
Ryan O'ConnorCEO, Media Arena
Vedi il caso →
“
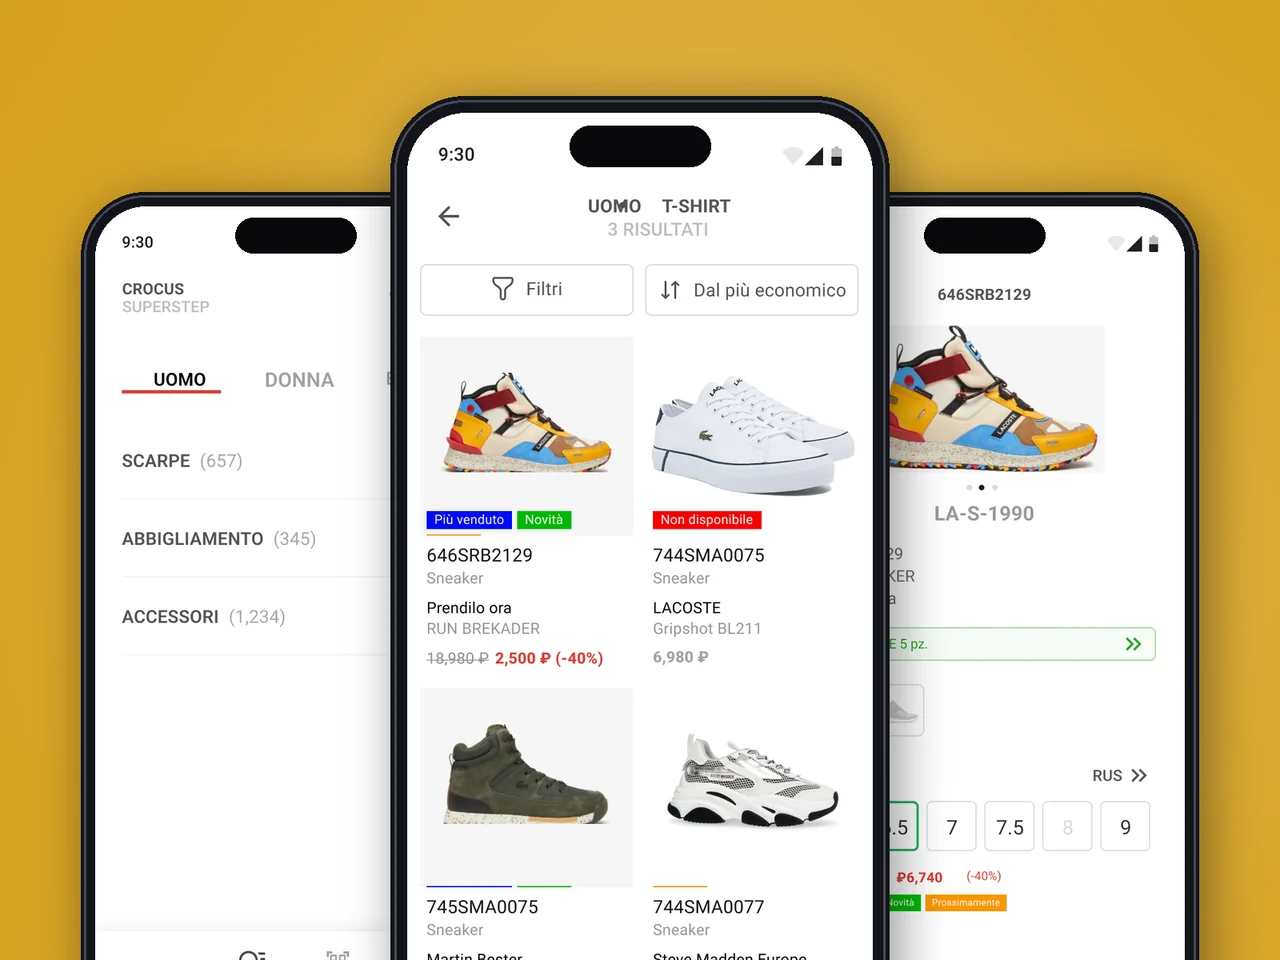
I nostri consulenti perdevano 15 minuti per cliente nei controlli manuali dell'inventario. YuSMP ha sviluppato app native basate su ElasticSearch, collegate al nostro sistema 1C in tempo reale. Il tempo per cliente è diminuito del 40% in tutte le sedi entro una settimana dal lancio.
Elena FischerCTO, SuperStep
Vedi il caso →
“
Un motore di decisione sui prestiti che impiega dieci volte meno tempo per approvare non avviene per caso. YuSMP ha costruito la pipeline di scoring, l’integrazione con i bureau del credito e un back-office che i nostri sottoscrittori apprezzano davvero. I tempi di approvazione sono passati da due giorni a meno di quattro ore.
Gregory LawsonCTO, LoanFlow
Vedi il caso →
“
Il self-service telecom è utile solo se i clienti lo preferiscono davvero al supporto telefonico. YuSMP ha sviluppato app iOS e Android con gestione del saldo, cambio del piano e analisi dell’utilizzo che hanno ridotto il volume del nostro call center del 30% nel primo trimestre dopo il lancio.
Charles DuboisDirector of Digital Products, TelecomSelf
Vedi il caso →

1 / 4

Perché i team data scelgono YuSMP per lo sviluppo BigQuery

Disciplina dei costi integrata

Trattiamo i byte scansionati come un budget. Ogni warehouse viene consegnato con partition pruning, dimensionamento di slot o edizione e dashboard affinché la finanza veda una spesa prevedibile e spiegabile.

Profondità in data engineering

Ingegneri senior che progettano layout fisici, ELT e streaming end-to-end — non solo autori SQL — affinché il warehouse scala con la crescita dei dati.

Consegna compliance-first

La residenza GDPR, il perimetro del BAA HIPAA e i controlli SOC 2 sono progettati fin dal primo dataset, non aggiunti sotto pressione di audit.

FAQ

Domande frequenti su BigQuery

Come si confronta BigQuery con Snowflake o Redshift?

BigQuery è completamente serverless, senza cluster da dimensionare o mettere in pausa: storage e compute scalano indipendentemente e si paga per byte scansionati o per slot riservati. Snowflake offre una separazione simile ma con virtual warehouse espliciti da avviare e fermare, mentre Redshift si orienta verso cluster provisioned (o serverless) strettamente legati ad AWS. Aiutiamo i team a scegliere in base all'impronta cloud, ai pattern di query e al modello di costo, non alle tendenze del momento.

Come funzionano i costi di BigQuery e come si controllano?

La fatturazione on-demand addebita per terabyte scansionati, quindi il costo dipende dalla quantità di dati letti da ogni query, non dalla durata. Le edizioni e le prenotazioni di slot passano a una tariffazione prevedibile basata sulla capacità. Controlliamo la spesa con pruning di partizioni e cluster, guardrail sui byte-limit, viste materializzate, quote personalizzate e dashboard dei costi, così non ci sono fatture a sorpresa.

Qual è la differenza tra partitioning e clustering?

Il partitioning divide fisicamente una tabella per colonna — di solito una data o un tempo di ingestione — in modo che le query con un filtro su quella colonna scansionino solo le partizioni rilevanti. Il clustering ordina i dati all'interno delle partizioni per un massimo di quattro colonne, riducendo ulteriormente i byte scansionati per query filtrate o aggregate. Sono complementari: prima il partition per la riduzione grossolana, poi il cluster sui campi filtrati o raggruppati più frequentemente.

Conviene usare streaming insert o batch load?

I batch load sono gratuiti, ideali per ELT pianificato e grandi volumi, e garantiscono semantica exactly-once. Gli streaming insert (o la Storage Write API) consegnano righe in pochi secondi per dashboard in tempo reale ma costano di più e richiedono la gestione dei duplicati. Raccomandiamo tipicamente il batch per l'analisi e lo streaming solo dove una latenza genuinamente inferiore al minuto crea valore di business.

Cosa si può fare con BigQuery ML?

BigQuery ML permette di addestrare ed eseguire modelli — regressione lineare e logistica, previsione di serie temporali, clustering, boosted tree e altro — direttamente in SQL, con i dati che non lasciano mai il warehouse. È eccellente per previsioni, churn e segmentazione quando si desiderano risultati rapidi senza allestire un'infrastruttura ML separata. Per il deep learning o il servizio a bassa latenza integriamo invece Vertex AI.

BigQuery può soddisfare i nostri requisiti di residenza dati e HIPAA?

Sì. Un dataset viene ancorato a una multi-region UE o a una regione specifica al momento della creazione per mantenere i dati in giurisdizione, e la regione non può essere cambiata in seguito, quindi lo progettiamo correttamente fin dall'inizio. BigQuery è un servizio coperto dal BAA di Google Cloud, quindi con il giusto IAM, cifratura e logging supporta workload HIPAA insieme ai requisiti di residenza GDPR.

Quando BigQuery è la scelta sbagliata?

BigQuery è progettato per workload analitici ad alta intensità di append, non transazionali: è inadatto per letture, aggiornamenti e cancellazioni frequenti su singola riga che un database OLTP come Postgres o Cloud SQL gestisce meglio. Per dataset molto piccoli, l'overhead serverless e il modello per-query raramente battono un semplice database gestito. Quando un warehouse è eccessivo, lo diciamo apertamente.

Pronti a rendere BigQuery veloce, governato e prevedibile?

Diteci dove volete essere tra dodici mesi. Vi risponderemo con un piano per arrivarci.

Richiedi una proposta

Risposta entro 1 giorno lavorativo. NDA su richiesta.

Richiedi una proposta

Condividete alcuni dettagli e un consulente senior risponderà entro un giorno lavorativo.

Stima del progetto gratuita — ti inviamo un piano entro 1–2 giorni lavorativi.
  • Analisi dei requisiti e consigli sullo stack tecnologico
  • Stima di tempi, budget e composizione del team
  • Senza impegno — solo un piano chiaro

Email: sales@yusmpgroup.com

Telefono: +374 44 871 811

Uffici: KAMAR Business Center, Vazgen Sargsyan St. 2, Erevan, Armenia · Remoto — sovrapposizione con la costa est degli Stati Uniti (9:00–13:00 ET)

— campi obbligatori