Blog News Contatti Richiedi una proposta

Sviluppo Hugging Face che trasforma i modelli open in AI di produzione sotto il vostro controllo

Costruiamo AI di produzione sullo stack Hugging Face per team USA e UE — dalla selezione e valutazione dei modelli al fine-tuning PEFT/LoRA, RAG e Text Generation Inference self-hosted. I nostri ingegneri sanno quando un modello open-weights supera un'API chiusa, come fare fine-tuning senza esporre i vostri dati e come renderlo economico sui vostri GPU o su Inference Endpoints. Ogni deployment è governato, documentato con model card e costruito per soddisfare GDPR, AI Act UE e framework USA come NIST AI RMF e SOC 2.

  • Transformers
  • Datasets
  • PEFT/LoRA
  • TGI

Costruiamo AI di produzione sullo stack Hugging Face per team USA e UE — dalla selezione e valutazione dei modelli al fine-tuning PEFT/LoRA, RAG e Text Generation Inference self-hosted. I nostri ingegneri sanno quando un modello open-weights supera un'API chiusa, come fare fine-tuning senza esporre i vostri dati e come renderlo economico sui vostri GPU o su Inference Endpoints. Ogni deployment è governato, documentato con model card e costruito per soddisfare GDPR, AI Act UE e framework USA come NIST AI RMF e SOC 2.

Sfide del settore che risolviamo

Selezione dei modelli e licenze

L'Hub ospita centinaia di migliaia di modelli con qualità, dimensioni e condizioni di licenza molto diverse. Scegliere quello adatto al task, al budget hardware e ai diritti di uso commerciale — senza violare clausole RAIL restrittive o non commerciali — è più difficile di quanto sembri.
Fine-tuning: PEFT/LoRA vs completo

Il fine-tuning completo è costoso e richiede molto storage; PEFT/LoRA è più economico ma richiede il rango corretto, i moduli target e la strategia di merge giusta. Una scelta errata spreca budget GPU o lascia il modello insufficientemente adattato al dominio.

Self-host vs Inference Endpoints

Eseguire TGI sui propri GPU offre controllo e residenza dei dati ma aggiunge oneri operativi; gli Inference Endpoints gestiti sono più semplici ma costano di più a scala. Il punto di pareggio dipende dal traffico, dagli obiettivi di latenza e dalle esigenze di conformità.

Costo e utilizzo dei GPU

GPU inattivi, istanze sovradimensionate e richieste non aggregate bruciano rapidamente il budget. Senza quantizzazione, batching e autoscaling, il costo di inferenza per token aumenta e la capacità rimane inutilizzata tra i picchi di traffico.

Valutazione e allucinazioni

I modelli open allucinano e subiscono derive come qualsiasi LLM, e i test basati su impressioni soggettive nascondono le regressioni. Senza set di valutazione task-specifici, grounding e guardrail, i problemi di qualità arrivano in produzione inosservati.

Privacy dei dati nei set di fine-tuning

I dati di addestramento contengono spesso dati personali, secret o testi protetti da copyright che poi si incorporano nei pesi. Pulire, ottenere il consenso e documentare quei dati è essenziale per restare conformi al GDPR e alle licenze.

Soluzioni che realizziamo

Selezione e valutazione dei modelli

Valutiamo i modelli candidati sui vostri task e hardware reali, verifichiamo le licenze e la provenienza, e raccomandiamo il modello più compatto che soddisfa gli obiettivi di qualità — con un set di valutazione documentato che potete rieseguire al variare dei modelli.

Fine-tuning PEFT/LoRA

Effettuiamo il fine-tuning in modo efficiente con LoRA/QLoRA — ottimizzando rango, moduli target e schedule di apprendimento — su dataset puliti e governati, poi effettuiamo il merge o serviamo gli adapter per ottenere qualità di dominio senza il costo del modello completo.

Serving TGI self-hosted

Distribuiamo Text Generation Inference in Docker sui vostri GPU con continuous batching, tensor parallelism e quantizzazione, esponendo un'API compatibile OpenAI che mantiene i dati all'interno del vostro perimetro.

Integrazione RAG

Ancoraggiamo i modelli alla vostra conoscenza con pipeline di retrieval — embedding, ricerca vettoriale e reranking — affinché le risposte citino fonti reali e le allucinazioni si riducano senza riaddestrare il modello base.

MLOps e monitoraggio

Avvolgiamo i modelli in pipeline riproducibili con pesi versionati, gate di valutazione automatizzati, autoscaling e monitoraggio dell'inferenza — tracciando latenza, costo per token, deriva e qualità in produzione.

Governance e model card

Documentiamo ogni modello con una model card, registriamo la provenienza e le licenze dei dataset, e integriamo lo screening dei dati personali e la gestione della cancellazione nella pipeline dati affinché i controlli AI Act, GDPR e SOC 2 siano di routine.

Stack tecnologico

  • Transformers
  • Datasets
  • PEFT/LoRA
  • TGI
  • Inference Endpoints
  • Accelerate
  • Tokenizers
  • PyTorch
  • ONNX
  • Docker

Conformità & normative

AI Act UE · GDPR · governance modelli/dati · SOC 2

UE

  • AI Act UE — obblighi di trasparenza soddisfatti con model card documentate, provenienza dei dati di addestramento e dichiarazioni d'uso previsto, affinché il livello di rischio e gli obblighi di comunicazione di ogni modello siano verificabili.
  • GDPR — screening e pseudonimizzazione dei dati personali nei dataset di fine-tuning, base giuridica documentata per l'addestramento e workflow di cancellazione che tengono conto dei dati incorporati nei pesi del modello.
  • Licenze open-weights e provenienza — verifichiamo la licenza di ogni modello e dataset (Apache-2.0, MIT, Llama, Gemma, RAIL personalizzate) e registriamo la provenienza affinché il vostro utilizzo sia contrattualmente pulito e riproducibile.
  • NIS2 — serving del modello privato senza endpoint pubblici, secret in vault, logging degli accessi e tracce di audit pronte per la risposta agli incidenti per i doveri di sicurezza degli enti essenziali.

USA

  • NIST AI RMF — mappiamo i vostri modelli alle funzioni govern/map/measure/manage, con valutazione documentata, test di bias e prove di monitoraggio continuativo.
  • HIPAA — dove sono coinvolti dati sanitari protetti (PHI), modelli e dati di fine-tuning rimangono all'interno di un perimetro governato e coperto da BAA, con cifratura, accesso con privilegi minimi e nessun PHI in prompt o log.
  • SOC 2 — controllo delle modifiche alle versioni dei modelli, revisioni degli accessi e monitoraggio degli endpoint di inferenza allineati ai criteri di sicurezza, disponibilità e riservatezza.
  • CCPA/CPRA — inventario dei dati dei consumatori nei training set, gestione della cancellazione e dell'opt-out, e tagging affinché i dati personali usati nel fine-tuning siano localizzabili e rimovibili.

Cosa dicono i clienti

“
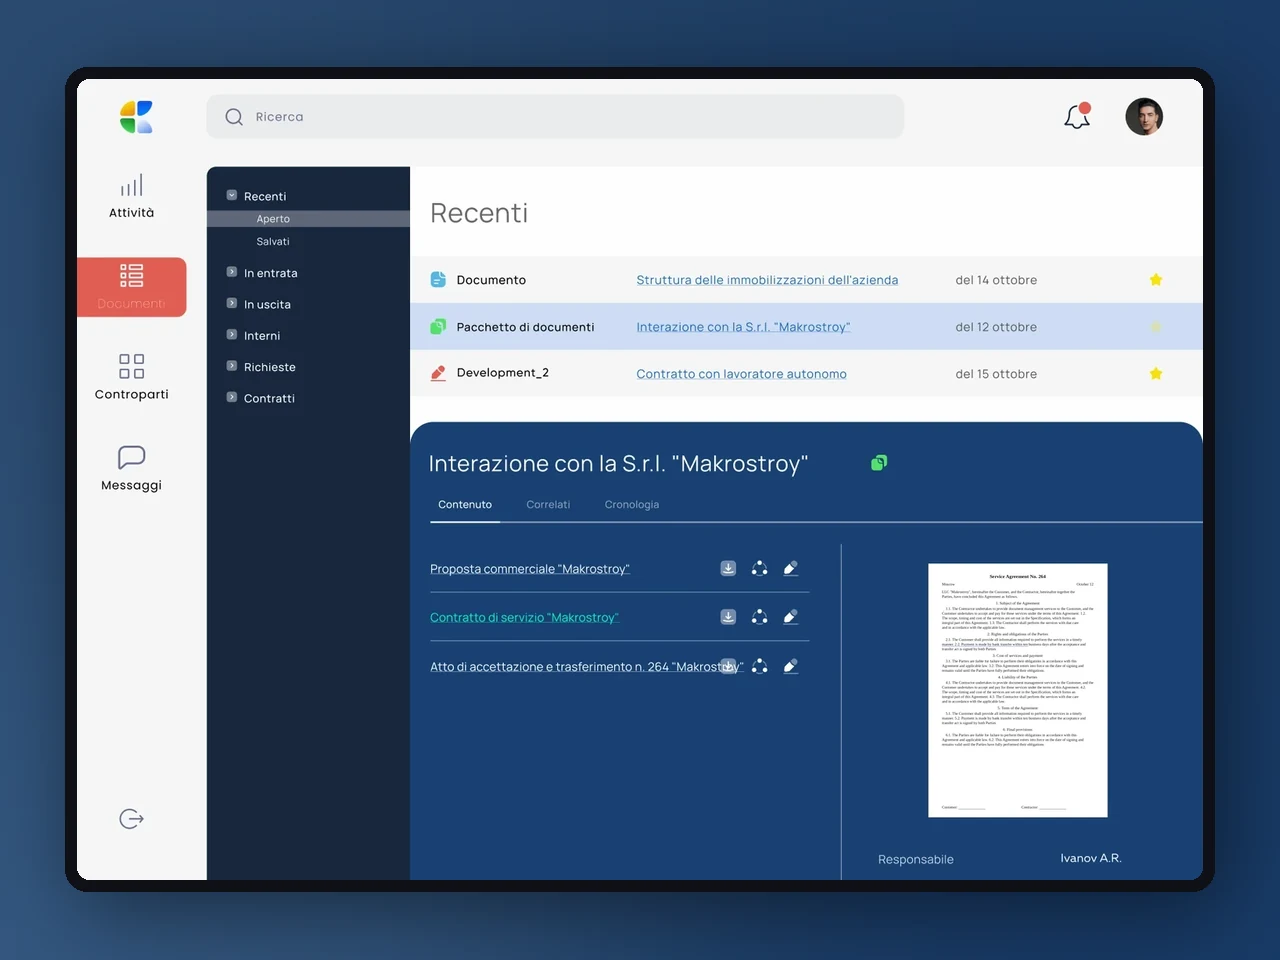
Una catena retail con decine di punti vendita ha bisogno di flussi di lavoro documentali che il personale non tecnico possa seguire senza formazione. YuSMP ha sviluppato un DMS interno con catene di approvazione, versioning e accesso basato sui ruoli che il nostro responsabile della compliance ha definito il sistema più ordinato che abbiamo mai distribuito.
Sandra HoffmannIT Director, RetailDocs
Vedi il caso →
“
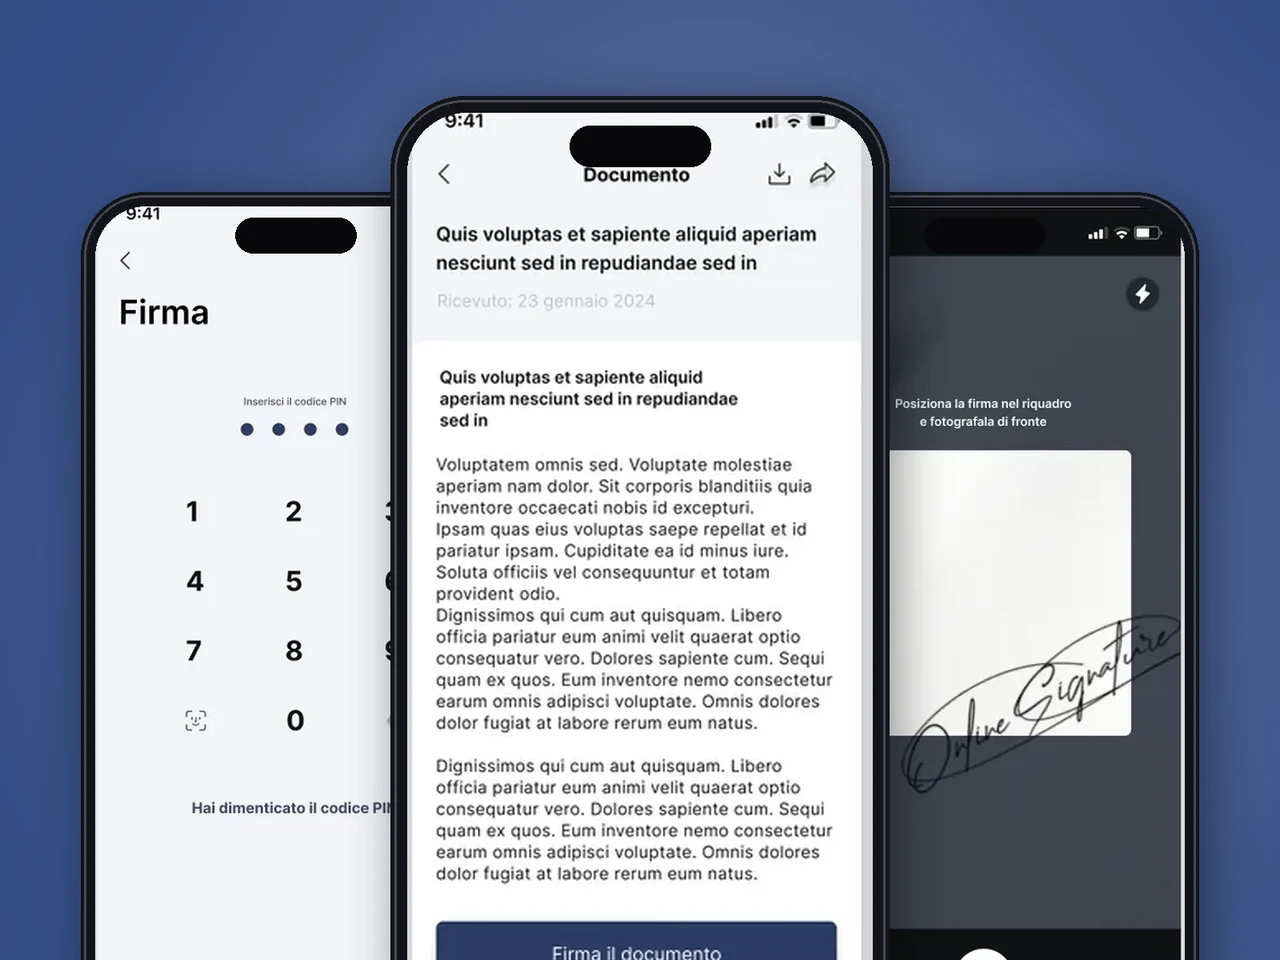
La firma elettronica di documenti da remoto è un campo minato dal punto di vista legale. YuSMP ha realizzato sia il flusso di firma mobile che il CRM Symfony in un unico ingaggio, ha gestito l'onboarding KYC e ha consegnato una documentazione API che il nostro team di compliance ha approvato in pochi giorni.
David MercerCEO, Signatory Pro
Vedi il caso →
“
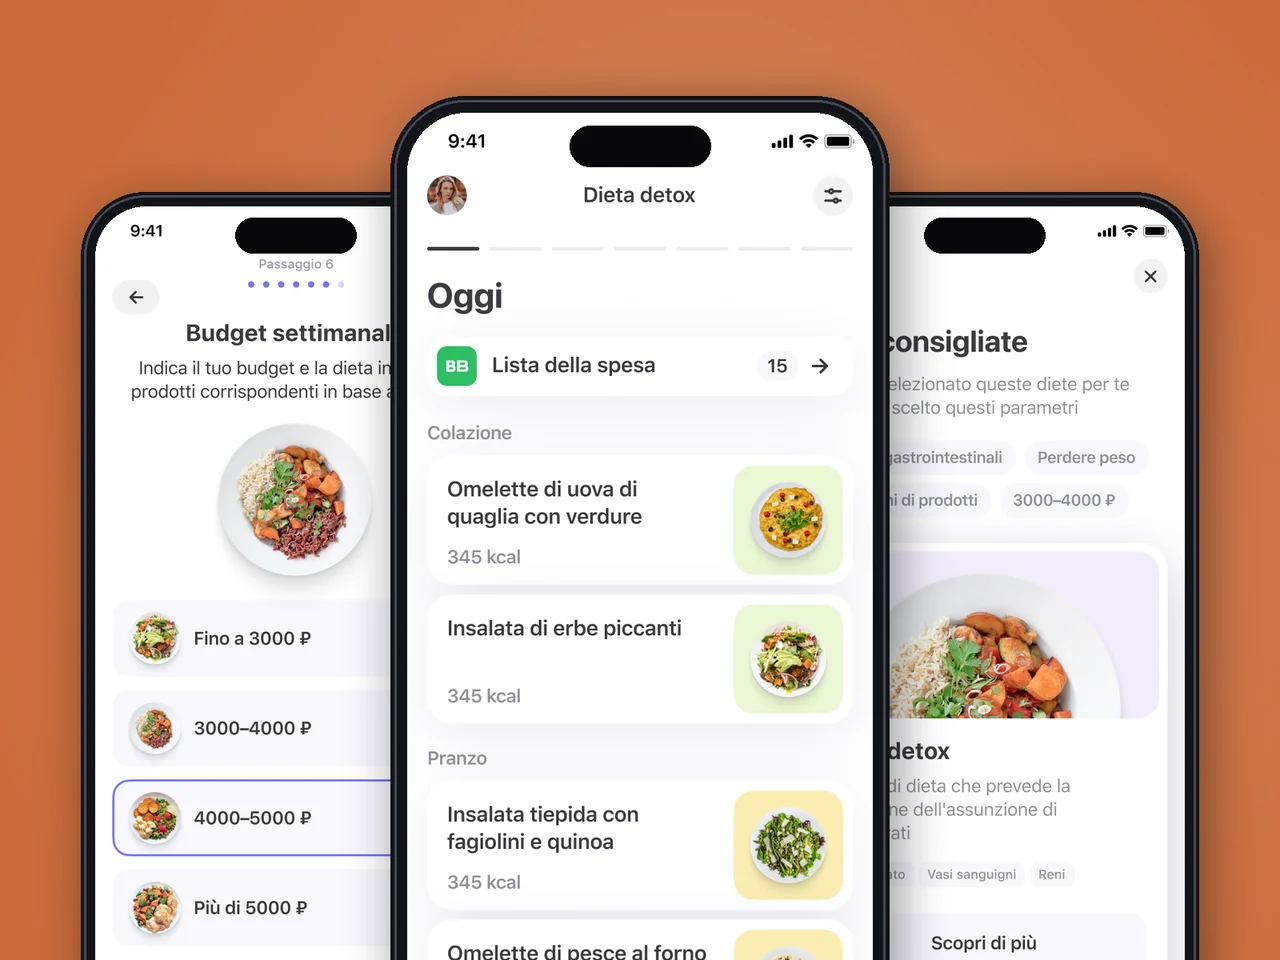
Avevamo un'idea e tempistiche stringenti. YuSMP ha trasformato uno scheletro Flutter in un'app per la nutrizione pronta per la produzione con motore calorico, piani alimentari e abbonamenti App Store in quattro mesi. La retention a 90 giorni ha superato il nostro benchmark del 30%.
Sophie LaurentCPO, BasilDoc
Vedi il caso →
“
Un motore di decisione sui prestiti che impiega dieci volte meno tempo per approvare non avviene per caso. YuSMP ha costruito la pipeline di scoring, l’integrazione con i bureau del credito e un back-office che i nostri sottoscrittori apprezzano davvero. I tempi di approvazione sono passati da due giorni a meno di quattro ore.
Gregory LawsonCTO, LoanFlow
Vedi il caso →

1 / 4

Perché i team scelgono YuSMP per lo sviluppo Hugging Face

Ingegneri ML applicato, non sperimentatori di prompt

Lavorate con ingegneri che fanno fine-tuning, quantizzano e servono modelli open in produzione — che sanno quando un LoRA da 7B supera un'API frontier e come dimostrarlo sui vostri dati.

Costi e latenza che potete giustificare

Dimensioniamo i GPU, effettuiamo batching e quantizzazione in modo deliberato e strumentiamo il costo per token e la latenza fin dal primo giorno — affinché la spesa di inferenza sia prevedibile e visibile al team finanziario.

Costruito per la conformità USA & UE

Manteniamo modelli e dati nella regione corretta, documentiamo model card e provenienza, e integriamo i controlli GDPR, AI Act UE, NIST AI RMF e SOC 2 dall'inizio, non come aggiunta tardiva.

FAQ

Domande frequenti su Hugging Face

Quando conviene usare i modelli open di Hugging Face invece di un'API chiusa come OpenAI o Anthropic?

I modelli open su Hugging Face sono preferibili quando si necessita di residenza dei dati, costi prevedibili ad alto volume, pieno controllo sui pesi e sul comportamento, oppure di deployment in ambienti air-gapped o regolamentati. Le API chiuse restano leader in termini di capacità frontier assoluta e comodità zero-ops. Valutiamo entrambe le opzioni sui vostri task reali e spesso adottiamo un approccio ibrido — un modello open per carichi ad alto volume o sensibili e un'API chiusa dove la qualità massima è prioritaria.

Conviene fare il fine-tuning di un modello o usare RAG?

Risolvono problemi diversi. RAG inietta conoscenza aggiornata o proprietaria al momento della query ed è la prima mossa giusta quando il problema è che il modello non conosce i vostri dati. Il fine-tuning modifica comportamento, tono, formato o abilità sui task, ed è adatto ai casi in cui prompting e retrieval non ottengono lo stile o la struttura desiderata. Si combinano bene — spesso facciamo fine-tuning per il comportamento e usiamo RAG per la conoscenza.

Cosa sono PEFT e LoRA, e perché sono importanti?

PEFT (parameter-efficient fine-tuning) adatta un modello addestrando un piccolo set di parametri aggiuntivi invece di tutti i suoi pesi. LoRA, il metodo più diffuso, inietta matrici adapter a basso rango — si fa il fine-tuning di qualche milione di parametri invece di miliardi, su un'unica GPU, in ore anziché giorni. QLoRA va oltre quantizzando il modello base durante l'addestramento. Il risultato è un costo GPU notevolmente ridotto e file adapter piccoli che si possono scambiare per cliente o task.

Conviene fare self-hosting con TGI o usare gli Inference Endpoints?

Gli Inference Endpoints sono più economici e veloci da avviare quando il traffico è basso o irregolare — si paga una capacità gestita con autoscaling senza oneri operativi. Il self-hosting di Text Generation Inference sulle proprie GPU conviene a volumi alti e sostenuti e offre piena residenza dei dati e controllo, ma la gestione operativa è a vostro carico. Modelliamo il vostro traffico atteso e gli obiettivi di latenza per trovare il punto di pareggio, e spesso iniziamo con la soluzione gestita per poi migrare al self-hosted al crescere dei volumi.

Come funzionano le licenze dei modelli open-weights — possiamo usarli commercialmente?

Dipende dal modello. Molti (Apache-2.0, MIT) consentono un uso commerciale illimitato; altri (Llama, Gemma) prevedono condizioni d'uso accettabile e di scala; alcuni modelli di ricerca usano licenze non commerciali o RAIL che limitano il deployment. Verifichiamo la licenza di ogni modello e dataset adottato, registriamo la provenienza e vi indirizziamo verso opzioni contrattualmente pulite per il vostro caso d'uso — così non siete esposti in seguito.

Come proteggete la privacy dei dati durante il fine-tuning?

Qualsiasi elemento nel training set può finire incorporato nei pesi del modello, perciò trattiamo il dataset come sensibile fin dall'inizio. Identifichiamo e pseudonimizziamo i dati personali, rimuoviamo secret e contenuti fuori licenza, documentiamo la base giuridica ai sensi del GDPR e manteniamo l'intera pipeline all'interno di un perimetro governato e conforme alla regione. Dove si applicano obblighi di cancellazione, pianifichiamo il retraining o l'unlearning piuttosto che assumere che i pesi possano essere modificati a posteriori.

L'AI Act UE si applica se facciamo self-hosting di modelli open?

Sì — l'AI Act si applica a come un sistema viene distribuito e utilizzato, non a quale API si chiama, quindi fare self-hosting di un modello open non esenta dall'obbligo. In qualità di deployer si è comunque soggetti a obblighi di trasparenza, documentazione e classificazione del rischio, e per gli utilizzi ad alto rischio anche a doveri di valutazione e supervisione umana. Documentiamo i model card, la provenienza dei dati di addestramento e l'uso previsto, e costruiamo le prove di logging e valutazione che rendono il vostro deployment verificabile.

Pronti a mettere i modelli open in produzione senza perdere il controllo dei vostri dati?

Diteci dove volete essere tra dodici mesi. Vi risponderemo con un piano per arrivarci.

Richiedi una proposta

Risposta entro 1 giorno lavorativo. NDA su richiesta.

Richiedi una proposta

Condividete alcuni dettagli e un consulente senior risponderà entro un giorno lavorativo.

Stima del progetto gratuita — ti inviamo un piano entro 1–2 giorni lavorativi.
  • Analisi dei requisiti e consigli sullo stack tecnologico
  • Stima di tempi, budget e composizione del team
  • Senza impegno — solo un piano chiaro

Email: sales@yusmpgroup.com

Telefono: +374 44 871 811

Uffici: KAMAR Business Center, Vazgen Sargsyan St. 2, Erevan, Armenia · Remoto — sovrapposizione con la costa est degli Stati Uniti (9:00–13:00 ET)

— campi obbligatori