L’essentiel
Trois des chatbots IA les plus utilisés – ChatGPT, Claude et Grok – sont tombés en panne dans la même fenêtre le 3 septembre 2026, pendant environ trois heures, principalement à cause d’une défaillance régionale de Microsoft Azure East US. Downdetector a recensé plus de 37 000 signalements pour ChatGPT à lui seul. La leçon n’est pas qu’un fournisseur serait peu fiable ; c’est que la concentration sur un cloud partagé rend possibles des pannes corrélées, alors que la plupart des produits s’appuient sur un seul LLM sans solution de repli. Si l’IA se trouve sur votre chemin critique, la panne du fournisseur doit devenir une donnée de conception – avec la rigueur que nous appliquons à l’intégration de l’IA générative dans les produits, et non une rustine ajoutée en fin de projet.
Ce qui s’est passé le 3 septembre
Le jeudi 3 septembre 2026, des utilisateurs aux États-Unis ont commencé à signaler des pannes quasi simultanées de trois grands assistants IA. ChatGPT d’OpenAI et son outil de code Codex ont renvoyé des taux d’erreur élevés à la suite de ce qu’OpenAI a qualifié d’erreur de routage. Claude d’Anthropic était perturbé au même moment, certains modèles se rétablissant plus vite que d’autres. Grok de xAI s’est lui aussi éteint. Qu’une de ces plateformes trébuche relève de la routine ; que les trois flanchent dans la même fenêtre est une anomalie notable.
L’ampleur s’est vue sur les sites de suivi des pannes. Downdetector a enregistré plus de 37 000 signalements pour ChatGPT, environ 1 300 pour Claude et près de 1 365 pour Grok – des chiffres déséquilibrés qui reflètent la base d’utilisateurs bien plus large de ChatGPT. Les médias ont aussi relevé un effet aggravant : quand ChatGPT est tombé, certains utilisateurs se sont rabattus sur Claude et Grok, ajoutant de la charge à des services déjà en difficulté. La perturbation a duré environ trois heures avant le rétablissement des plateformes, le jour même.
Pour les équipes dont les applications appellent ces modèles via une API plutôt que dans une fenêtre de chat, l’événement a été bien plus qu’un désagrément. Quand le fournisseur du modèle tombe, les fonctionnalités IA cessent silencieusement de fonctionner en production – les résumés ne se génèrent plus, les agents s’arrêtent en pleine tâche, les copilotes du support ne répondent plus. C’est précisément le scénario de défaillance à anticiper, et c’est là que les choix d’architecture en IA, ML et data engineering sur la redondance et les solutions de repli font la différence.
Pourquoi une seule panne a touché trois modèles
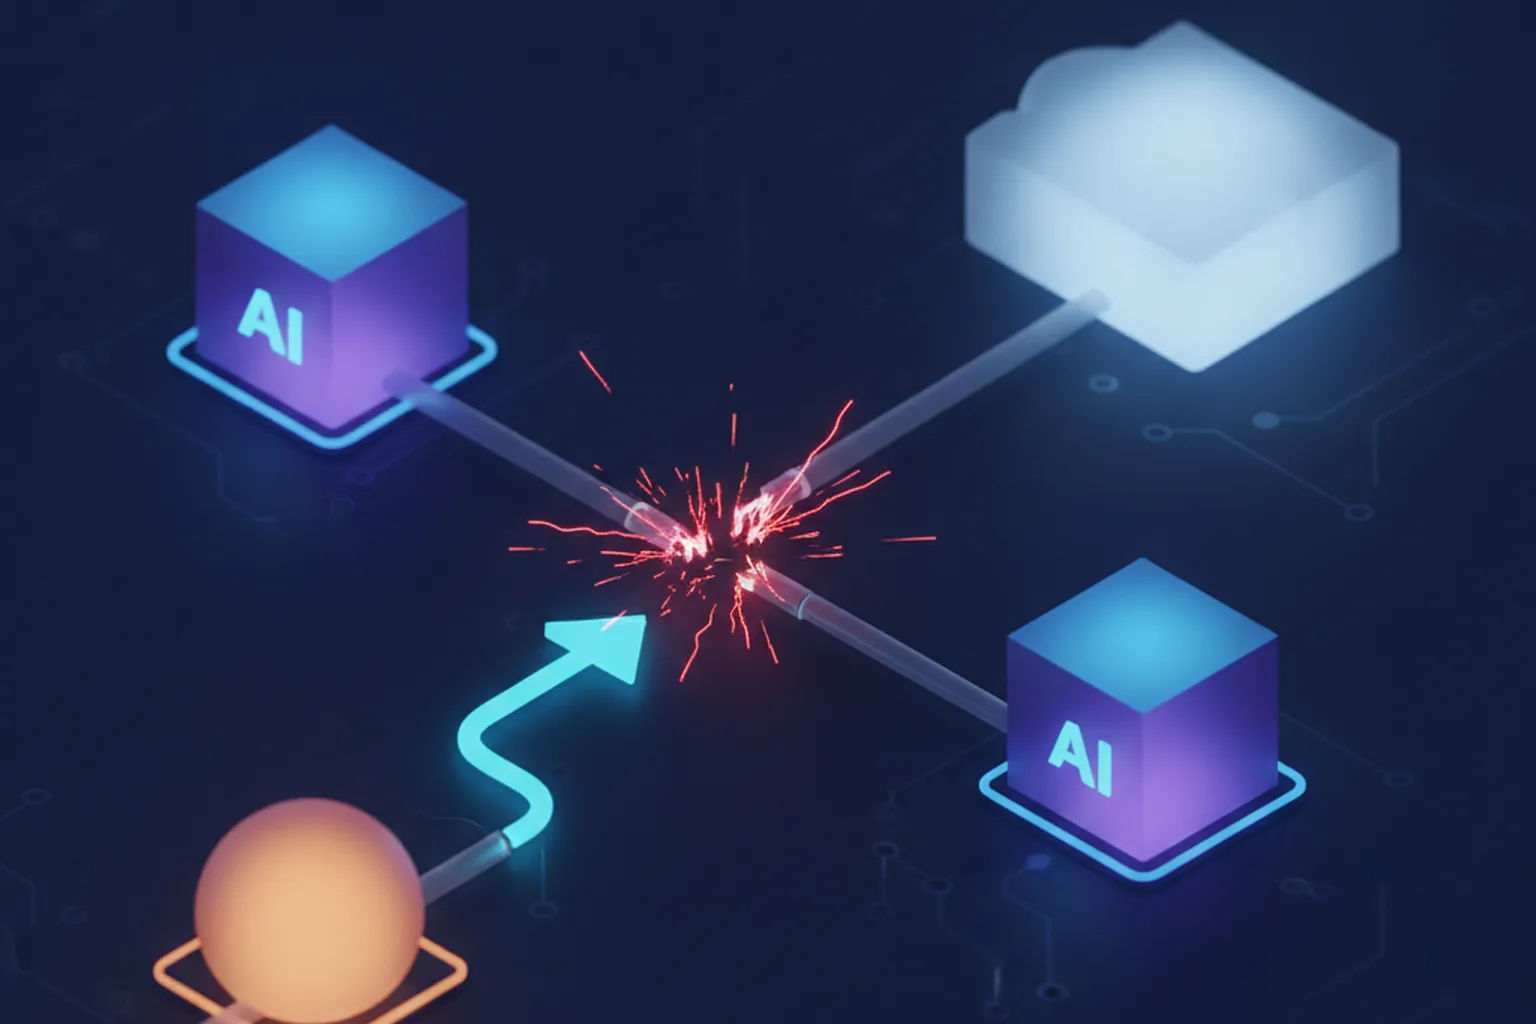
Le fil conducteur des comptes rendus était Microsoft Azure. Une défaillance régionale dans l’empreinte East US d’Azure – une épine dorsale cloud qui porte plusieurs des plus grands services d’IA – semble avoir mis hors service ChatGPT et Codex et contribué en même temps à la perturbation de Claude. Lorsque plusieurs entreprises d’IA indépendantes font tourner leur inférence dans la même région cloud, une seule panne régionale peut prendre l’allure d’une panne coordonnée entre des produits pourtant sans lien.
Le tableau n’était pas parfaitement uniforme, et cette nuance compte. xAI a attribué le problème de Grok à une panne de son propre centre de données de Memphis, et non à Azure : la journée a donc mêlé un incident d’infrastructure partagée et au moins une défaillance distincte, survenue par coïncidence. La leçon reste la même : que votre dépendance porte sur une région cloud précise ou sur le centre de données d’un fournisseur, un seul point de concentration en amont peut mettre votre fonctionnalité hors ligne, quelle que soit la solidité de votre propre code.
Le risque de concentration caché dans votre pile
La plupart des fonctionnalités IA reposent sur une chaîne de dépendances plus profonde qu’il n’y paraît. Votre application appelle l’API d’un modèle ; ce fournisseur exécute l’inférence dans une région cloud donnée ; cette région se trouve dans les centres de données d’un seul hébergeur. Chaque maillon est un point de défaillance unique potentiel, et plusieurs sont invisibles depuis vos propres tableaux de bord. Vos serveurs peuvent afficher une disponibilité parfaite et votre service s’éteindre quand même, parce qu’une région cloud trois niveaux plus haut a connu une mauvaise matinée.
C’est la leçon que l’infrastructure traditionnelle a apprise il y a des années – ne pas mettre toute la charge dans une seule zone de disponibilité –, qui arrive désormais dans la couche IA. La différence : les fournisseurs de modèles sont plus récents, moins nombreux et plus concentrés que le marché du cloud dans son ensemble, et passer de l’un à l’autre ne se résume pas à changer une chaîne de connexion, car les prompts, les API et les formats de sortie diffèrent. C’est précisément cette friction qui explique pourquoi tant d’équipes partent en production avec un seul fournisseur et sans plan B, et pourquoi la panne du 3 septembre est une occasion utile, et sans gravité, d’y remédier. Les bonnes pratiques cloud et DevOps – redondance, contrôles de santé et bascule testée – s’appliquent à la couche modèle comme aux bases de données et aux files de messages.
Les bonnes pratiques de résilience des LLM
Rendre une fonctionnalité IA capable de survivre à la panne d’un fournisseur ne demande pas d’ingénierie exotique, mais l’application de principes de fiabilité éprouvés à la couche modèle. Les briques sont connues :
- Une passerelle indépendante du fournisseur. Faites passer les appels aux modèles par une abstraction interne plutôt que d’appeler directement le SDK d’un fournisseur. Quand le fournisseur principal renvoie des erreurs ou dépasse le délai, la passerelle bascule vers un modèle secondaire. C’est le levier le plus efficace, car il rend possibles toutes les autres pratiques.
- Redondance entre régions et fournisseurs. Quand c’est faisable, répartissez l’inférence sur plusieurs régions cloud – et, pour les chemins critiques, sur plusieurs fournisseurs de modèles – afin qu’une panne régionale ne puisse pas mettre toute la fonctionnalité à terre.
- Délais d’expiration, relances et disjoncteurs. Limitez la durée pendant laquelle un appel peut rester bloqué, relancez les erreurs transitoires avec un backoff exponentiel et ouvrez un disjoncteur (circuit breaker) quand un fournisseur est manifestement défaillant, pour échouer vite au lieu d’empiler les requêtes sur un point d’accès mort.
- Cache et files d’attente. Servez depuis le cache les requêtes répétées et placez en file d’attente le travail non urgent (résumés par lots, enrichissement) pour le traiter au rétablissement du fournisseur, au lieu de le faire échouer.
- Mode dégradé. Définissez ce que fait le produit sans aucun modèle. Un copilote de support peut se replier sur la recherche et le transfert à un humain ; un outil de rédaction peut proposer des modèles de texte. Une expérience réduite mais fonctionnelle vaut mieux qu’un écran d’erreur.
Une réserve doit être dite clairement : un fournisseur de secours n’existe vraiment que si vous l’avez testé et validé la qualité de ses réponses. Un chemin de bascule qui produit en silence de moins bonnes réponses – ou que personne n’a exercé depuis qu’il a été écrit – donne un faux sentiment de sécurité. La résilience se vérifie par des exercices ; elle ne se déduit pas d’un schéma d’architecture.
Ce que cela change pour les équipes aux États-Unis et en Europe
Pour les responsables techniques aux États-Unis et dans l’UE, la première étape consiste à cartographier honnêtement la dépendance. Identifiez où chaque fonctionnalité IA s’exécute réellement : quel fournisseur, quelle région, quels points de défaillance unique en amont que vous ne surveillez pas aujourd’hui. Beaucoup d’équipes découvrent que leur « stratégie IA » se résume à une clé d’API et à une région par défaut, sans visibilité sur les couches inférieures.
La deuxième étape consiste à proportionner la réponse aux enjeux. Toutes les fonctionnalités n’ont pas besoin d’une redondance multi-fournisseurs ; l’effort doit suivre le coût d’une indisponibilité. Un assistant client dans un produit FinTech ou HealthTech, où une panne signifie des transactions perdues ou un parcours clinique bloqué, justifie une bascule multi-fournisseurs complète et un mode dégradé testé. Un outil interne utilisé par une poignée de collaborateurs peut se contenter d’un seul fournisseur, de bonnes relances et d’un message de repli clair. Alignez l’investissement sur l’impact plutôt que de viser partout la redondance maximale – c’est le même arbitrage que nous faisons en développant des agents IA en production qui doivent continuer à fonctionner quand une dépendance flanche.
La troisième étape est organisationnelle : traitez les fournisseurs de modèles comme des prestataires soumis à des SLA, et non comme une infrastructure qui va de soi. Consultez l’historique de leurs pages de statut, comprenez leurs engagements de disponibilité et mettez en place une alerte interne sur leur état de santé, pour que votre équipe d’astreinte apprenne la panne par la supervision et non par les clients. Les équipes qui ont traversé le 3 septembre sereinement sont celles qui s’étaient déjà demandé « que se passe-t-il si ce service tombe ? » et y avaient répondu dans le code.
Qu’est-ce que cela signifie pour le marché français ?
La panne a surtout touché des utilisateurs américains, mais ce n’est pas une raison de se rassurer en France : de nombreuses applications appellent des modèles via des points d’accès par défaut hébergés aux États-Unis, sans que ce choix ait été fait consciemment. Pour les équipes françaises, la question de la redondance rejoint celle de la souveraineté. Combiner un modèle américain hébergé dans une région européenne (par exemple Azure France Central) avec un fournisseur européen comme Mistral AI en solution de repli réduit à la fois le risque de concentration et l’exposition des données hors de l’UE, dans le respect du RGPD et des recommandations de la CNIL.
Pour les banques, assureurs et autres entités financières, le sujet est aussi réglementaire depuis janvier 2025 : le règlement européen DORA (Digital Operational Resilience Act), dont l’ACPR et l’AMF contrôlent l’application en France, impose de gérer les risques liés aux prestataires tiers de services TIC, y compris le risque de concentration et les stratégies de sortie. Un fournisseur de LLM externe sur un chemin critique entre précisément dans ce périmètre. Pour les données les plus sensibles et le secteur public, la qualification SecNumCloud de l’ANSSI pèse en outre dans le choix de l’hébergement. La check-list ci-dessous peut servir de base pour documenter les plans de sortie et de continuité.
Check-list de résilience pour les fonctionnalités IA
- Cartographier la chaîne de dépendances. Pour chaque fonctionnalité IA, documentez le fournisseur, la région cloud et les points de défaillance unique en amont. On ne protège pas ce qu’on n’a pas identifié.
- Abstraire le point d’accès du modèle. Appelez les modèles via une passerelle indépendante du fournisseur pour pouvoir changer ou basculer sans réécriture.
- Ajouter un fournisseur secondaire testé pour tout ce qui est critique pour l’activité – et vérifier la qualité de ses réponses, pas seulement le brancher.
- Définir délais d’expiration, relances et disjoncteurs pour qu’un fournisseur lent ou hors service échoue vite au lieu d’entraîner votre application avec lui.
- Mettre en cache et en file d’attente quand c’est possible, pour que le travail répété et non urgent survive à l’indisponibilité du fournisseur.
- Concevoir le mode dégradé. Définissez l’expérience réduite mais utilisable quand aucun modèle n’est disponible, et montrez aux utilisateurs mieux qu’un message d’erreur.
- Surveiller la santé des fournisseurs et organiser des exercices. Alertez sur l’état des services en amont et exercez régulièrement le chemin de bascule lors d’un test contrôlé, pour savoir qu’il fonctionne avant d’en avoir besoin. Dans les secteurs régulés, conservez le résultat comme preuve.
Questions fréquentes
Que s’est-il passé lors de la panne IA du 3 septembre 2026 ?
Le 3 septembre 2026, trois des chatbots IA les plus utilisés – ChatGPT d’OpenAI (avec son outil de code Codex), Claude d’Anthropic et Grok de xAI – ont signalé des pannes à peu près au même moment, touchant surtout des utilisateurs américains. Downdetector a enregistré plus de 37 000 signalements pour ChatGPT, environ 1 300 pour Claude et près de 1 365 pour Grok. Les services ont été perturbés pendant environ trois heures avant d’être rétablis le jour même.
Pourquoi trois services d’IA sont-ils tombés en même temps ?
Selon les médias, la cause principale est une défaillance régionale de l’infrastructure Microsoft Azure East US, l’épine dorsale cloud qui héberge plusieurs des plus grands services d’IA. OpenAI a évoqué une erreur de routage ; Claude d’Anthropic a également été touché. xAI a en revanche attribué le problème de Grok à une panne de son propre centre de données de Memphis : tout n’était donc pas lié à Azure. Le point commun est une forte dépendance à une infrastructure partagée et concentrée, qui transforme une panne régionale en incident multiservice.
Comment protéger une application contre la panne d’un fournisseur de LLM ?
Le principe de base est d’éviter tout point de défaillance unique. Faites passer les appels aux modèles par une passerelle indépendante du fournisseur pour pouvoir basculer d’un fournisseur à l’autre ; répartissez le service sur plusieurs régions ou fournisseurs cloud quand c’est possible ; ajoutez des délais d’expiration, des nouvelles tentatives avec backoff et des disjoncteurs (circuit breakers) ; mettez en cache et en file d’attente le travail non urgent ; et prévoyez un mode dégradé qui garde le produit utilisable quand le modèle est indisponible. Testez ces chemins régulièrement au lieu de supposer qu’ils fonctionnent.
La bascule multi-fournisseurs pour l’IA ajoute-t-elle du coût et de la complexité ?
Oui. Prendre en charge plusieurs fournisseurs de modèles implique d’harmoniser des API, des prompts et des formats de sortie différents, et d’évaluer en continu la qualité d’un fournisseur à l’autre. Cet effort se justifie quand la fonctionnalité IA est critique pour l’activité ou exposée aux clients et qu’une panne a un coût réel. Pour un outil interne ou non critique, un seul fournisseur avec de bonnes relances et un mode dégradé peut suffire. La décision doit suivre l’impact d’une panne, pas viser la redondance maximale partout.
Sources
Axios — ChatGPT, Claude and Grok all simultaneously hit outages (3 septembre 2026)
The Register — ChatGPT, Claude, and Grok all had outages at the same time (3 septembre 2026)