In breve
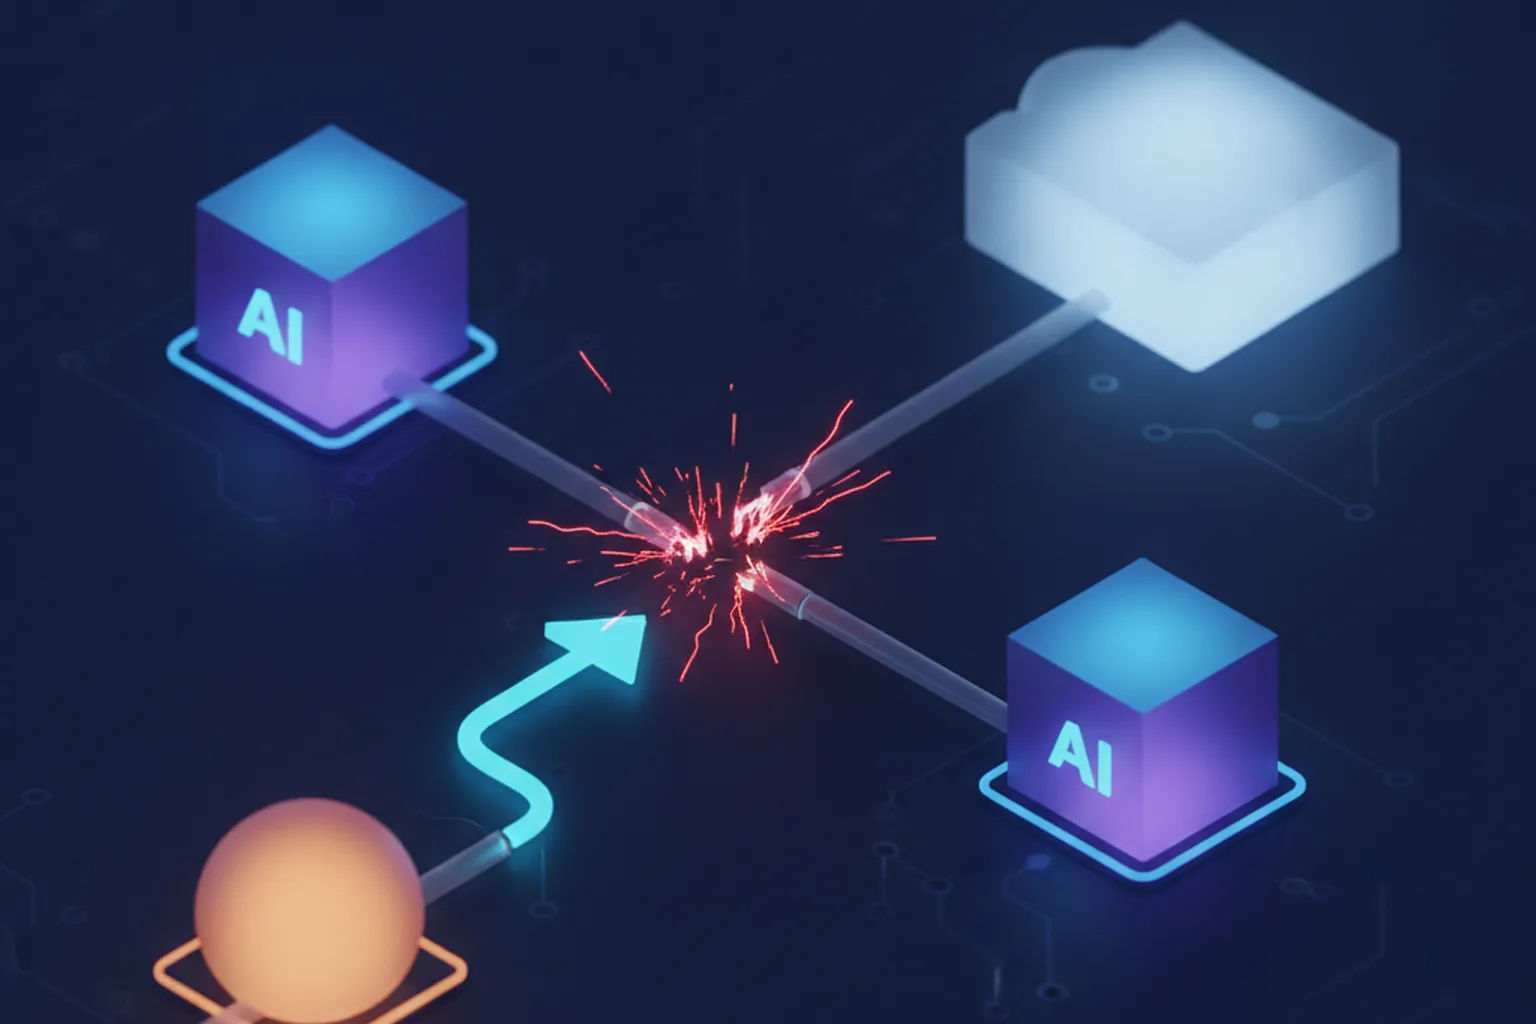
Tre dei chatbot di IA più usati – ChatGPT, Claude e Grok – sono andati down nella stessa finestra temporale il 3 settembre 2026, per circa tre ore, soprattutto a causa di un guasto regionale di Microsoft Azure East US. Downdetector ha registrato oltre 37.000 segnalazioni solo per ChatGPT. La lezione non è che un singolo fornitore sia inaffidabile, ma che la concentrazione su un cloud condiviso rende possibili guasti correlati, mentre la maggior parte dei prodotti si appoggia a un unico LLM senza alternativa. Se l’IA è sul vostro percorso critico, il down del fornitore va trattato come un requisito di progetto – con la stessa disciplina che applichiamo all’integrazione dell’IA generativa nei prodotti, e non come una toppa aggiunta alla fine.
Cosa è successo il 3 settembre
Giovedì 3 settembre 2026 utenti negli Stati Uniti hanno iniziato a segnalare blocchi quasi simultanei di tre grandi assistenti di IA. ChatGPT di OpenAI e il suo strumento di programmazione Codex hanno cominciato a restituire tassi di errore elevati a seguito di quello che OpenAI ha descritto come un errore di routing. Claude di Anthropic era in difficoltà nello stesso momento, con alcuni modelli che si sono ripresi più in fretta di altri. Anche Grok di xAI si è spento. Che una di queste piattaforme inciampi è normale; che tutte e tre cedano nella stessa finestra è un’anomalia significativa.
La portata si è vista sui siti di monitoraggio dei disservizi. Downdetector ha registrato oltre 37.000 segnalazioni per ChatGPT, circa 1.300 per Claude e circa 1.365 per Grok – numeri sbilanciati che riflettono la base utenti ben più ampia di ChatGPT. Le cronache hanno segnalato anche un effetto a catena: quando ChatGPT è andato down, alcuni utenti sono passati a Claude e Grok, aggiungendo carico a servizi già in affanno. Il disservizio è durato circa tre ore, prima che le piattaforme venissero ripristinate in giornata.
Per i team le cui applicazioni chiamano questi modelli via API anziché da una finestra di chat, l’evento è stato più di un fastidio. Quando cade il fornitore del modello, le funzionalità di IA smettono silenziosamente di funzionare in produzione – i riassunti non vengono generati, gli agenti si fermano a metà attività, i copiloti dell’assistenza clienti non rispondono più. È esattamente lo scenario di guasto da prevedere in anticipo, ed è qui che le scelte di IA, ML e data engineering su ridondanza e fallback fanno la differenza.
Perché un solo guasto ha fermato tre modelli
Il filo conduttore delle ricostruzioni è stato Microsoft Azure. Un guasto regionale nell’area East US di Azure – una dorsale cloud che sostiene diversi dei maggiori servizi di IA – sembra aver messo fuori uso ChatGPT e Codex e contribuito, nello stesso momento, al disservizio di Claude. Quando più aziende di IA indipendenti eseguono l’inferenza nella stessa regione cloud, un singolo guasto regionale può apparire come un blocco coordinato tra prodotti in realtà scollegati.
Il quadro non era del tutto uniforme, e questa sfumatura conta. xAI ha attribuito il problema di Grok a un guasto nel proprio data center di Memphis, non ad Azure: la giornata è stata quindi un mix tra un evento di infrastruttura condivisa e almeno un guasto separato e casualmente concomitante. La lezione resta la stessa: che la vostra dipendenza sia una specifica regione cloud o il data center di un fornitore, un unico punto di concentrazione a monte può mettere offline la vostra funzionalità, per quanto solido sia il vostro codice.
Il rischio di concentrazione nascosto nel vostro stack
La maggior parte delle funzionalità di IA poggia su una catena di dipendenze più profonda di quanto sembri. La vostra applicazione chiama l’API di un modello; quel fornitore esegue l’inferenza in una specifica regione cloud; quella regione si trova nei data center di un unico provider. Ogni anello è un potenziale single point of failure, e diversi sono invisibili dalle vostre dashboard. I vostri server possono avere un uptime perfetto e il servizio andare comunque al buio, perché una regione cloud tre livelli più a monte ha avuto una brutta mattinata.
È la stessa lezione che l’infrastruttura tradizionale ha imparato anni fa – non mettere tutto il carico in un’unica availability zone –, che ora arriva nel livello dell’IA. La differenza è che i fornitori di modelli sono più giovani, meno numerosi e più concentrati del mercato cloud nel suo insieme, e passare dall’uno all’altro non è semplice come cambiare una stringa di connessione, perché prompt, API e formati di output sono diversi. È proprio questo attrito a spiegare perché tanti team vanno in produzione con un solo fornitore e nessun piano B, e perché il down del 3 settembre è un’occasione utile, e senza gravi conseguenze, per rimediare. Le buone pratiche cloud e DevOps – ridondanza, health check e failover testato – valgono per il livello dei modelli come per database e code di messaggi.
Pattern per la resilienza degli LLM
Far sopravvivere una funzionalità di IA al down di un fornitore non richiede ingegneria esotica, ma l’applicazione di pattern di affidabilità ben noti al livello dei modelli. I mattoni sono familiari:
- Un gateway indipendente dal fornitore. Instradate le chiamate ai modelli tramite un’astrazione interna invece di usare direttamente l’SDK di un fornitore. Quando il fornitore principale restituisce errori o va in timeout, il gateway passa a un modello secondario. È la leva più efficace, perché rende possibili tutti gli altri pattern.
- Ridondanza tra regioni e fornitori. Dove possibile, distribuite l’inferenza su più regioni cloud – e, per i percorsi critici, su più fornitori di modelli – così che un singolo guasto regionale non possa abbattere l’intera funzionalità.
- Timeout, retry e circuit breaker. Limitate quanto a lungo una chiamata può restare appesa, ripetete gli errori transitori con backoff esponenziale e fate scattare un circuit breaker quando un fornitore è chiaramente in difficoltà, così da fallire rapidamente invece di accumulare richieste su un endpoint morto.
- Caching e code. Servite dalla cache le richieste ripetute e mettete in coda il lavoro non urgente (riassunti in batch, arricchimento dei dati) da elaborare al ripristino del fornitore, invece di farlo fallire subito.
- Degradazione controllata. Decidete cosa fa il prodotto senza alcun modello. Un copilota per l’assistenza può ripiegare sulla ricerca e sul passaggio a un operatore; uno strumento di scrittura può proporre modelli predefiniti. Un’esperienza ridotta ma funzionante batte una schermata di errore.
Un’avvertenza va detta chiaramente: un fornitore di backup esiste davvero solo se lo avete testato e ne avete verificato la qualità delle risposte. Un percorso di failover che produce in silenzio risposte peggiori – o che nessuno ha più eseguito da quando è stato scritto – dà un falso senso di sicurezza. La resilienza è una proprietà che si verifica con le esercitazioni, non che si deduce da un diagramma architetturale.
Cosa significa per i team negli USA e nell’UE
Per i responsabili tecnici negli Stati Uniti e nell’UE, il primo passo è mappare con onestà la dipendenza. Ricostruite dove gira davvero ogni funzionalità di IA: quale fornitore, quale regione, quali single point of failure a monte che oggi non monitorate. Molti team scoprono che la loro «strategia IA» è una chiave API e una regione di default, senza alcuna visibilità sui livelli sottostanti.
Il secondo passo è calibrare la risposta sulla posta in gioco. Non tutte le funzionalità richiedono ridondanza multi-fornitore; lo sforzo deve seguire il costo di un disservizio. Un assistente rivolto ai clienti in un prodotto FinTech o HealthTech, dove un blocco significa transazioni perse o un percorso clinico fermo, giustifica un failover multi-provider completo e una degradazione testata. Uno strumento interno usato da poche persone può accontentarsi di un fornitore, retry solidi e un chiaro messaggio di fallback. Allineate l’investimento all’impatto invece di puntare ovunque alla massima ridondanza – la stessa valutazione che facciamo quando sviluppiamo agenti di IA in produzione che devono continuare a funzionare anche quando una dipendenza cede.
Il terzo passo è organizzativo: trattate i fornitori di modelli come fornitori con SLA, non come un’infrastruttura che c’è e basta. Consultate lo storico delle pagine di stato, comprendete gli impegni di disponibilità dichiarati e impostate alert interni sullo stato dei fornitori, così che il vostro team di reperibilità venga a sapere del disservizio dal monitoraggio e non dai clienti. I team che hanno attraversato il 3 settembre con calma sono quelli che si erano già chiesti «cosa succede se questo servizio cade?» e avevano risposto nel codice.
Cosa significa per il mercato italiano?
Il down ha colpito soprattutto utenti statunitensi, ma per le aziende italiane non è un motivo per tranquillizzarsi: molte applicazioni chiamano i modelli tramite endpoint predefiniti ospitati negli Stati Uniti, senza che sia stata una scelta consapevole. Usare una regione cloud europea o italiana (ad esempio Azure Italy North, a Milano) come primaria, con una seconda regione o un secondo fornitore come fallback, riduce sia il rischio di concentrazione sia il trasferimento di dati fuori dall’UE – un tema su cui il Garante per la protezione dei dati personali è particolarmente attento quando si parla di IA generativa.
Per banche, assicurazioni e altri soggetti finanziari il tema è anche normativo dal gennaio 2025: il regolamento europeo DORA (Digital Operational Resilience Act), vigilato in Italia da Banca d’Italia, IVASS e Consob per i rispettivi ambiti, richiede di gestire il rischio dei fornitori terzi di servizi ICT, incluso il rischio di concentrazione e le strategie di uscita. Un fornitore esterno di LLM su un percorso critico rientra esattamente in questo perimetro. Per gli operatori soggetti alla direttiva NIS2, recepita con il D.Lgs. 138/2024 sotto la regia dell’Agenzia per la Cybersicurezza Nazionale (ACN), la gestione del rischio della catena di fornitura è un obbligo esplicito. La checklist qui sotto può servire come base per documentare piani di uscita e di continuità operativa.
Checklist di resilienza per le funzionalità di IA
- Mappare la catena di dipendenze. Per ogni funzionalità di IA documentate fornitore, regione cloud ed eventuali single point of failure a monte. Non si può proteggere ciò che non si è tracciato.
- Astrarre l’endpoint del modello. Chiamate i modelli tramite un gateway indipendente dal fornitore, così da poter cambiare o fare failover senza riscrivere il codice.
- Aggiungere un fornitore secondario testato per tutto ciò che è critico per il business – e verificarne la qualità delle risposte, non limitarsi a collegarlo.
- Impostare timeout, retry e circuit breaker perché un fornitore lento o fuori servizio fallisca rapidamente invece di trascinare con sé la vostra applicazione.
- Usare cache e code dove possibile, così che il lavoro ripetuto e non urgente sopravviva al down del fornitore.
- Progettare la degradazione controllata. Definite l’esperienza ridotta ma utilizzabile per quando nessun modello è disponibile e mostrate agli utenti qualcosa di meglio di un messaggio di errore.
- Monitorare lo stato dei fornitori e fare esercitazioni. Impostate alert sullo stato dei servizi a monte ed eseguite periodicamente il percorso di failover in un test controllato, per sapere che funziona prima di averne bisogno. Nei settori regolamentati conservate l’esito come evidenza.
Domande frequenti
Cosa è successo durante il down dell’IA del 3 settembre 2026?
Il 3 settembre 2026 tre dei chatbot di IA più usati – ChatGPT di OpenAI (con lo strumento di programmazione Codex), Claude di Anthropic e Grok di xAI – hanno segnalato disservizi più o meno nello stesso momento, che hanno colpito soprattutto utenti statunitensi. Downdetector ha registrato oltre 37.000 segnalazioni per ChatGPT, circa 1.300 per Claude e circa 1.365 per Grok. I servizi sono rimasti compromessi per circa tre ore prima di essere ripristinati in giornata.
Perché tre servizi di IA si sono bloccati contemporaneamente?
Secondo le ricostruzioni, la causa principale è stato un guasto regionale dell’infrastruttura Microsoft Azure East US, la dorsale cloud che ospita diversi dei maggiori servizi di IA. OpenAI ha parlato di un errore di routing; anche Claude di Anthropic è stato colpito. xAI ha invece attribuito il problema di Grok a un guasto nel proprio data center di Memphis, quindi non tutto dipendeva da Azure. Il filo comune è la forte dipendenza da un’infrastruttura condivisa e concentrata, che trasforma un guasto regionale in un evento che coinvolge più servizi.
Come si protegge un’applicazione dal down di un fornitore di LLM?
Il principio di base è evitare un single point of failure. Instradate le chiamate ai modelli tramite un gateway indipendente dal fornitore, così che una richiesta possa passare da un fornitore all’altro; distribuite il servizio su più regioni o provider cloud dove possibile; aggiungete timeout, retry con backoff e circuit breaker; mettete in cache e in coda il lavoro non urgente; progettate una degradazione controllata che mantenga il prodotto utilizzabile in modalità ridotta quando il modello non è disponibile. Testate regolarmente questi percorsi invece di dare per scontato che funzionino.
Il failover multi-provider per l’IA aumenta costi e complessità?
Sì. Supportare più fornitori di modelli significa uniformare API, prompt e formati di output diversi, oltre a valutare costantemente che la qualità resti coerente tra un fornitore e l’altro. Lo sforzo è giustificato quando la funzione di IA è critica per il business o rivolta ai clienti e un disservizio ha un costo reale. Per strumenti interni o non critici possono bastare un solo fornitore, retry solidi e una degradazione controllata. La scelta deve seguire l’impatto di un disservizio, non puntare alla massima ridondanza ovunque.
Fonti
Axios — ChatGPT, Claude and Grok all simultaneously hit outages (3 settembre 2026)
The Register — ChatGPT, Claude, and Grok all had outages at the same time (3 settembre 2026)