Das Wichtigste in Kürze
Drei der meistgenutzten KI-Chatbots – ChatGPT, Claude und Grok – fielen am 3. September 2026 im selben Zeitfenster für rund drei Stunden aus, überwiegend wegen eines regionalen Ausfalls von Microsoft Azure East US. Downdetector zählte allein für ChatGPT über 37.000 Meldungen. Die Lehre lautet nicht, dass ein einzelner Anbieter unzuverlässig wäre, sondern dass die Konzentration auf eine gemeinsame Cloud korrelierte Ausfälle möglich macht – und die meisten Produkte hängen an genau einem LLM ohne Fallback. Liegt KI auf Ihrem kritischen Pfad, gehört der Ausfall des Anbieters als Designvorgabe ins Konzept – mit derselben Sorgfalt, die wir bei der Integration generativer KI in Produkte anwenden, statt ihn am Ende nachträglich anzuflanschen.
Was am 3. September passiert ist
Am Donnerstag, dem 3. September 2026, meldeten Nutzer in den USA nahezu gleichzeitige Ausfälle dreier großer KI-Assistenten. ChatGPT von OpenAI und das Coding-Tool Codex lieferten erhöhte Fehlerraten – nach Angaben von OpenAI infolge eines Routing-Fehlers. Claude von Anthropic war zur selben Zeit gestört, wobei sich einige Modelle schneller erholten als andere. Auch Grok von xAI war nicht erreichbar. Dass eine dieser Plattformen hakt, ist Alltag; dass alle drei im selben Zeitfenster ausfallen, ist eine bemerkenswerte Anomalie.
Das Ausmaß zeigte sich auf den Störungsportalen. Downdetector verzeichnete über 37.000 Meldungen zu ChatGPT, rund 1.300 zu Claude und etwa 1.365 zu Grok – die ungleichen Zahlen spiegeln die deutlich größere Nutzerbasis von ChatGPT. Berichte nannten zudem einen verstärkenden Effekt: Als ChatGPT ausfiel, wichen manche Nutzer auf Claude und Grok aus und erhöhten so die Last auf Dienste, die selbst schon kämpften. Die Störung dauerte rund drei Stunden, bevor die Plattformen noch am selben Tag wiederhergestellt waren.
Für Teams, deren Anwendungen diese Modelle per API statt im Chatfenster aufrufen, war das mehr als ein Ärgernis. Fällt der Modellanbieter aus, brechen KI-Funktionen in Produktion still und leise weg – Zusammenfassungen werden nicht erzeugt, Agenten bleiben mitten in der Aufgabe stehen, Support-Copiloten antworten nicht mehr. Genau diesen Fehlerfall sollte man vorab einplanen, und genau hier zahlen sich Architekturentscheidungen in KI, ML und Data Engineering zu Redundanz und Fallbacks aus.
Warum ein Fehler drei Modelle lahmlegte
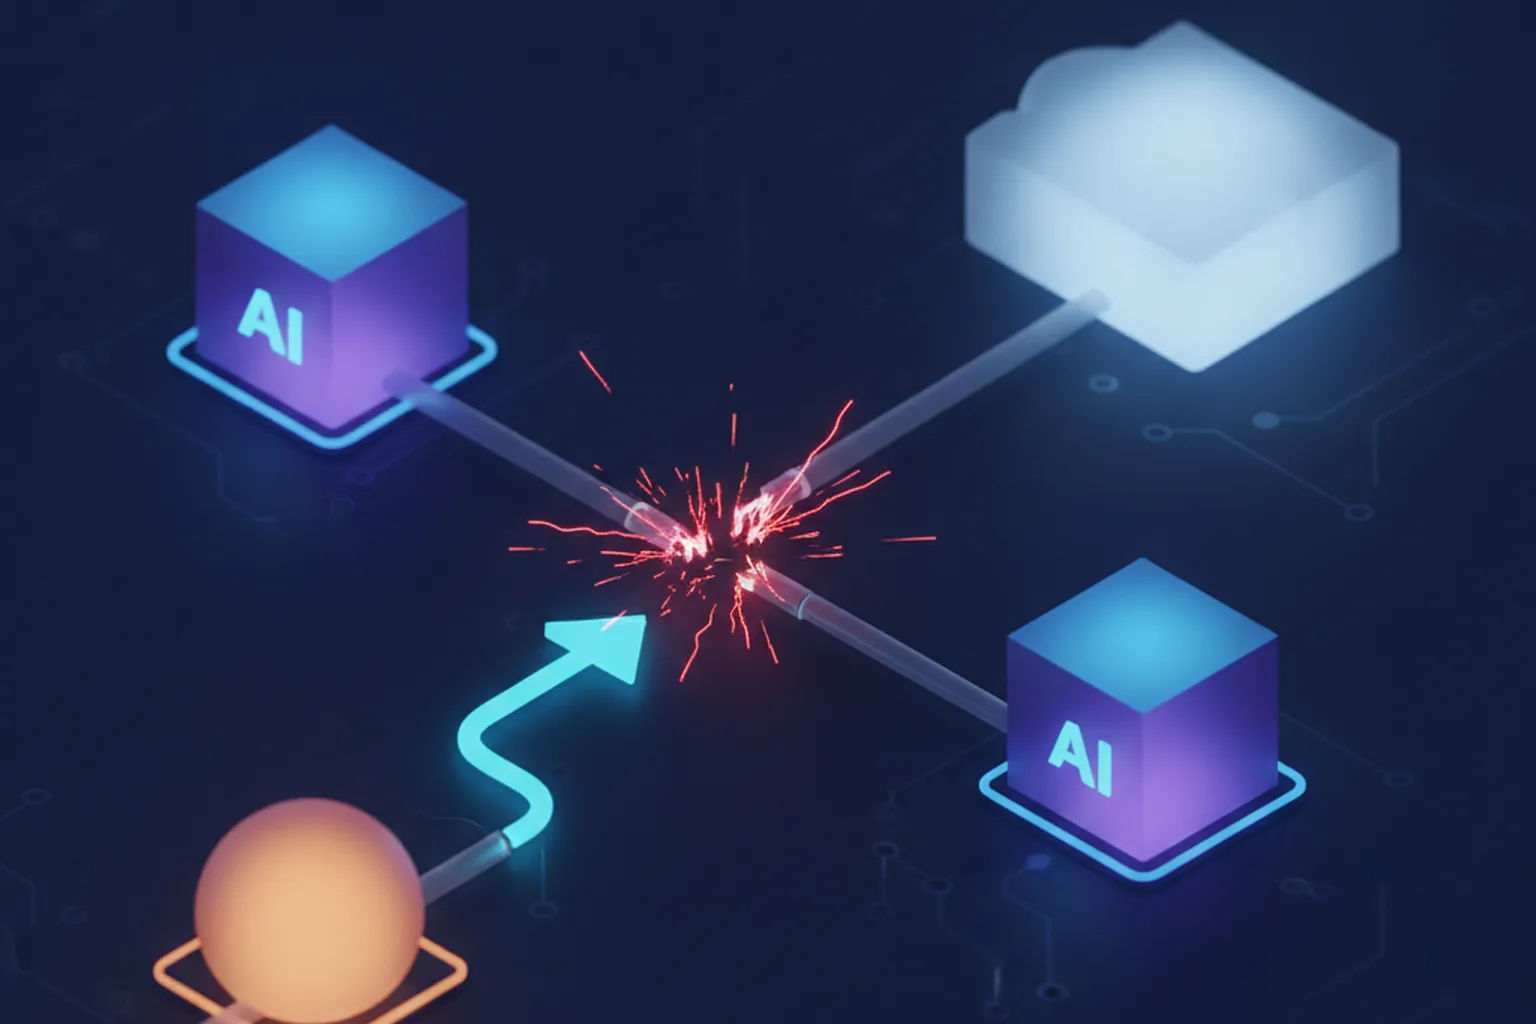
Der gemeinsame Nenner in der Berichterstattung war Microsoft Azure. Ein regionaler Ausfall in Azures East-US-Region – einem Cloud-Rückgrat, auf dem mehrere der größten KI-Dienste laufen – scheint ChatGPT und Codex lahmgelegt und gleichzeitig zur Störung bei Claude beigetragen zu haben. Wenn mehrere unabhängige KI-Unternehmen ihre Inferenz in derselben Cloud-Region betreiben, kann ein einzelner regionaler Fehler wie ein koordinierter Ausfall eigentlich unabhängiger Produkte aussehen.
Ganz einheitlich war das Bild nicht, und diese Nuance ist wichtig. xAI führte das Grok-Problem auf einen Ausfall im eigenen Rechenzentrum in Memphis zurück, nicht auf Azure. Der Tag war also offenbar eine Mischung aus einem Ereignis in geteilter Infrastruktur und mindestens einem davon unabhängigen, zufällig zeitgleichen Ausfall. Die Lehre bleibt dieselbe: Ob die Abhängigkeit an einer bestimmten Cloud-Region oder am eigenen Rechenzentrum eines Anbieters hängt – ein einzelner Konzentrationspunkt weiter oben in der Kette kann Ihre Funktion abschalten, so solide Ihr eigener Code auch ist.
Das Konzentrationsrisiko in Ihrem Stack
Die meisten KI-Funktionen stehen auf einer Abhängigkeitskette, die tiefer ist, als sie aussieht. Ihre Anwendung ruft eine Modell-API auf; der Anbieter betreibt die Inferenz in einer bestimmten Cloud-Region; diese Region liegt in den Rechenzentren eines einzigen Providers. Jedes Glied ist ein potenzieller Single Point of Failure, und mehrere davon sind in Ihren eigenen Dashboards unsichtbar. Ihre Server können perfekte Verfügbarkeit melden, und trotzdem geht bei Ihnen das Licht aus, weil eine Cloud-Region drei Ebenen weiter oben einen schlechten Morgen hatte.
Es ist dieselbe Lektion, die klassische Infrastruktur vor Jahren gelernt hat – nicht die gesamte Last in eine Availability Zone legen –, nur jetzt auf der KI-Ebene. Der Unterschied: Modellanbieter sind jünger, weniger zahlreich und stärker konzentriert als der Cloud-Markt insgesamt, und ein Wechsel ist nicht so simpel wie das Ändern eines Connection Strings, weil sich Prompts, APIs und Ausgabeformate unterscheiden. Genau diese Reibung erklärt, warum so viele Teams mit nur einem Anbieter und ohne Plan B live gehen – und warum der Ausfall vom 3. September ein nützlicher, glimpflicher Anlass ist, das zu ändern. Solide Cloud- & DevOps-Praxis – Redundanz, Health Checks und getestetes Failover – gilt für die Modellschicht genauso wie für Datenbanken und Message Queues.
Muster für LLM-Ausfallsicherheit
Damit eine KI-Funktion den Ausfall eines Anbieters übersteht, braucht es kein exotisches Engineering, sondern bewährte Zuverlässigkeitsmuster auf der Modellebene. Die Bausteine sind bekannt:
- Ein anbieterneutrales Gateway. Modellaufrufe laufen über eine interne Abstraktion, statt direkt das SDK eines Anbieters anzusprechen. Liefert der primäre Anbieter Fehler oder Timeouts, schwenkt das Gateway auf ein sekundäres Modell um. Das ist der wirksamste einzelne Hebel, weil er alle anderen Muster erst möglich macht.
- Redundanz über Regionen und Anbieter. Wo machbar, wird die Inferenz auf mehr als eine Cloud-Region verteilt – und für kritische Pfade auf mehr als einen Modellanbieter –, damit ein einzelner regionaler Fehler nicht die ganze Funktion lahmlegt.
- Timeouts, Retries und Circuit Breaker. Begrenzen Sie, wie lange ein Aufruf hängen darf, wiederholen Sie transiente Fehler mit exponentiellem Backoff und öffnen Sie einen Circuit Breaker, wenn ein Anbieter erkennbar gestört ist – so scheitern Anfragen schnell, statt sich auf einem toten Endpunkt zu stauen.
- Caching und Warteschlangen. Wiederkehrende Anfragen aus dem Cache bedienen und nicht dringende Arbeit (Batch-Zusammenfassungen, Anreicherung) in eine Queue legen, die nach der Wiederherstellung abgearbeitet wird, statt sie sofort scheitern zu lassen.
- Graceful Degradation. Legen Sie fest, was das Produkt ganz ohne Modell tut. Ein Support-Copilot kann auf Suche und Übergabe an einen Menschen zurückfallen, ein Schreibwerkzeug auf Vorlagen. Ein reduziertes, aber funktionierendes Erlebnis schlägt jede Fehlerseite.
Ein Vorbehalt gehört offen ausgesprochen: Ein Backup-Anbieter ist nur dann real, wenn Sie ihn getestet und die Ausgabequalität als ausreichend bestätigt haben. Ein Failover-Pfad, der stillschweigend schlechtere Antworten liefert – oder den seit seiner Implementierung niemand ausgeführt hat –, wiegt in falscher Sicherheit. Ausfallsicherheit ist eine Eigenschaft, die man mit Übungen nachweist, nicht eine, die man aus einem Architekturdiagramm ableitet.
Was das für Teams in den USA und der EU bedeutet
Für Engineering-Verantwortliche in den USA und der EU besteht der erste Schritt darin, die Abhängigkeit ehrlich zu kartieren. Verfolgen Sie, wo jede KI-Funktion tatsächlich läuft: bei welchem Anbieter, in welcher Region, mit welchen vorgelagerten Single Points of Failure, die Sie heute nicht überwachen. Viele Teams stellen fest, dass ihre „KI-Strategie“ aus einem API-Key und einer Standardregion besteht – ohne Einblick in die Schichten darunter.
Der zweite Schritt: die Reaktion an der Tragweite ausrichten. Nicht jede Funktion braucht Redundanz über mehrere Anbieter; der Aufwand sollte den Kosten eines Ausfalls folgen. Ein kundennaher Assistent in einem FinTech- oder HealthTech-Produkt, bei dem ein Ausfall verlorene Transaktionen oder einen stockenden klinischen Ablauf bedeutet, rechtfertigt vollständiges Multi-Provider-Failover und getestete Degradation. Ein internes Tool für eine Handvoll Mitarbeitende kommt womöglich mit einem Anbieter, soliden Retries und einer klaren Fallback-Meldung aus. Richten Sie die Investition an der Wirkung aus, statt überall maximale Redundanz vorzusehen – dieselbe Abwägung treffen wir bei der Entwicklung von produktiven KI-Agenten, die weiterarbeiten müssen, wenn eine Abhängigkeit ausfällt.
Der dritte Schritt ist organisatorisch: Behandeln Sie Modellanbieter als Lieferanten mit SLAs, nicht als Infrastruktur, die einfach da ist. Lesen Sie die Historie der Statusseiten, verstehen Sie die zugesagte Verfügbarkeit und richten Sie internes Alerting auf den Zustand der Anbieter ein, damit Ihr Bereitschaftsteam von einem Ausfall durch das Monitoring erfährt und nicht durch Kunden. Gelassen durch den 3. September kamen die Teams, die die Frage „Was passiert, wenn das hier ausfällt?“ schon gestellt und im Code beantwortet hatten.
Was bedeutet das für den DACH-Markt?
Der Ausfall traf vor allem Nutzer in den USA – doch das ist für Teams im DACH-Raum kein Entwarnungssignal. Viele Anwendungen rufen Modelle über Standard-Endpunkte auf, die in US-Regionen laufen, ohne dass das bewusst entschieden wurde. Wer ohnehin aus Datenschutzgründen nach DSGVO auf EU-Regionen setzt (etwa Azure Germany West Central oder AWS Frankfurt), sollte die Region als Teil der Ausfallstrategie verstehen: Eine EU-Region als primärer und eine zweite Region oder ein zweiter Anbieter als Fallback reduziert Konzentrations- und Datenschutzrisiko zugleich. Europäische Modellanbieter können dabei eine sinnvolle zweite Säule sein.
Für Banken, Versicherer und andere Finanzunternehmen ist das Thema seit Januar 2025 auch regulatorisch: Der EU-Digital Operational Resilience Act (DORA), dessen Einhaltung in Deutschland die BaFin beaufsichtigt, verlangt ein Management von IKT-Drittparteirisiken einschließlich Konzentrationsrisiken und Ausstiegsstrategien. Ein externer LLM-Anbieter im kritischen Pfad ist genau eine solche IKT-Drittpartei. Bei der Auswahl von Cloud-Diensten orientieren sich viele Unternehmen zudem am C5-Kriterienkatalog des BSI. Die Checkliste unten lässt sich direkt als Grundlage für die Dokumentation von Ausstiegs- und Notfallplänen nutzen.
Checkliste für die Ausfallsicherheit von KI-Funktionen
- Abhängigkeitskette kartieren. Für jede KI-Funktion Anbieter, Cloud-Region und vorgelagerte Single Points of Failure dokumentieren. Was Sie nicht nachverfolgt haben, können Sie nicht schützen.
- Modell-Endpunkt abstrahieren. Modelle über ein anbieterneutrales Gateway aufrufen, damit Wechsel oder Failover ohne Neuentwicklung möglich sind.
- Einen getesteten Zweitanbieter hinzufügen für alles Geschäftskritische – und dessen Ausgabequalität prüfen, nicht nur anschließen.
- Timeouts, Retries und Circuit Breaker setzen, damit ein langsamer oder toter Anbieter schnell scheitert, statt Ihre Anwendung mitzureißen.
- Cachen und Queues nutzen, wo möglich, damit wiederkehrende und nicht dringende Arbeit einen Anbieterausfall übersteht.
- Graceful Degradation entwerfen. Das reduzierte, aber nutzbare Erlebnis für den Fall ohne verfügbares Modell definieren und Nutzern etwas Besseres als eine Fehlermeldung zeigen.
- Anbieterzustand überwachen und Übungen fahren. Auf den Upstream-Status alarmieren und den Failover-Pfad regelmäßig in einem kontrollierten Test durchspielen, damit Sie wissen, dass er funktioniert, bevor Sie ihn brauchen. In regulierten Umgebungen das Ergebnis als Nachweis ablegen.
Häufige Fragen
Was ist beim KI-Ausfall am 3. September 2026 passiert?
Am 3. September 2026 meldeten drei der meistgenutzten KI-Chatbots – ChatGPT von OpenAI (samt dem Coding-Tool Codex), Claude von Anthropic und Grok von xAI – nahezu gleichzeitig Störungen, die vor allem Nutzer in den USA trafen. Downdetector verzeichnete über 37.000 Meldungen zu ChatGPT, rund 1.300 zu Claude und etwa 1.365 zu Grok. Die Dienste waren rund drei Stunden beeinträchtigt und noch am selben Tag wiederhergestellt.
Warum fielen drei KI-Dienste gleichzeitig aus?
Berichten zufolge lag die Ursache in einem regionalen Ausfall der Microsoft-Azure-Infrastruktur in East US – dem Cloud-Rückgrat, auf dem mehrere der größten KI-Dienste laufen. OpenAI nannte einen Routing-Fehler, auch Claude von Anthropic war betroffen. xAI führte das Problem bei Grok dagegen auf einen Ausfall im eigenen Rechenzentrum in Memphis zurück, nicht alles hing also an Azure. Der gemeinsame Nenner ist die starke Abhängigkeit von geteilter, konzentrierter Infrastruktur, die einen regionalen Fehler zum Ereignis für mehrere Dienste macht.
Wie schützt man eine Anwendung vor dem Ausfall eines LLM-Anbieters?
Das Grundprinzip lautet: keinen Single Point of Failure zulassen. Modellaufrufe laufen über ein anbieterneutrales Gateway, damit eine Anfrage von einem Anbieter auf einen anderen umschwenken kann; wo möglich, wird über mehrere Cloud-Regionen oder Anbieter verteilt; Timeouts, Retries mit Backoff und Circuit Breaker kommen hinzu; nicht dringende Arbeit wird gecacht oder in Warteschlangen gelegt; und Graceful Degradation hält das Produkt in einem reduzierten Modus nutzbar, wenn das Modell nicht erreichbar ist. Diese Pfade regelmäßig testen, statt anzunehmen, dass sie funktionieren.
Erhöht Multi-Provider-Failover für KI Kosten und Komplexität?
Ja. Wer mehrere Modellanbieter unterstützt, muss unterschiedliche APIs, Prompts und Ausgabeformate vereinheitlichen und die Qualität laufend anbieterübergreifend evaluieren. Der Aufwand lohnt sich, wenn die KI-Funktion geschäftskritisch oder kundennah ist und ein Ausfall echte Kosten verursacht. Für interne oder unkritische Tools können ein einzelner Anbieter mit soliden Retries und Graceful Degradation genügen. Maßstab ist die Auswirkung eines Ausfalls, nicht maximale Redundanz überall.
Quellen
Axios — ChatGPT, Claude and Grok all simultaneously hit outages (3. September 2026)
The Register — ChatGPT, Claude, and Grok all had outages at the same time (3. September 2026)