Accumulo del consumer lag
I consumer lenti accumulano lag illimitato in modo silenzioso. Colleghiamo il Prometheus lag exporter, impostiamo alert di lag e implementiamo l'autoscaling dei consumer con KEDA.
Kafka è alla base delle nostre pipeline di eventi ad alto throughput — lo stream di telemetria corse di Scooter Sharing che elabora migliaia di eventi IoT al secondo, l'event bus logistico di xRouten, l'event sourcing di audit di Loan Conveyor. MSK su AWS, Confluent Cloud e cluster KRaft self-hosted — tutti in produzione.
Offriamo ingegneria Kafka per event sourcing fintech, ingest IoT e telematica, event bus per microservizi e pipeline di change data capture che collegano database ai consumer downstream. Lo Schema Registry mantiene sicuri i contratti producer-consumer durante i deployment. Kafka Connect e Debezium spostano i dati tra Kafka e i database senza pipeline personalizzate. KRaft elimina ZooKeeper per i nuovi cluster.
I consumer lenti accumulano lag illimitato in modo silenzioso. Colleghiamo il Prometheus lag exporter, impostiamo alert di lag e implementiamo l'autoscaling dei consumer con KEDA.
Le modifiche allo schema del producer rompono i consumer sulle versioni precedenti. Applichiamo i controlli di compatibilità BACKWARD dello Schema Registry in CI.
Troppe poche partizioni limitano il parallelismo dei consumer e creano hotspot. Dimensioniamo le partizioni in base alla concorrenza massima desiderata dei consumer in fase di progettazione.
Frequenti riavvii dei consumer scatenano rebalancing che blocca l'elaborazione per secondi. Ottimizziamo session.timeout.ms, utilizziamo il rebalancing sticky cooperativo e minimizziamo i riavvii inutili dei consumer.
L'at-least-once con gestione dei duplicati è spesso più sicuro del transactional exactly-once. Progettiamo consumer idempotenti con tabelle di deduplicazione prima di ricorrere alle transazioni Kafka.
La dipendenza da ZooKeeper aggiunge un quorum separato da gestire. Migriamo alla modalità KRaft per i nuovi cluster e pianifichiamo la rimozione di ZooKeeper per quelli esistenti.
Event di dominio pubblicati dai producer, consumati da più servizi downstream — con DLQ, retry e contratti sugli schemi degli eventi.
Debezium Kafka Connect che acquisisce eventi WAL di PostgreSQL o MySQL come topic Kafka — per invalidazione della cache, sincronizzazione degli indici di ricerca e audit.
Stream di sensori ad alta frequenza partizionati per device ID, consumati da stream processor e archiviati in database time-series.
Log di eventi immutabili per transazioni finanziarie — topic compatti, producer exactly-once e consumer group di audit.
Pipeline Kafka → S3/BigQuery/Snowflake tramite Kafka Connect S3 Sink o job Flink personalizzati per analytics in tempo reale.
Configurazione Kafka gestita con Schema Registry, monitoraggio, alerting e autenticazione IAM/SASL attiva dal primo giorno.
GDPR-aligned · SOC 2-capable · HIPAA-capable · PCI DSS-aware
Comuni: TLS + SASL/SCRAM, applicazione della compatibilità BACKWARD dello Schema Registry, SBOM per le librerie client.
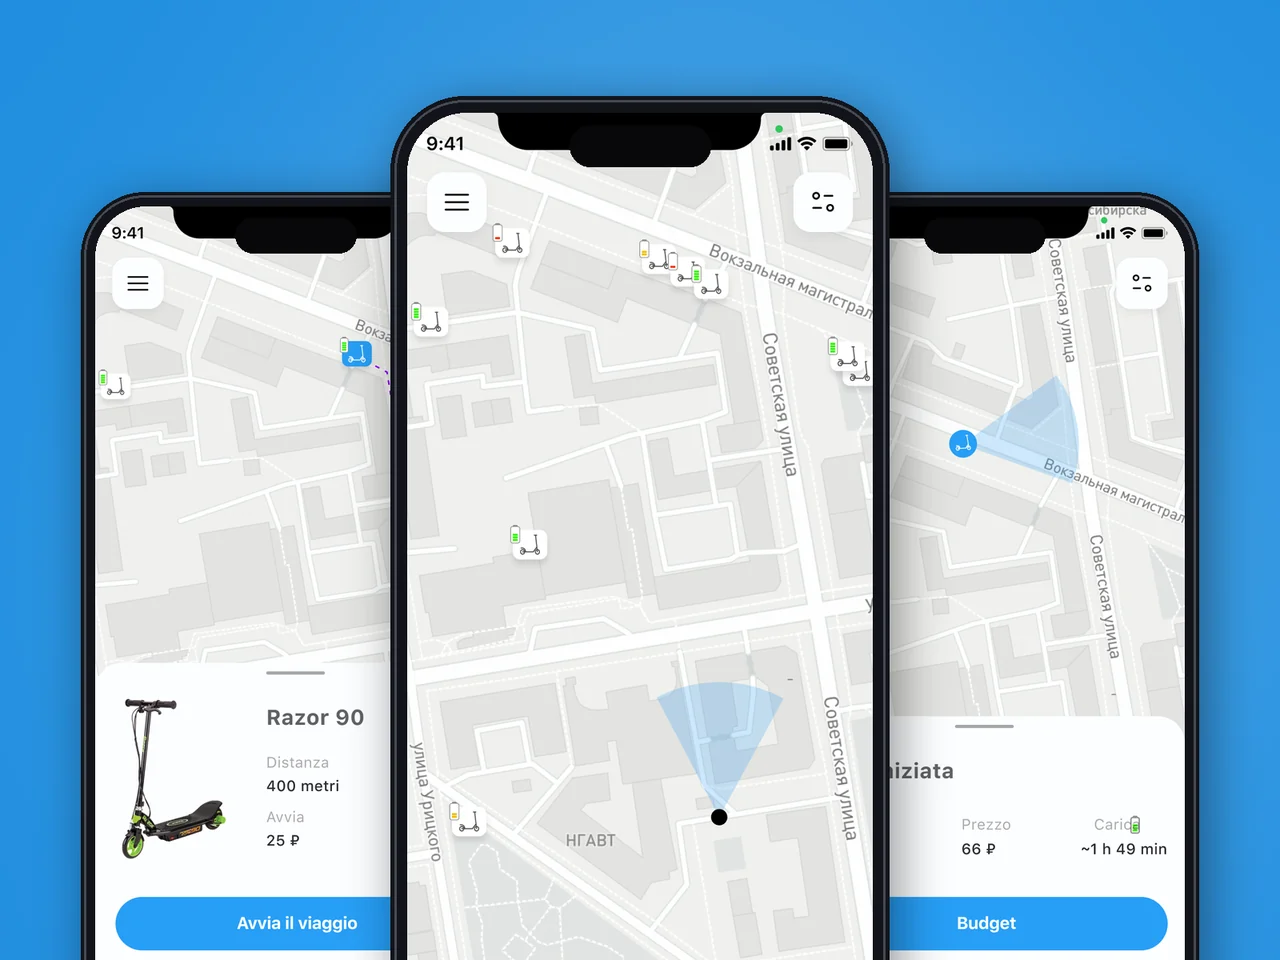
App di e-scooter sharing con mappa live, sblocco QR e wallet corse per iOS e Android — oltre 5.000 utenti, sviluppata per il lancio su mercati USA e UE.
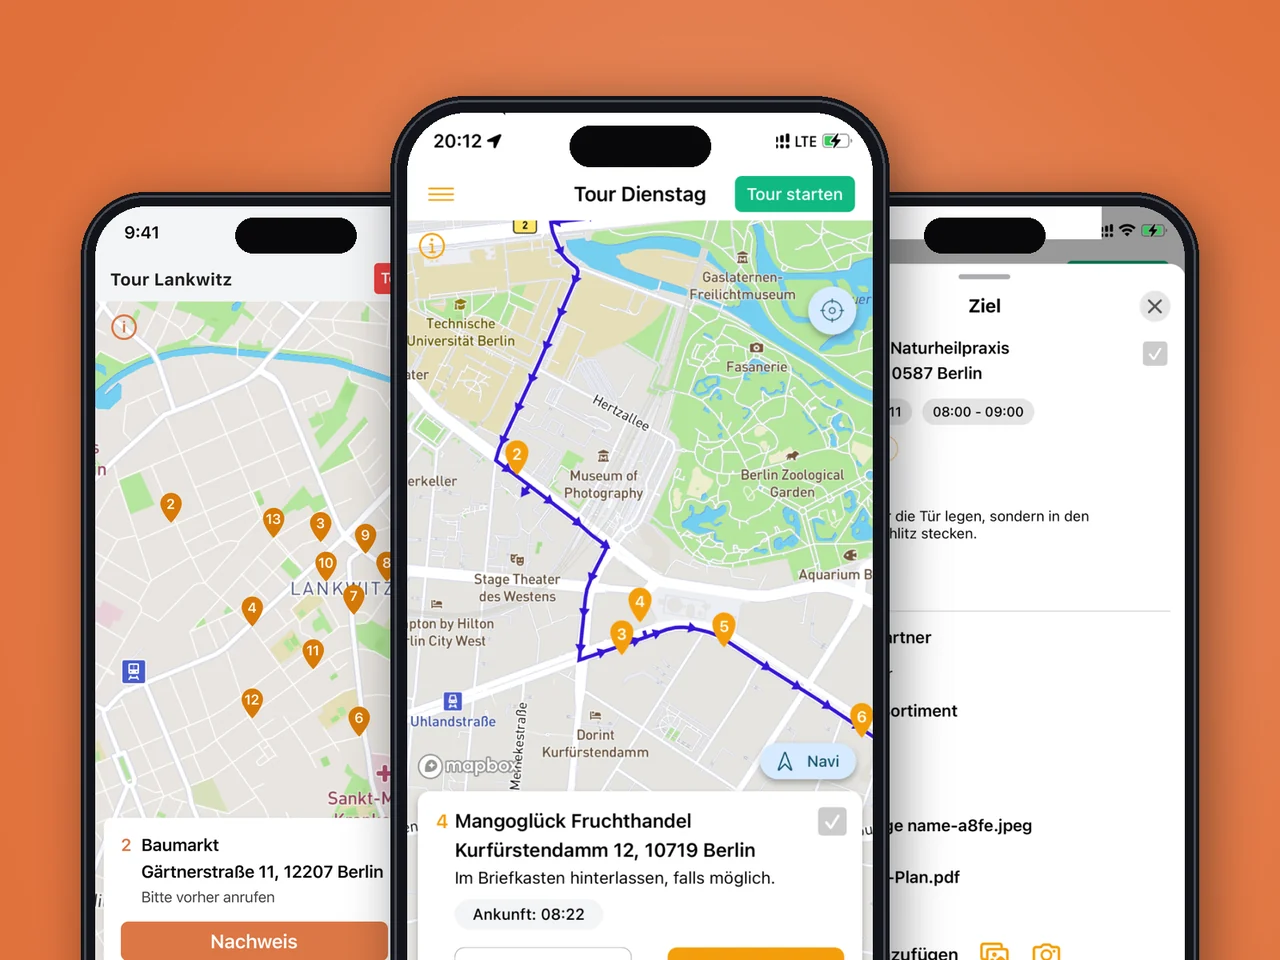
Refactoring e rebuild Android + iOS per un operatore logistico tedesco dell'ultimo miglio — pianificazione percorsi multi-punto, tracking corrieri in tempo reale e fatturazione in-app in produzione in Europa.
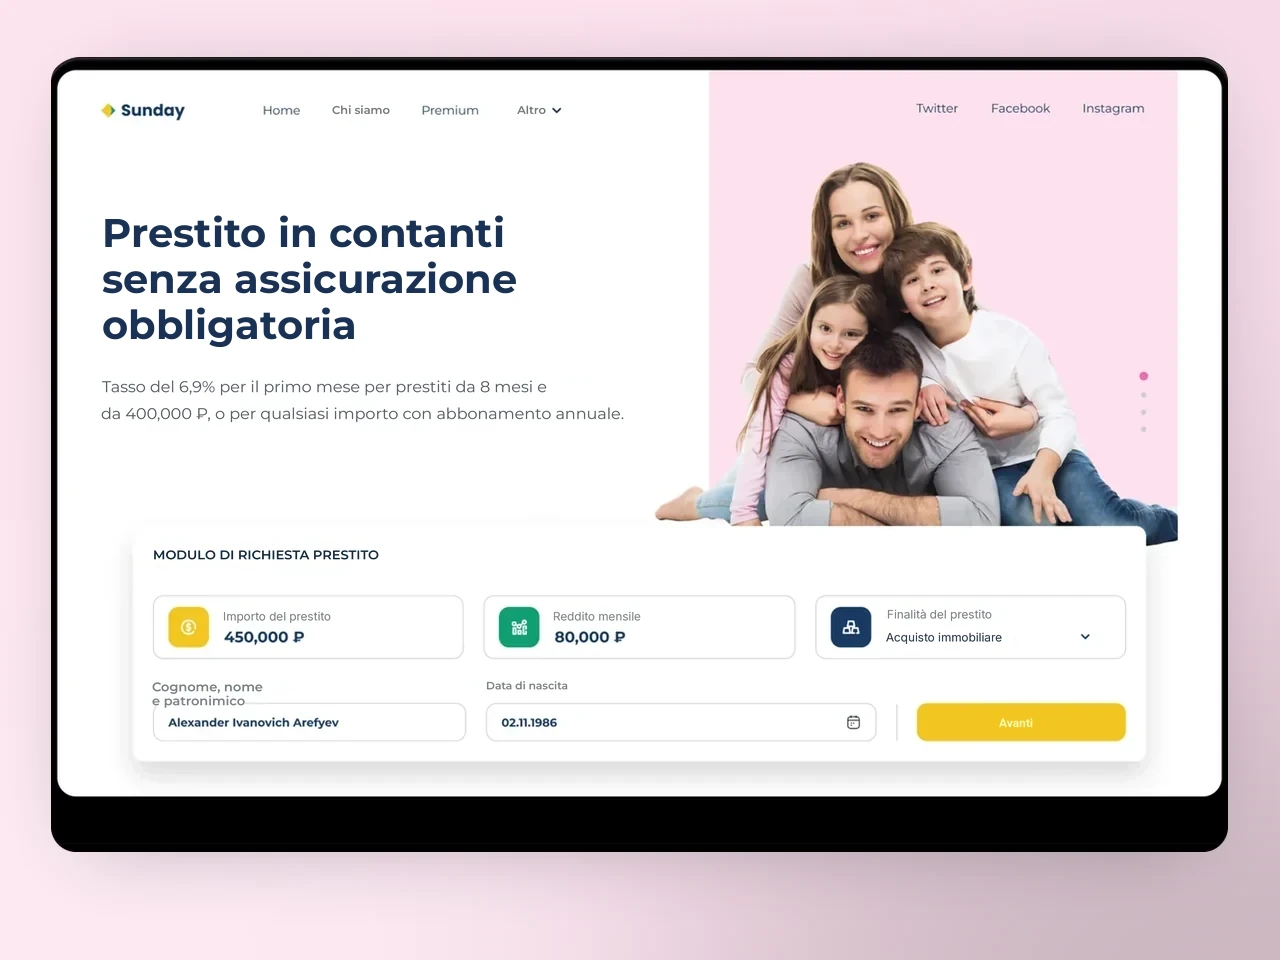
Motore di decisione prestiti ad alto throughput su Laravel — scoring automatizzato, integrazione con le centrali rischi e decisioni 10 volte più veloci per istituti di credito USA e UE.
Un motore di decisione sui prestiti che impiega dieci volte meno tempo per approvare non avviene per caso. YuSMP ha costruito la pipeline di scoring, l’integrazione con i bureau del credito e un back-office che i nostri sottoscrittori apprezzano davvero. I tempi di approvazione sono passati da due giorni a meno di quattro ore.
L'app Android legacy aveva anni di debito tecnico accumulato e nessuna controparte iOS. YuSMP ha effettuato il refactoring del codice esistente, ha rilasciato la versione iOS e ha aggiunto il tracciamento live dei driver e la fatturazione in-app — il tutto senza interrompere le operazioni quotidiane dei nostri autisti.
Pubblichiamo decine di articoli sportivi al giorno. YuSMP ha costruito una pipeline editoriale usando un bot Telegram come CMS — i redattori pubblicano una volta sola, il contenuto arriva sul web, su iOS e su Android istantaneamente. L'architettura non richiede alcuna manutenzione quotidiana.
Il self-service telecom è utile solo se i clienti lo preferiscono davvero al supporto telefonico. YuSMP ha sviluppato app iOS e Android con gestione del saldo, cambio del piano e analisi dell’utilizzo che hanno ridotto il volume del nostro call center del 30% nel primo trimestre dopo il lancio.
1 / 4
Operiamo cluster Kafka KRaft senza ZooKeeper — il nuovo standard per i nuovi deployment.
Ogni modifica allo schema del producer esegue un controllo di compatibilità dello Schema Registry in CI prima del deployment — i consumer non ricevono mai sorprese.
I pod consumer si scalano a zero tra un burst e l'altro e tornano al massimo in pochi secondi dalla crescita della profondità della coda — scaler KEDA nativi Kafka integrati nella nostra configurazione EKS standard.
FAQ
Kafka per pipeline multi-consumer ad alta frequenza, replica cross-region, conservazione dei messaggi a lungo termine e ordinamento rigoroso nelle partizioni. Redis Streams per event sourcing leggero all'interno di un singolo data centre dove l'overhead operativo di Kafka non è giustificato. I topic compatti di Kafka e lo Schema Registry lo rendono la scelta corretta quando i consumer downstream necessitano di garanzie di evoluzione degli schemi.
MSK (Amazon Managed Streaming for Kafka) per i team già su AWS che vogliono evitare l'overhead operativo di Kafka — ZooKeeper sostituito da KRaft nelle versioni recenti. Confluent Cloud per i team che desiderano Schema Registry, ksqlDB e monitoraggio senza gestire alcuna infrastruttura Kafka. Self-hosted per ambienti air-gapped o on-premises. Operiamo su tutte e tre le soluzioni.
Il monitoraggio del consumer lag con Kafka Consumer Lag Exporter in Prometheus è imprescindibile. Impostiamo alert a 10k messaggi di lag per i topic critici, implementiamo consumer auto-scaling con KEDA in Kubernetes e progettiamo il numero di partizioni per corrispondere al massimo parallelismo dei consumer.
Confluent Schema Registry con compatibilità BACKWARD come policy predefinita — le nuove versioni degli schemi devono essere leggibili dai consumer sulla versione precedente. Applichiamo i controlli di compatibilità degli schemi in CI prima di distribuire i producer. Compatibilità FORWARD per i casi in cui i consumer si aggiornano per primi.
Transazioni Kafka (producer idempotente + consumer transazionale) per exactly-once all'interno di Kafka. Per exactly-once cross-sistema (Kafka → database), utilizziamo l'outbox pattern: scrittura in una tabella outbox del database nella stessa transazione dell'operazione di business, e un connettore Kafka Connect Debezium legge gli eventi CDC dall'outbox.
TLS per tutte le connessioni ai broker, SASL/SCRAM o mTLS per l'autenticazione, ACL per l'accesso ai topic per consumer group, e autenticazione MSK IAM per i deployment gestiti su AWS. Accesso allo Schema Registry controllato per schema subject. Verifichiamo le ACL Kafka trimestralmente.
Diteci dove volete essere tra dodici mesi. Vi risponderemo con un piano per arrivarci.
Risposta entro 1 giorno lavorativo. NDA su richiesta.
Condividete alcuni dettagli e un consulente senior risponderà entro un giorno lavorativo.
Email: sales@yusmpgroup.com
Telefono: +374 44 871 811
Uffici: KAMAR Business Center, Vazgen Sargsyan St. 2, Erevan, Armenia · Remoto — sovrapposizione con la costa est degli Stati Uniti (9:00–13:00 ET)