Dashboard sprawl e governance
Le istanze Grafana non gestite accumulano centinaia di dashboard ad-hoc con denominazione incoerente, pannelli non funzionanti e nessuna ownership. Trovare la vista autorevole durante un incidente spreca minuti critici.
Grafana unifica metriche, log e trace distribuiti in un’unica interfaccia — eliminando il context-switching tra Datadog, Splunk e CloudWatch durante un incidente. Progettiamo e deployiamo ambienti Grafana in produzione con lo stack LGTM completo (Loki, Grafana, Tempo, Mimir), provisioning dashboards-as-code, SSO e RBAC per team di ingegneria USA e UE che necessitano di visibilità operativa senza vendor lock-in.
Grafana unifica metriche, log e trace distribuiti in un’unica interfaccia — eliminando il context-switching tra Datadog, Splunk e CloudWatch durante un incidente. Progettiamo e deployiamo ambienti Grafana in produzione con lo stack LGTM completo (Loki, Grafana, Tempo, Mimir), provisioning dashboards-as-code, SSO e RBAC per team di ingegneria USA e UE che necessitano di visibilità operativa senza vendor lock-in.
Le istanze Grafana non gestite accumulano centinaia di dashboard ad-hoc con denominazione incoerente, pannelli non funzionanti e nessuna ownership. Trovare la vista autorevole durante un incidente spreca minuti critici.
Permessi troppo ampi sulle data source espongono metriche infrastrutturali sensibili ai team sbagliati. Senza RBAC a livello di cartella e service account per data source, qualsiasi utente Grafana può interrogare i database di produzione.
I team che utilizzano sia Grafana Alerting sia Prometheus Alertmanager finiscono con regole di alert duplicate e in conflitto. La logica di routing diverge, le notifiche vengono perse e gli ingegneri on-call ricevono messaggi contraddittori.
I dashboard creati manualmente non possono essere sotto controllo di versione, sottoposti a review o promossi tra gli ambienti. Le organizzazioni che si affidano solo alla modifica tramite interfaccia non possono riprodurre la propria configurazione di observability dopo una migrazione del cluster.
Senza uno stack LGTM correlato, gli ingegneri passano tra le interfacce separate di Prometheus, Loki e Jaeger durante un incidente — perdendo tempo a interrogare nuovamente la stessa finestra temporale su strumenti disconnessi.
Collegare Grafana agli identity provider aziendali (Okta, Azure AD, Google Workspace) e imporre l’isolamento delle cartelle per team richiede una configurazione SAML/OIDC accurata che è facile misconfigurare silenziosamente.
Tutti i dashboard definiti in JSON/YAML sotto controllo di versione tramite il provisioning di Grafana — templati, sottoposti a peer review e promossi attraverso dev/staging/produzione senza alcun click manuale nell’interfaccia.
Grafana + Loki + Tempo + Mimir deployati come stack self-hosted o Grafana Cloud — un’unica superficie di query unificata per log, trace distribuiti e metriche a lunga ritenzione senza limiti di cardinalità per metrica.
Integrazione SAML/OIDC con Okta, Azure AD o Google Workspace; RBAC a livello di cartella che mappa i gruppi IdP ai ruoli Grafana; service account per data source con accesso read-only a privilegio minimo.
I link Grafana Explore e le annotazioni exemplar correlano un picco di log Loki con un’anomalia metrica Mimir e la trace Tempo corrispondente — causa principale in un clic invece di tre cambi di strumento.
Regole di alert unificate in Grafana Alerting sostituiscono il routing doppio di Alertmanager; Grafana OnCall gestisce i programmi di escalation, i silenzi e le timeline degli incidenti — con integrazioni per Slack, PagerDuty e Mattermost.
Dashboard unici che combinano Prometheus, Elasticsearch, PostgreSQL, CloudWatch e data source API personalizzate — federazione delle query senza duplicazione dei dati o pipeline ETL.
RBAC allineato GDPR · Audit logging SOC 2 · Visibilità incidenti NIS2 · Resilienza operativa DORA
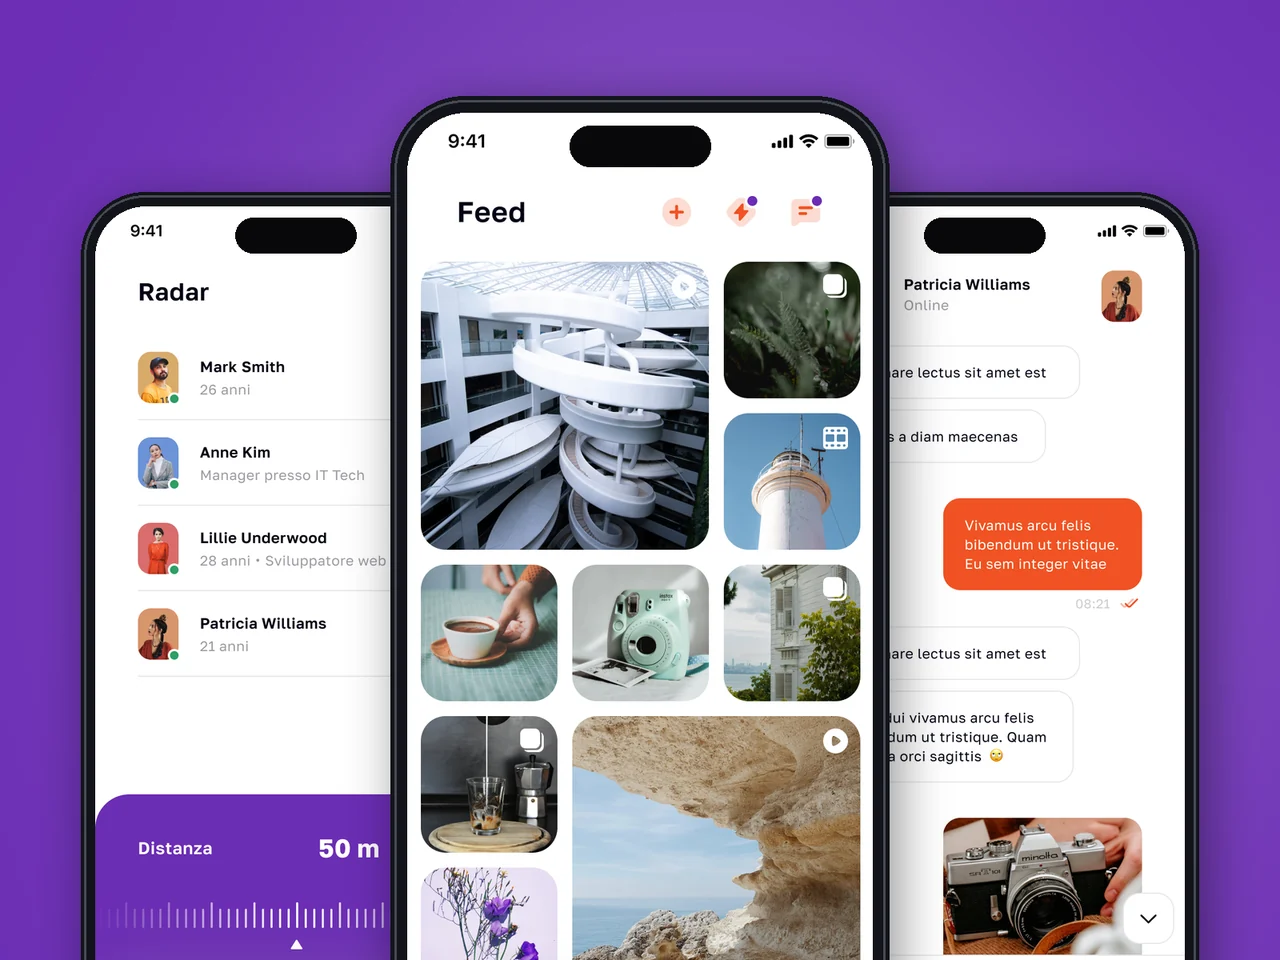
Piattaforma social in produzione su App Store e Google Play con geo Radar, messaggistica cifrata ed economia virtuale negli Stati Uniti e in Europa.
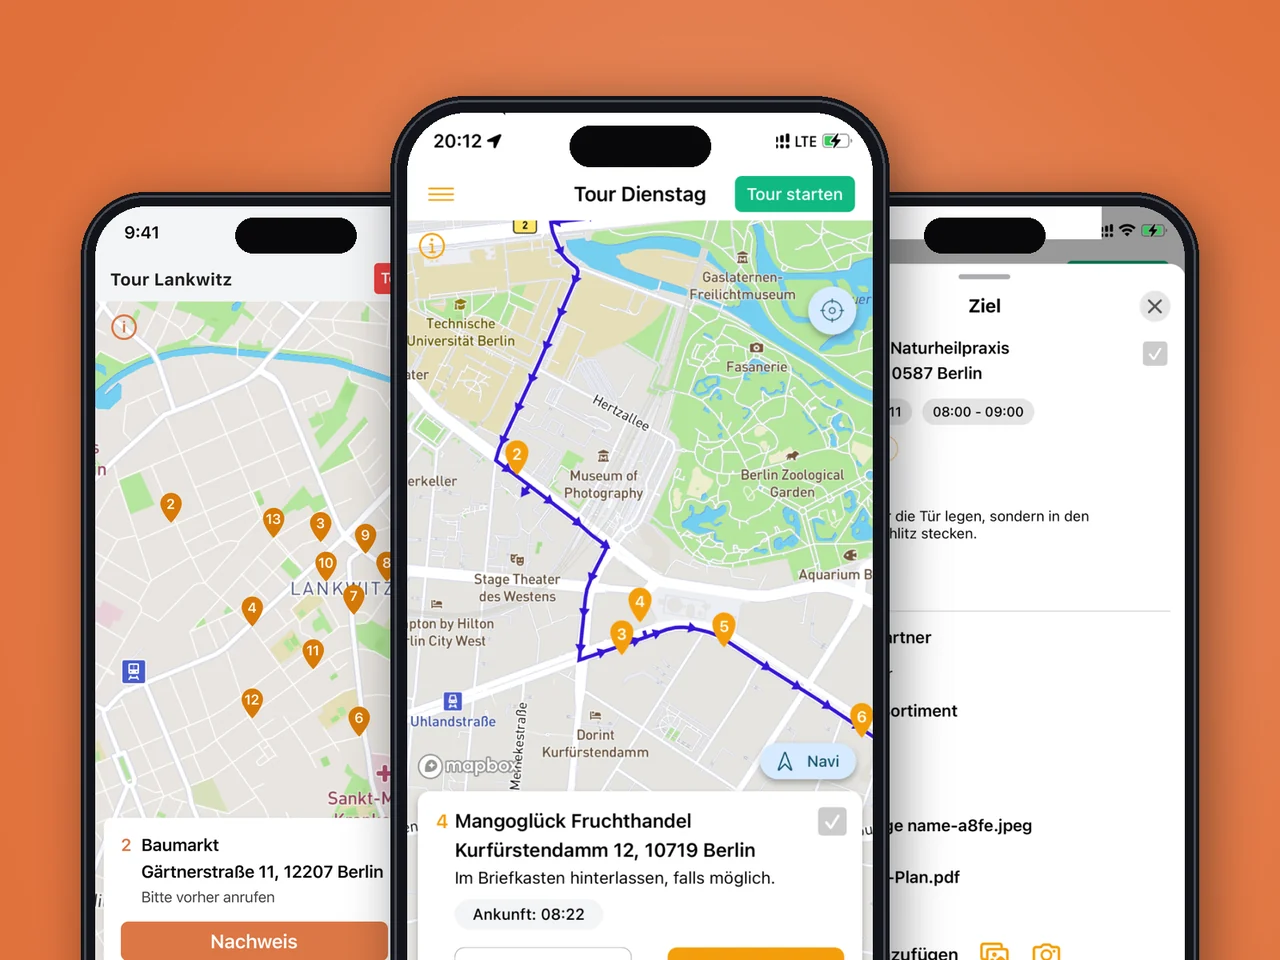
Refactoring e rebuild Android + iOS per un operatore logistico tedesco dell'ultimo miglio — pianificazione percorsi multi-punto, tracking corrieri in tempo reale e fatturazione in-app in produzione in Europa.
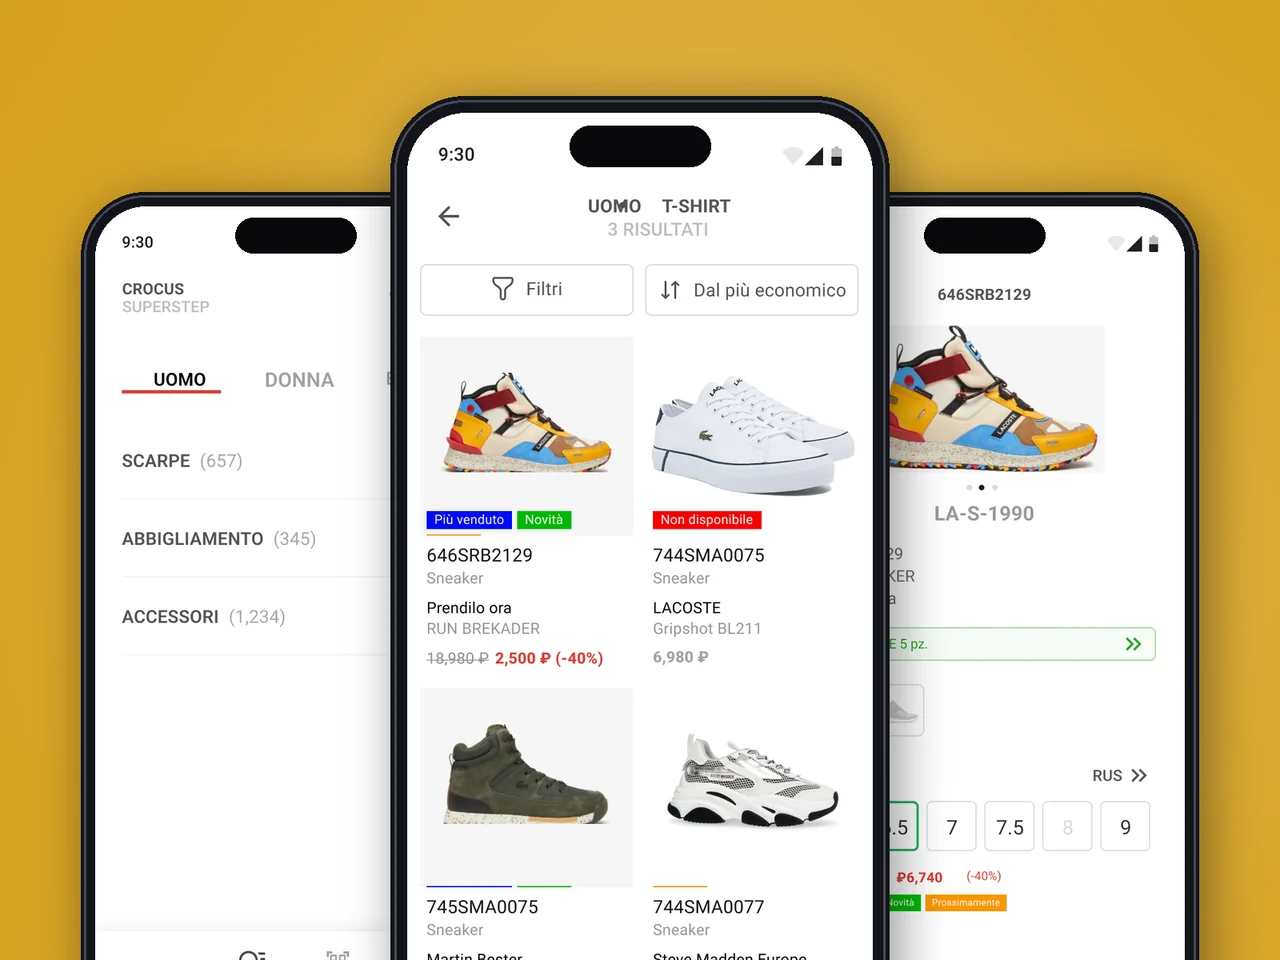
App POS companion per una catena di boutique multi-brand — ricerca inventario cross-store con ElasticSearch, integrazione sistema 1C.
L'app Android legacy aveva anni di debito tecnico accumulato e nessuna controparte iOS. YuSMP ha effettuato il refactoring del codice esistente, ha rilasciato la versione iOS e ha aggiunto il tracciamento live dei driver e la fatturazione in-app — il tutto senza interrompere le operazioni quotidiane dei nostri autisti.
Costruire una piattaforma social da zero è un lavoro ad alto rischio. YuSMP ha consegnato il feed degli interessi, il Radar geografico, le Stories e l'economia delle monete virtuali nei tempi previsti, con una codebase che il nostro team interno ha recepito il primo giorno di consegna.
I nostri consulenti perdevano 15 minuti per cliente nei controlli manuali dell'inventario. YuSMP ha sviluppato app native basate su ElasticSearch, collegate al nostro sistema 1C in tempo reale. Il tempo per cliente è diminuito del 40% in tutte le sedi entro una settimana dal lancio.
Un motore di decisione sui prestiti che impiega dieci volte meno tempo per approvare non avviene per caso. YuSMP ha costruito la pipeline di scoring, l’integrazione con i bureau del credito e un back-office che i nostri sottoscrittori apprezzano davvero. I tempi di approvazione sono passati da due giorni a meno di quattro ore.
1 / 4
Lo stack LGTM completo è open-source e self-hostabile. Progettiamo la vostra piattaforma di observability in modo che siate proprietari dei dati, dei dashboard e della logica di alerting — non del modello di pricing di un vendor SaaS.
I dashboard sotto controllo di versione e provisionati significano che un nuovo ingegnere può ricostruire l’intero ambiente di observability da un repository Git. Non esistono personalizzazioni non documentate solo nell’interfaccia.
Log, metriche e trace correlati in un’unica interfaccia riducono il tempo di individuazione della causa principale. Le nostre configurazioni Grafana sono progettate attorno ai workflow che il vostro team on-call usa sotto pressione, non per un’estetica dimostrativa.
Domande frequenti
Datadog è un SaaS completamente gestito con un’ampia superficie di funzionalità e prezzi basati sull’utilizzo che scalano ripidamente ad alta cardinalità. Grafana (self-hosted o Grafana Cloud) offre controllo sulla residenza dei dati, i prezzi e lo stack LGTM completo. Consigliamo Grafana per i team con requisiti GDPR/sovranità dei dati, budget di cardinalità metrica elevata, o preferenza per strumenti open-source — e Datadog quando una piattaforma gestita zero-ops giustifica il costo.
LGTM è l’acronimo di Loki (aggregazione dei log), Grafana (visualizzazione e alerting), Tempo (distributed tracing) e Mimir (metriche scalabili a lunga ritenzione, sostituto drop-in di Prometheus). Insieme formano una piattaforma di observability self-hosted che copre i tre pilastri della telemetria — log, metriche e trace — sotto un’unica interfaccia Grafana senza richiedere strumenti specializzati separati per ogni tipo di segnale.
Il sistema di provisioning di Grafana legge dashboard JSON e data-source YAML da file su disco (o un repository Git tramite strumenti come Grafonnet o Terraform). Ciò significa che ogni dashboard è sotto controllo di versione, sottoposto a code review e riproducibile in tutti gli ambienti. Le modifiche vengono deployate tramite CI/CD anziché tramite modifiche manuali all’interfaccia, fornendo una trail di audit completa e la capacità di fare rollback di una modifica errata in pochi secondi.
Prometheus raccoglie metriche dai servizi e le archivia localmente; Grafana interroga Prometheus (o Mimir, un backend scalabile compatibile con Prometheus) tramite PromQL e renderizza i risultati come pannelli. Grafana non sostituisce Prometheus — è il livello di visualizzazione e alerting sopra di esso. In un tipico setup LGTM, Mimir sostituisce lo storage locale di Prometheus per la ritenzione a lungo termine e la scalabilità orizzontale, mentre gli agent Prometheus continuano a raccogliere metriche all’edge.
Configuriamo l’integrazione SAML o OIDC di Grafana con il vostro identity provider (Okta, Azure AD, Google Workspace). I gruppi IdP vengono mappati ai ruoli dell’organizzazione Grafana e ai permessi delle cartelle. Ogni team vede solo i dashboard e le sorgenti dati assegnate alla propria cartella. Nei deployment multi-tenant, le organizzazioni Grafana o l’RBAC di Grafana Enterprise forniscono confini rigidi tra tenant con credenziali data-source separate per tenant.
Loki indicizza solo le label (non il full-text), rendendolo molto meno costoso da operare in scala — archivia chunk di log compressi in object storage (S3, GCS). Elasticsearch indicizza ogni campo, abilitando una potente ricerca full-text ma con costi di storage e compute significativamente più elevati. Scegliere Loki quando si controlla la struttura dei log e si interroga principalmente per label (service, environment, level); scegliere Elasticsearch quando si necessita di ricerca full-text arbitraria su log legacy non strutturati o si richiede l’ecosistema Kibana.
Grafana self-hosted (OSS o Enterprise) offre pieno controllo su residenza dei dati, ritenzione, costi e configurazione — la scelta giusta per requisiti GDPR/sovranità dei dati rigorosi o metriche ad alto volume dove il pricing di Grafana Cloud diventa significativo. Grafana Cloud elimina il sovraccarico operativo e fornisce alerting gestito, monitoraggio sintetico e observability frontend out of the box. Aiutiamo i team a valutare il trade-off build-vs-buy e possiamo configurare o migrare entrambe le opzioni.
Diteci dove volete essere tra dodici mesi. Vi risponderemo con un piano per arrivarci.
Risposta entro 1 giorno lavorativo. NDA su richiesta.
Condividete alcuni dettagli e un consulente senior risponderà entro un giorno lavorativo.
Email: sales@yusmpgroup.com
Telefono: +374 44 871 811
Uffici: KAMAR Business Center, Vazgen Sargsyan St. 2, Erevan, Armenia · Remoto — sovrapposizione con la costa est degli Stati Uniti (9:00–13:00 ET)