Blog News Kontakt Angebot anfordern

Grafana Observability Dashboards für vereinheitlichte Metriken, Logs und Traces

Grafana bündelt Metriken, Logs und Distributed Traces in einer einzigen Ansicht — und eliminiert damit den Kontextwechsel zwischen Datadog, Splunk und CloudWatch während eines Incidents. Wir konzipieren und betreiben produktionsreife Grafana-Umgebungen mit dem vollständigen LGTM-Stack (Loki, Grafana, Tempo, Mimir), dashboards-as-code-Provisioning, SSO und RBAC für Engineering-Teams in den USA und der EU, die operative Transparenz ohne Vendor-Lock-in benötigen.

  • Grafana
  • Grafana Loki (Logs)
  • Grafana Tempo (Traces)
  • Grafana Mimir (Metriken)

Grafana bündelt Metriken, Logs und Distributed Traces in einer einzigen Ansicht — und eliminiert damit den Kontextwechsel zwischen Datadog, Splunk und CloudWatch während eines Incidents. Wir konzipieren und betreiben produktionsreife Grafana-Umgebungen mit dem vollständigen LGTM-Stack (Loki, Grafana, Tempo, Mimir), dashboards-as-code-Provisioning, SSO und RBAC für Engineering-Teams in den USA und der EU, die operative Transparenz ohne Vendor-Lock-in benötigen.

Branchenherausforderungen, die wir lösen

Dashboard-Wildwuchs und Governance

Unkontrollierte Grafana-Instanzen häufen Hunderte von Ad-hoc-Dashboards mit inkonsistenter Benennung, defekten Panels und unklarer Verantwortlichkeit an. Während eines Incidents kostet die Suche nach der maßgeblichen Ansicht wertvolle Minuten.
data-source-Sicherheit und RBAC

Weitreichende data-source-Berechtigungen setzen sensible Infrastrukturmetriken den falschen Teams aus. Ohne Ordner-RBAC und teamspezifische Service-Accounts kann jeder Grafana-Nutzer Produktionsdatenbanken abfragen.

Konsistentes Alerting über alle Stacks

Teams, die sowohl Grafana Alerting als auch Prometheus Alertmanager betreiben, enden mit duplizierten, widersprüchlichen Alert-Regeln. Routing-Logik divergiert, Benachrichtigungen gehen verloren und On-Call-Entwickler erhalten widersprüchliche Meldungen.

Einführung von dashboards-as-code

Manuell erstellte Dashboards lassen sich nicht versionieren, reviewen oder umgebungsübergreifend promoten. Organisationen, die nur über die UI arbeiten, können ihr Observability-Setup nach einer Cluster-Migration nicht reproduzieren.

Vereinheitlichte Logs, Metriken und Traces

Ohne einen korrelierten LGTM-Stack wechseln Entwickler während eines Incidents zwischen separaten Prometheus-, Loki- und Jaeger-Oberflächen — und verlieren Zeit damit, dasselbe Zeitfenster in voneinander getrennten Werkzeugen erneut abzufragen.

SSO-Integration und Multi-Tenancy

Die Anbindung von Grafana an Unternehmens-Identity-Provider (Okta, Azure AD, Google Workspace) und die Durchsetzung teambasierter Ordnerisolierung erfordert eine sorgfältige SAML/OIDC-Konfiguration, die sich leicht unbemerkt falsch einrichten lässt.

Lösungen, die wir entwickeln

dashboards-as-code-Standardisierung

Alle Dashboards werden in versionskontrolliertem JSON/YAML über Grafana-Provisioning definiert — vorlagen-basiert, peer-reviewed und von dev über staging bis production ohne einen einzigen manuellen UI-Klick promotet.

Vollständige LGTM-Stack-Implementierung

Grafana + Loki + Tempo + Mimir als selbst gehosteter oder Grafana-Cloud-Stack — eine vereinheitlichte Abfrageoberfläche für Logs, Distributed Traces und langfristige Metriken ohne Kardinalitätslimits pro Metrik.

RBAC, SSO und Ordnerisolierung

SAML/OIDC-Integration mit Okta, Azure AD oder Google Workspace; Ordner-RBAC, das IdP-Gruppen auf Grafana-Rollen abbildet; teamspezifische Service-Accounts für data sources mit schreibgeschütztem Minimalzugriff.

Korrelierte Observability (Logs + Metriken + Traces)

Grafana-Explore-Links und Exemplar-Annotationen korrelieren einen Loki-Log-Spike mit einer Mimir-Metrik-Anomalie und dem zugehörigen Tempo-Trace — Ursachenanalyse mit einem Klick statt drei Werkzeugwechseln.

Grafana Alerting und OnCall

Einheitliche Alert-Regeln in Grafana Alerting ersetzen das doppelte Alertmanager-Routing; Grafana OnCall verwaltet Eskalationspläne, Silences und Incident-Timelines — mit Slack-, PagerDuty- und Mattermost-Integrationen.

Multi-datasource-Integration

Dashboards in einer einzigen Ansicht, die Prometheus, Elasticsearch, PostgreSQL, CloudWatch und benutzerdefinierte API data sources kombinieren — Query-Federation ohne Datenduplizierung oder ETL-Pipelines.

Technologie-Stack

  • Grafana
  • Grafana Loki (Logs)
  • Grafana Tempo (Traces)
  • Grafana Mimir (Metriken)
  • Grafana Alerting
  • Grafana OnCall
  • Prometheus
  • OpenTelemetry
  • Elasticsearch
  • PostgreSQL
  • CloudWatch
  • provisionierte dashboards-as-code
  • SSO/SAML/OIDC
  • RBAC

Compliance & Regulierung

DSGVO-konformes RBAC · SOC-2-Audit-Logging · NIS2-Incident-Transparenz · DORA-Betriebsresilienz

EU

  • GDPR — RBAC und data-source-Berechtigungen verhindern, dass personenbezogene Daten in Dashboards erscheinen; Grafana wird auf EU-Infrastruktur gehostet; Datensparsamkeit wird auf Abfrageebene durchgesetzt.
  • EU AI Act — Modell-Observability-Dashboards erfassen Inferenzlatenz, Drift-Metriken und Fehlerraten zur Unterstützung der Transparenzanforderungen für KI-Systeme.
  • NIS2 — einheitliches Monitoring über Dienste und Infrastruktur hinweg liefert die zentralisierte Incident-Transparenz-Grundlage, die NIS2 für operative Kontinuität vorschreibt.
  • DORA — korrelierte Dashboards und Grafana-OnCall-Bereitschaftspläne unterstützen die Betriebsresilienz und die Wiederherstellungszeit-Dokumentation, die DORA für Finanzinstitute vorschreibt.

US

  • SOC 2 — Grafana-Audit-Logs erfassen jede Dashboard-Änderung, jeden data-source-Zugriff und jeden Nutzer-Login; SSO-Integration sichert die Zugriffskontroll-Nachweise, die SOC-2-Type-II-Prüfer erwarten.
  • Incident-Response — Grafana Alerting und OnCall liefern die dokumentierten, nachvollziehbaren Incident-Response-Workflows, die SOC 2 und NIST CSF für operative Transparenz-Kontrollen erfordern.
  • Least-Privilege data sources — jede data source wird mit einem schreibgeschützten Service-Account bereitgestellt, der auf den minimal erforderlichen Datensatz begrenzt ist, und erfüllt damit Minimalzugriffs-Anforderungen.
  • dashboards-as-code-Audit-Trail — alle Dashboard-Definitionen liegen in versionskontrolliertem JSON/YAML vor; jede Änderung ist reviewed, genehmigt und nachvollziehbar — ein sauberes Artefakt für Compliance-Prüfungen.

Was Kunden sagen

“
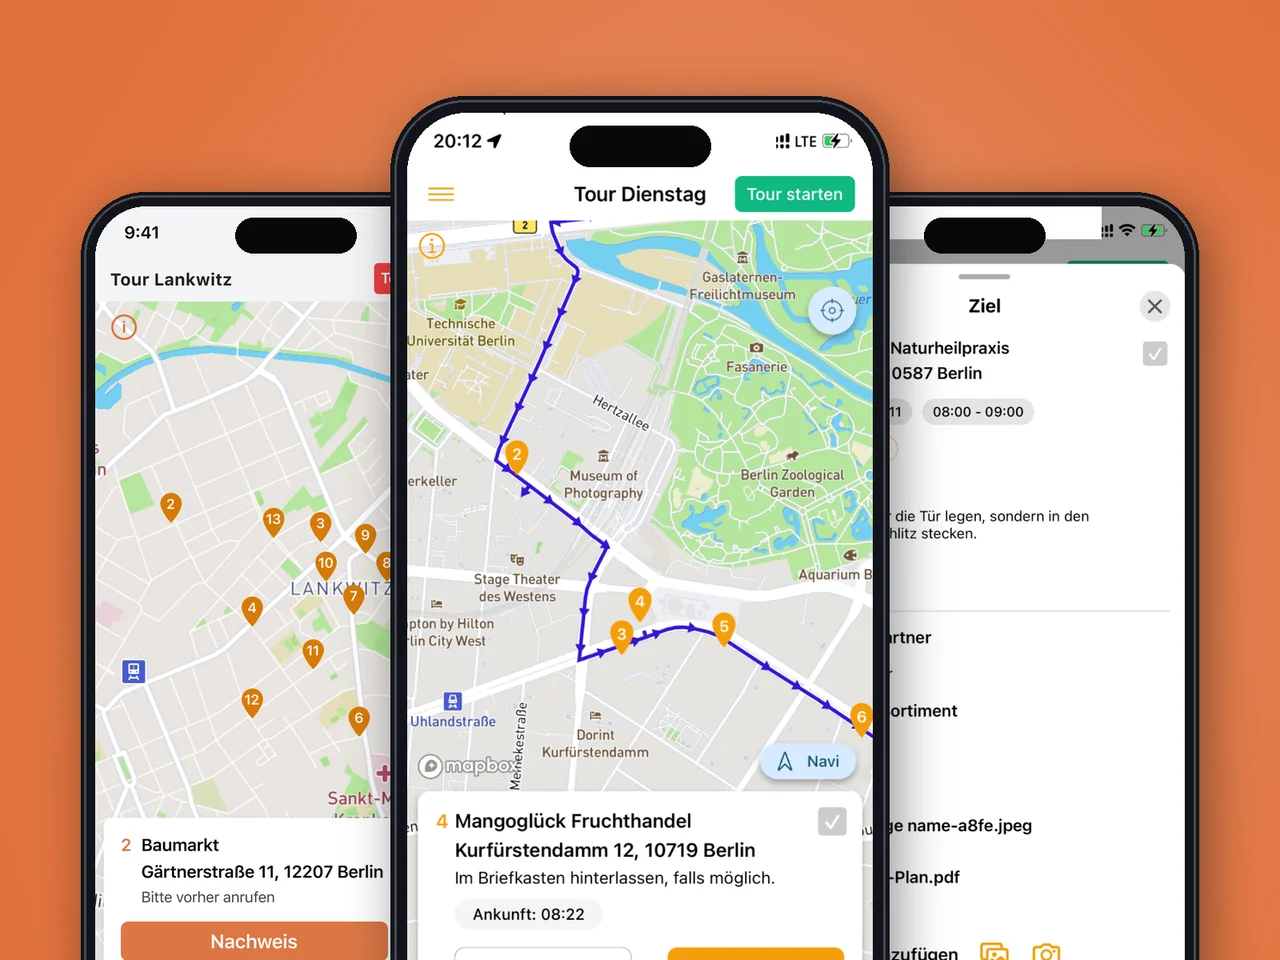
Die Legacy-Android-App hatte jahrelang angesammelten technischen Schulden und kein iOS-Pendant. YuSMP refaktorisierte den bestehenden Code, lieferte die iOS-Version und ergänzte Live-Fahrerverfolgung sowie In-App-Rechnungsstellung — ohne den täglichen Betrieb unserer Fahrer zu unterbrechen.
Markus HofmannCEO, xRouten GmbH
Fallstudie ansehen →
“
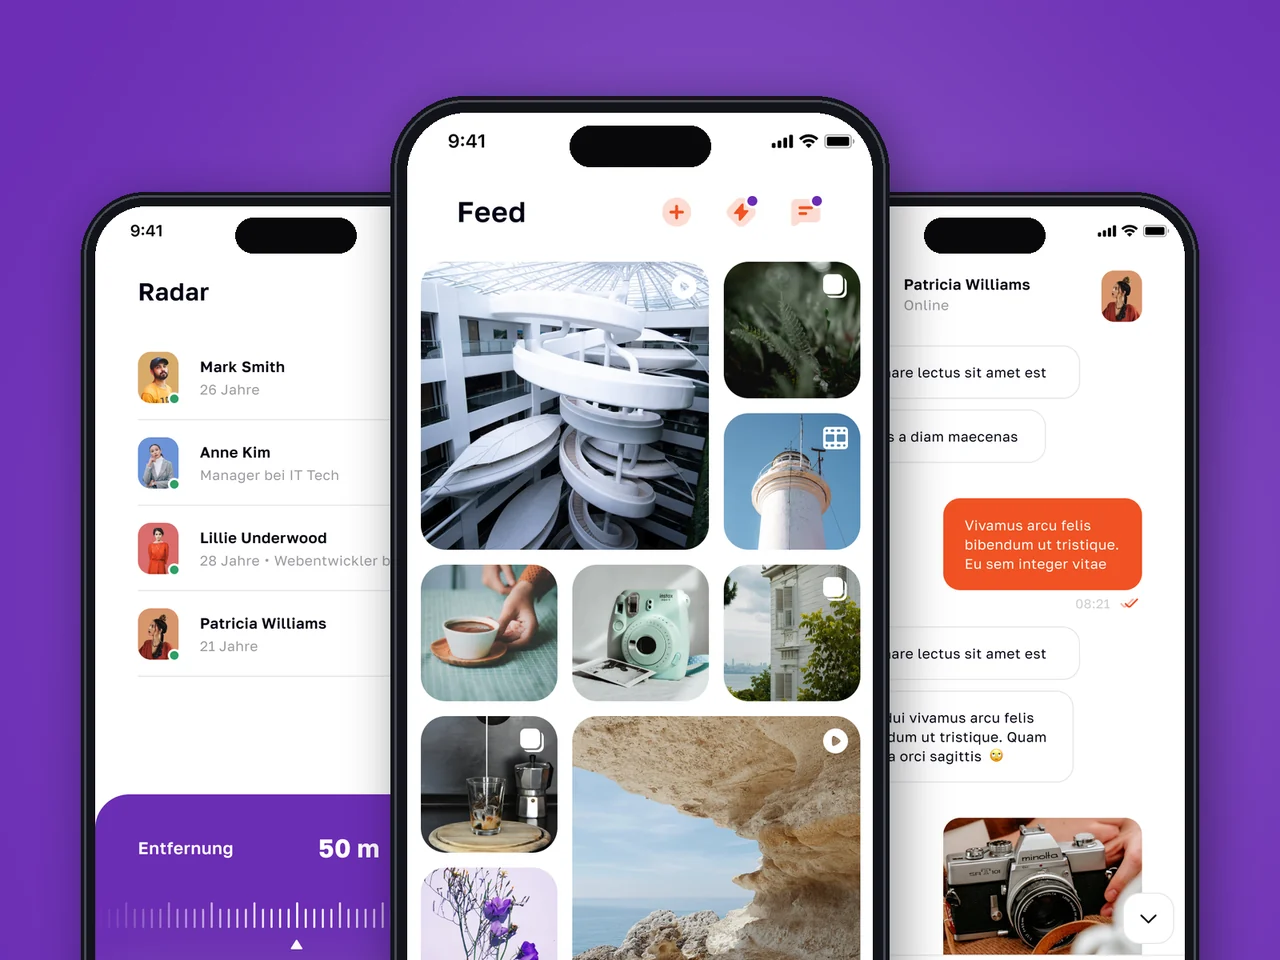
Eine Social-Plattform von Grund auf zu bauen ist Hochrisiko-Arbeit. YuSMP lieferte den Interest-Feed, Geo-Radar, Stories und die virtuelle Münzwirtschaft termingerecht — mit einer Codebasis, die unser internes Team am ersten Tag der Übergabe aufgriff.
Michael HartleyCEO, JoyJet
Fallstudie ansehen →
“
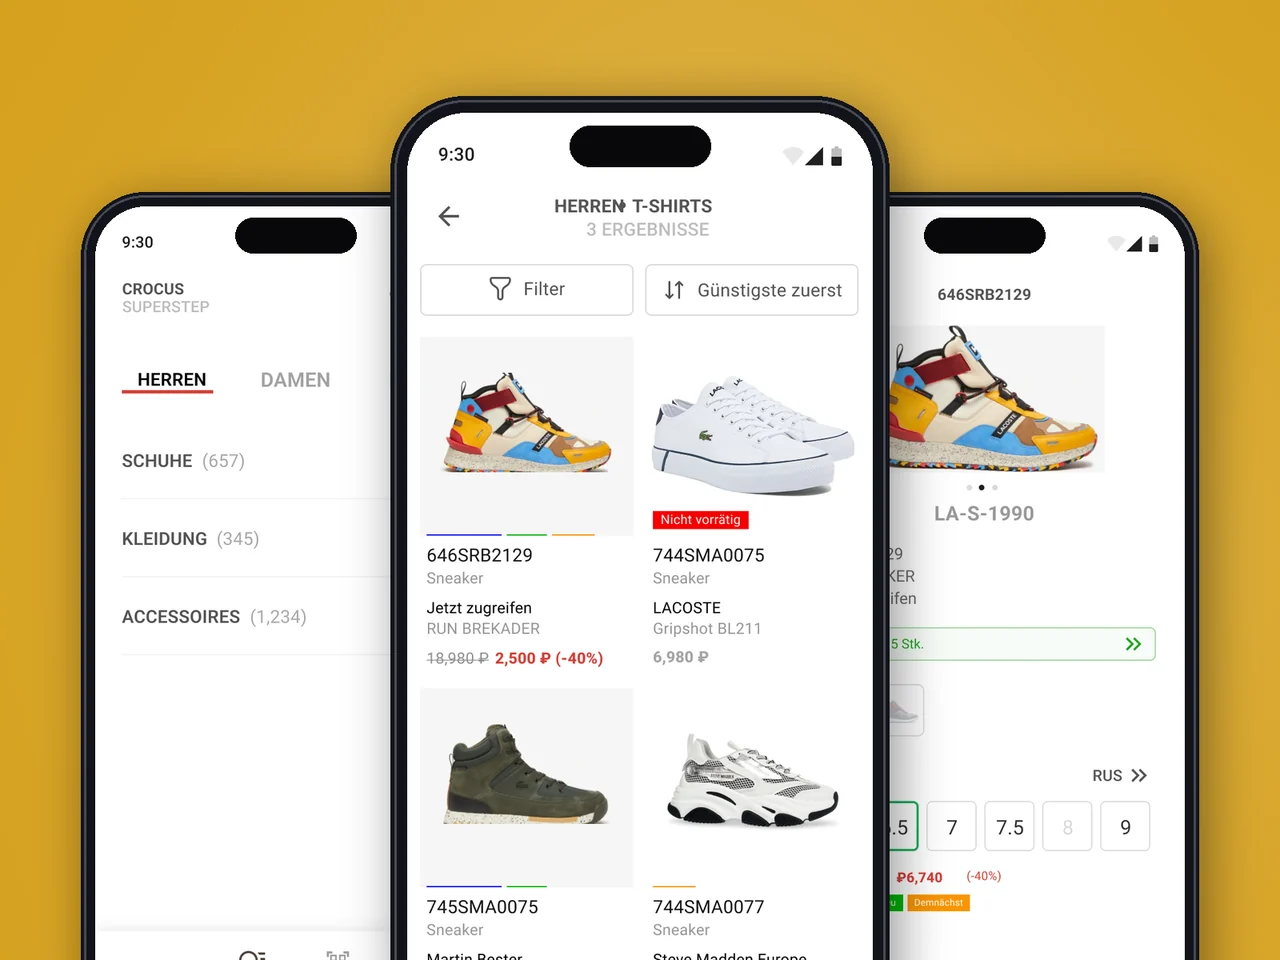
Unsere Berater verloren pro Kunde 15 Minuten für manuelle Bestandsprüfungen. YuSMP entwickelte native Apps mit ElasticSearch, in Echtzeit an unser 1C-System angebunden. Die Zeit pro Kunde sank in allen Filialen innerhalb einer Woche nach dem Launch um 40 %.
Elena FischerCTO, SuperStep
Fallstudie ansehen →
“
Eine Kreditentscheidungs-Engine, die zehnmal schneller genehmigt, entsteht nicht zufällig. YuSMP entwickelte die Scoring-Pipeline, die Integration mit Kreditbüros und ein Back-Office, das unsere Underwriter gerne nutzen. Die Genehmigungszeit sank von zwei Tagen auf unter vier Stunden.
Gregory LawsonCTO, LoanFlow
Fallstudie ansehen →

1 / 4

Warum Engineering-Teams YuSMP für Grafana-Observability wählen

Kein Vendor-Lock-in

Der vollständige LGTM-Stack ist Open-Source und selbst hostbar. Wir konzipieren Ihre Observability-Plattform so, dass Sie die Daten, die Dashboards und die Alerting-Logik besitzen — nicht das Preismodell eines SaaS-Anbieters.

Dashboards, die Teamwechsel überstehen

Versionskontrollierte, provisionierte Dashboards bedeuten, dass ein neuer Entwickler Ihre gesamte Observability-Umgebung aus einem Git-Repository wiederherstellen kann. Es gibt keine undokumentierten, ausschließlich über die UI vorgenommenen Anpassungen.

Schnellere Incident-Auflösung

Korrelierte Logs, Metriken und Traces in einer Oberfläche reduzieren die Mean Time to Root Cause. Unsere Grafana-Setups sind auf die Workflows ausgerichtet, die Ihr On-Call-Team unter Druck nutzt — nicht auf Demo-Ästhetik.

FAQ

Grafana Observability FAQ

Grafana vs Datadog — welches sollten wir wählen?

Datadog ist ein vollständig verwaltetes SaaS mit einem breiten Funktionsumfang und nutzungsbasierter Preisgestaltung, die bei hoher Kardinalität stark ansteigt. Grafana (self-hosted oder Grafana Cloud) gibt Ihnen Kontrolle über Datenresidenz, Preisgestaltung und den vollständigen LGTM-Stack. Wir empfehlen Grafana für Teams mit DSGVO-/Datensouveränitätsanforderungen, hohen Metrik-Kardinalitätsbudgets oder einer Präferenz für Open-Source-Werkzeuge — und Datadog, wenn eine verwaltete Zero-ops-Plattform die Kosten rechtfertigt.

Was ist der LGTM-Stack?

LGTM steht für Loki (Log-Aggregation), Grafana (Visualisierung und Alerting), Tempo (Distributed Tracing) und Mimir (langfristige, skalierbare Metriken als Drop-in-Ersatz für Prometheus). Zusammen bilden sie eine selbst gehostete Observability-Plattform, die alle drei Telemetrie-Säulen — Logs, Metriken und Traces — unter einer einzigen Grafana-Oberfläche abdeckt, ohne dass für jeden Signaltyp separate Spezialisierungswerkzeuge erforderlich sind.

Was bedeutet dashboards-as-code in Grafana?

Grafanas Provisioning-System liest Dashboard-JSON und data-source-YAML aus Dateien auf der Festplatte (oder einem Git-Repository über Werkzeuge wie Grafonnet oder Terraform). Das bedeutet, jedes Dashboard ist versionskontrolliert, code-reviewed und in allen Umgebungen reproduzierbar. Änderungen werden über CI/CD statt durch manuelle UI-Bearbeitungen eingespielt — mit vollständigem Audit-Trail und der Möglichkeit, eine fehlerhafte Dashboard-Änderung in Sekunden zurückzurollen.

Wie funktioniert Grafana mit Prometheus?

Prometheus erfasst Metriken von Ihren Diensten und speichert sie lokal; Grafana fragt Prometheus (oder Mimir, ein skalierbares Prometheus-kompatibles Backend) via PromQL ab und stellt die Ergebnisse als Panels dar. Grafana ersetzt Prometheus nicht — es ist die Visualisierungs- und Alerting-Schicht darüber. In einem typischen LGTM-Setup ersetzt Mimir den lokalen Prometheus-Speicher für Langzeitaufbewahrung und horizontale Skalierbarkeit, während Prometheus-Agenten weiterhin am Edge erfassen.

Wie konfigurieren Sie RBAC, SSO und Multi-Tenancy in Grafana?

Wir konfigurieren Grafanas SAML- oder OIDC-Integration gegen Ihren Identity Provider (Okta, Azure AD, Google Workspace). IdP-Gruppen werden auf Grafana-Organisationsrollen und Ordnerberechtigungen gemappt. Jedes Team sieht nur die Dashboards und data sources, die seinem Ordner zugewiesen sind. In Multi-Tenant-Deployments bieten Grafana-Organisationen oder das RBAC von Grafana Enterprise harte Mandantengrenzen mit separaten data-source-Zugangsdaten pro Mandant.

Loki vs Elasticsearch für Log-Aggregation — was ist besser?

Loki indiziert nur Labels (kein Volltext), was den Betrieb im großen Maßstab erheblich günstiger macht — es speichert komprimierte Log-Chunks in Objektspeicher (S3, GCS). Elasticsearch indiziert jedes Feld und ermöglicht leistungsstarke Volltextsuche, jedoch bei deutlich höheren Speicher- und Rechenkosten. Wählen Sie Loki, wenn Sie Ihre Log-Struktur kontrollieren und primär nach Labels (Dienst, Umgebung, Level) abfragen; wählen Sie Elasticsearch, wenn Sie beliebige Volltextsuche über unstrukturierte Legacy-Logs benötigen oder das Kibana-Ökosystem erforderlich ist.

Sollten wir Grafana selbst hosten oder Grafana Cloud nutzen?

Self-hosted Grafana (OSS oder Enterprise) gibt Ihnen vollständige Kontrolle über Datenresidenz, Aufbewahrung, Kosten und Konfiguration — die richtige Wahl bei strengen DSGVO-/Datensouveränitätsanforderungen oder hohen Metrik-Volumina, bei denen Grafana Cloud preislich ins Gewicht fällt. Grafana Cloud beseitigt operativen Aufwand und bietet verwaltetes Alerting, synthetisches Monitoring und Frontend-Observability von Haus aus. Wir helfen Teams, den Build-vs-Buy-Abwägungsprozess zu evaluieren, und können beide Optionen einrichten oder migrieren.

Produktionsreife Grafana-Observability mit erfahrenen Platform Engineers einführen

Sagen Sie uns, wo Sie in zwölf Monaten stehen möchten. Wir liefern Ihnen einen Plan, um dorthin zu gelangen.

Angebot anfordern

Antwort innerhalb eines Werktags. NDA auf Anfrage.

Angebot anfordern

Teilen Sie uns einige Details mit, und ein Senior-Consultant antwortet innerhalb eines Werktages.

Kostenlose Projektschätzung – Sie erhalten innerhalb von 1–2 Werktagen einen Plan.
  • Analyse der Anforderungen und Empfehlungen zum Tech-Stack
  • Schätzung von Zeitrahmen, Budget und Teamzusammensetzung
  • Unverbindlich – einfach ein klarer Plan

E-Mail: sales@yusmpgroup.com

Telefon: +374 44 871 811

Büros: KAMAR Business Center, Vazgen Sargsyan Str. 2, Yerevan, Armenien · Remote — Überlappung mit der US-Ostküste (9–13 Uhr ET)

– Pflichtfelder