Blog News Kontakt Angebot anfordern

PostgreSQL Engineering-Leistungen für hochdurchsatzfähige Produktionssysteme

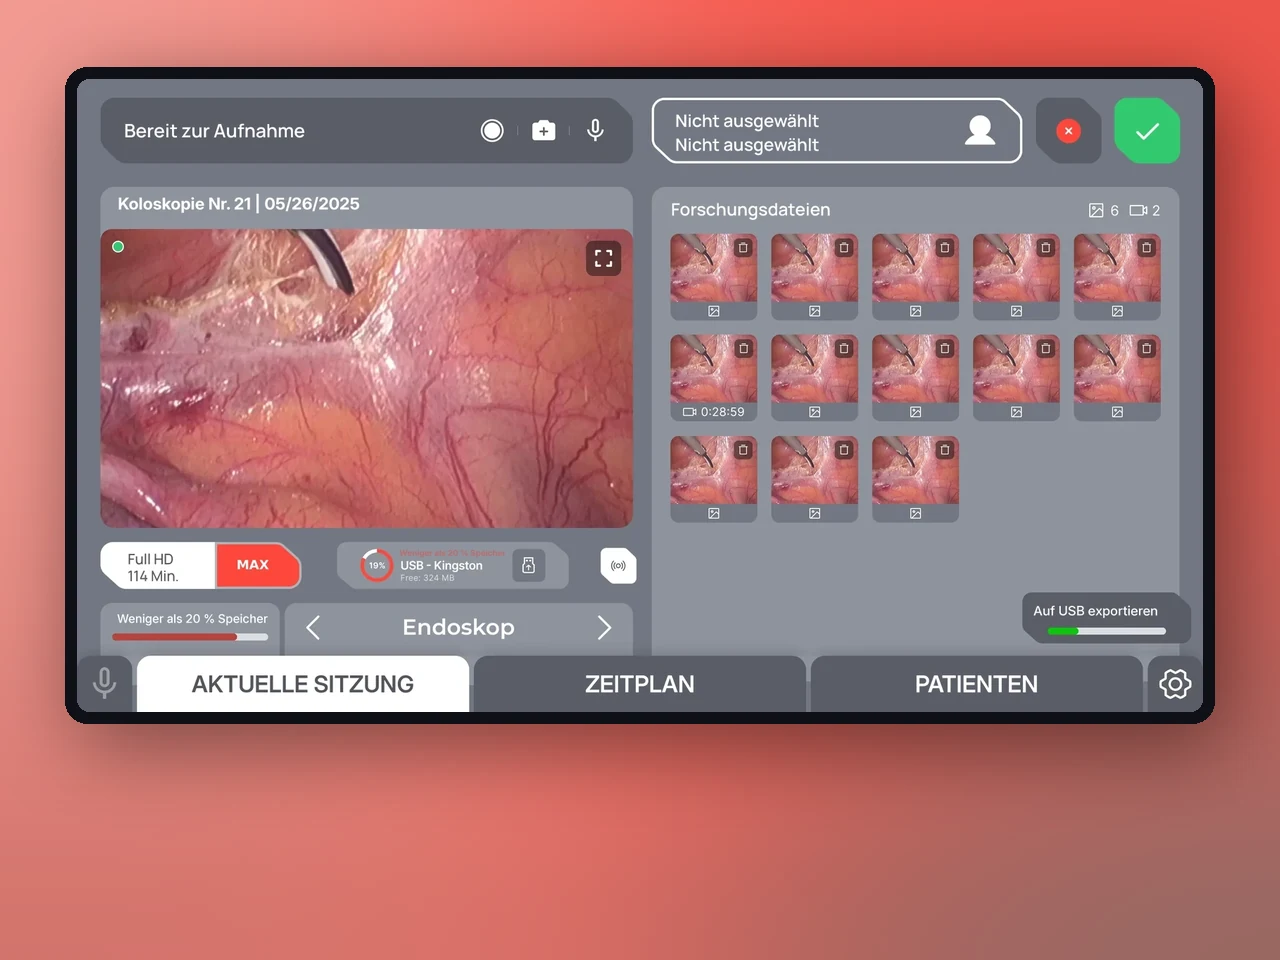
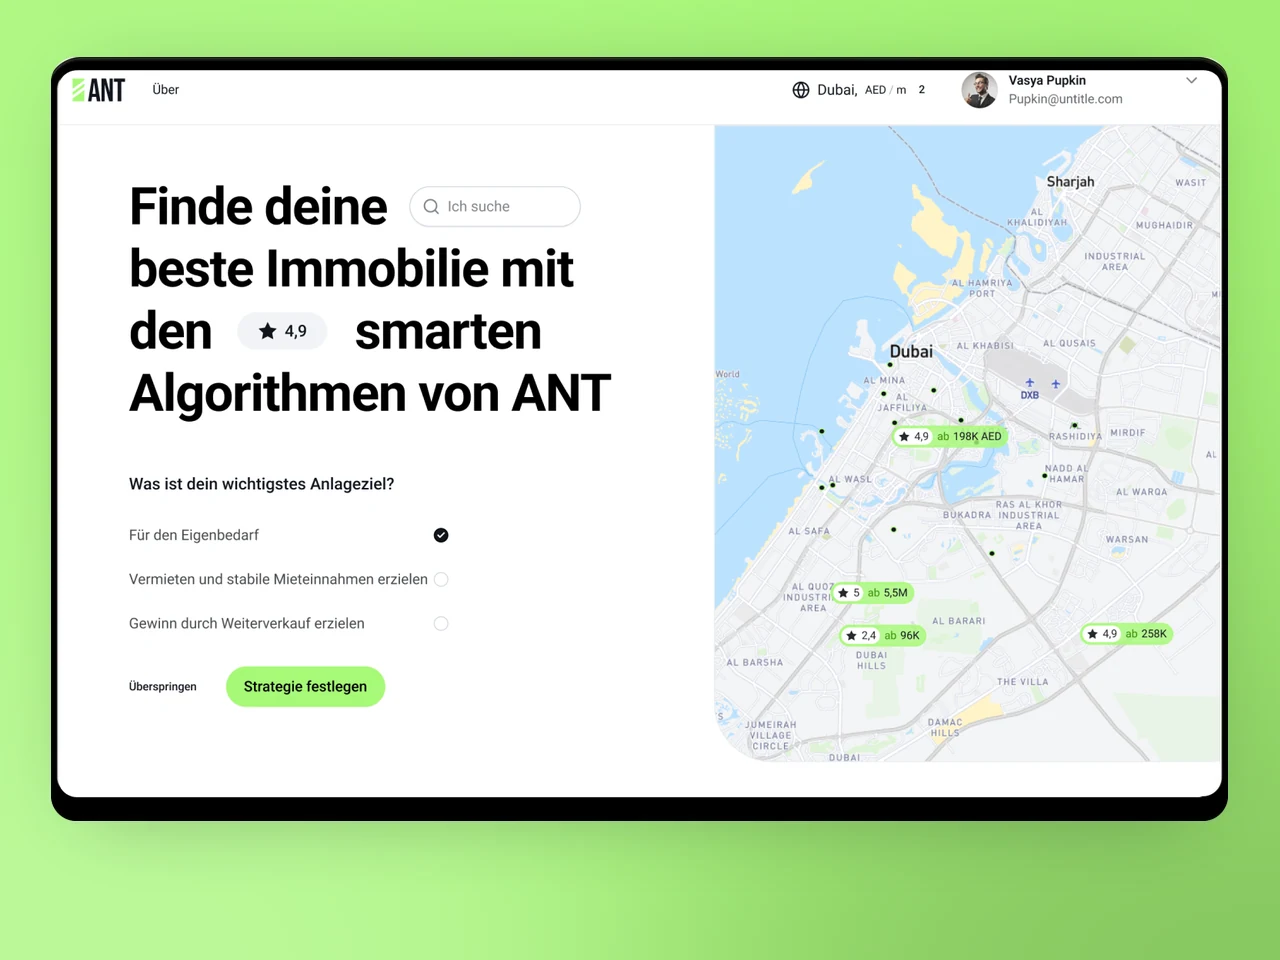
Zweiundvierzig unserer Produktionssysteme laufen auf PostgreSQL — Loan Conveyors Kreditentscheidungs-Engine, die Tausende von Kreditentscheidungen pro Tag verarbeitet, ANTs PropTech-Marktplatz mit Volltextsuche und Geospatial-Abfragen, ArgoViews klinische Workstation mit DICOM-Metadaten und pgvector-Embeddings. Schema-Design, Query-Tuning, Partitionierung, logische Replikation und HA — alles in unserem Portfolio.

  • PostgreSQL 17
  • pgvector
  • pg_partman
  • pg_stat_statements

Wir liefern PostgreSQL Engineering für SaaS-Plattformen, die von Anfang an Schema-Design, Query-Optimierung und HA-Setup benötigen; FinTech- und HealthTech-Systeme, die Audit-Trail-Schemata, Row-Level Security und DSGVO-konforme Löschung erfordern; KI-Teams, die pgvector für RAG und semantische Suche hinzufügen, ohne neue Infrastruktur einzuführen; sowie regulierte Branchen, wo PITR-Backups, Datenhaltung und Verschlüsselung im Ruhezustand Lieferanforderungen sind.

Branchenherausforderungen, die wir lösen

Langsame Abfragen bei 100M+ Zeilen

Tabellenscans auf großen Tabellen sprengen Query-Zeitbudgets. Wir führen EXPLAIN (ANALYZE, BUFFERS) aus, fügen gezielte Partial- und Expression-Indizes hinzu und implementieren deklarative Partitionierung zur Scan-Bereichsbegrenzung.
Autovacuum-Lag und Tabellen-Bloat

Hochschreib-Workloads akkumulieren Dead-Tuples schneller als Autovacuum sie bereinigt. Wir stimmen Autovacuum-Schwellenwerte pro Tabelle ab und planen explizites VACUUM ANALYZE auf heißen Tabellen während Niedriglast-Fenstern.

Multi-Tenant-RLS-Konfigurationslecks

Fehlende oder falsch konfigurierte RLS-Policies lecken Zeilen zwischen Mandanten auf Datenbankebene. Wir erzwingen RLS auf jeder Tabelle, schreiben mandantenübergreifende Isolationstests und fügen Canary-Zeilen hinzu, die alarmieren, wenn sie in der falschen Mandantenabfrage erscheinen.

pgvector-Index-Auswahl

Die Wahl zwischen HNSW und IVFFlat für pgvector hängt von Recall-Anforderungen, Aktualisierungshäufigkeit und Query-Latenz-SLA ab. Wir benchmarken beide auf Ihrer Datenform, bevor wir uns auf einen Index-Typ festlegen.

Logische Replikations-Lag bei ausgelasteten Primärsystemen

Hohes Schreibvolumen veranlasst Replikations-Slots, WAL anzuhäufen und den Datenträger auf gefährliche Levels wachsen zu lassen. Wir überwachen Slot-Lag, setzen wal_keep_size-Schutzmaßnahmen und implementieren Slot-Failover für Zero-Data-Loss-Umstellung.

DSGVO-Recht-auf-Löschung-Nachbesserungen

Die Anonymisierung von PII in einem bestehenden Schema ohne Soft-Delete-Design erfordert sorgfältige Migrationsplanung. Wir integrieren Löschkonzepte in neue Schemata und stellen Migrations-Playbooks für bestehende bereit.

Lösungen, die wir entwickeln

Schema-Design und DDD-Modellierung

Domain-Driven-Schema-Design mit klaren Aggregat-Grenzen, Audit-Tabellen, Soft-Delete und ab der ersten Migration eingebauten RLS-Policies.

Performance-Tuning und EXPLAIN-Audits

Query-Plan-Analyse, Index-Empfehlungen, Connection-Pool-Dimensionierung und Autovacuum-Tuning — als priorisierter Sanierungsbericht geliefert.

Partitionierung im großen Maßstab

Deklarative Range-, List- und Hash-Partitionierung mit pg_partman-Automatisierung für Zeitreihen- und Multi-Tenant-Tabellen.

pgvector-RAG-Indizes

HNSW- und IVFFlat-Index-Setup für semantische Suche und RAG-Retrieval — vor dem Produktions-Deployment gegen Ihr Korpus benchmarkt.

HA- und PITR-Setup

Patroni oder RDS Multi-AZ mit pgBouncer, WAL-G-Kontinuierlichem-Archivieren und getesteten Point-in-Time-Recovery-Verfahren.

Logische Replikations-Migrationen

Zero-Downtime-Major-Versions-Upgrades und Cross-Cloud-Migrationen über logische Replikation mit Umstellungsfenstern unter 60 Sekunden.

Technologie-Stack

  • PostgreSQL 17
  • pgvector
  • pg_partman
  • pg_stat_statements
  • pgBouncer
  • Patroni
  • WAL-G
  • TimescaleDB
  • PostGIS
  • logical replication
  • RDS
  • Aurora
  • EXPLAIN (ANALYZE)

Compliance & Vorschriften

DSGVO-konform · HIPAA-berechtigt · SOC-2-fähig · PCI-DSS-bewusst

EU

  • DSGVO — Datenhaltung, Recht auf Löschung, DSR-Automatisierung über RLS.
  • ISO 27001 — Verschlüsselung im Ruhezustand, Zugangskontrolle, Audit-Protokollierung.
  • DORA — PITR- und DR-Dokumentation für finanzielle IKT-Systeme.
  • eHDSI / DSGVO — Gesundheitsdatenhaltung und Pseudonymisierung.

US

  • HIPAA — Verschlüsselung im Ruhezustand und bei der Übertragung, Audit-Log, BA-Abdeckung.
  • PCI DSS Req. 3.4 — PAN-Maskierung, Tokenisierung, Verschlüsselung für Kartendaten.
  • SOC 2 — Backup-Test-Nachweise, Zugriffsüberprüfung, Änderungskontrolle.
  • CCPA — Implementierung des Rechts auf Löschung und Anonymisierungs-Playbooks.

Gemeinsam: TLS bei der Übertragung, pgcrypto für Spaltenverschlüsselung, SBOM für Erweiterungen.

Was Kunden sagen

“
Eine Kreditentscheidungs-Engine, die zehnmal schneller genehmigt, entsteht nicht zufällig. YuSMP entwickelte die Scoring-Pipeline, die Integration mit Kreditbüros und ein Back-Office, das unsere Underwriter gerne nutzen. Die Genehmigungszeit sank von zwei Tagen auf unter vier Stunden.
Gregory LawsonCTO, LoanFlow
Fallstudie ansehen →
“
Klinische Workflow-Software, die Krankenhäuser tatsächlich übernehmen, ist selten. YuSMP entwickelte eine iPad-first-Endoskopie-Plattform mit HD-Videoaufzeichnung, DICOM-Export und HL7-Integration. Das medizinische Personal brauchte kaum Schulung, weil das UX wirklich intuitiv ist.
Dr. Claire FontaineProduct Director, ArgoView
Fallstudie ansehen →
“
Wir veröffentlichen täglich Dutzende Sportartikel. YuSMP entwickelte eine Redaktionspipeline mit einem Telegram-Bot als CMS — Redakteure posten einmal, und der Inhalt erscheint sofort auf Web, iOS und Android. Die Architektur erfordert null tägliche Wartung.
Ryan O'ConnorCEO, Media Arena
Fallstudie ansehen →
“
Telecom-Self-Service ist nur nützlich, wenn Kunden ihn dem Anruf beim Support vorziehen. YuSMP entwickelte iOS- und Android-Apps mit Guthaben-Management, Tarifwechsel und Nutzungsanalysen, die unser Call-Centre-Volumen im ersten Quartal nach dem Launch um 30 % reduzierten.
Charles DuboisDirector of Digital Products, TelecomSelf
Fallstudie ansehen →

1 / 4

Warum Teams YuSMP für PostgreSQL wählen

42 Produktionssysteme auf Postgres

Mehr PostgreSQL-Produktionserfahrung als mit jeder anderen Datenbank in unserem Portfolio — über FinTech-Entscheidungs-Engines, HealthTech-klinische Systeme und hochfrequentierte Marktplätze hinweg.

pgvector für KI in Ihrem bestehenden Stack

Wir fügen semantische Suche und RAG-Retrieval zu Ihrem PostgreSQL hinzu, ohne neue Infrastruktur einzuführen — HNSW-Indizes, SQL-Joins, ACID-Konsistenz.

DSGVO-Löschung und HIPAA-bereit

Recht-auf-Löschung, Anonymisierungs-Playbooks und PITR-Backup-Tests — im Schema entworfen, nicht beim Audit nachgerüstet.

FAQ

PostgreSQL FAQ

Wie optimieren Sie PostgreSQL für große Tabellen (100M+ Zeilen)?

Deklaratives Partitionieren (range oder list) zur Einschränkung des Scan-Bereichs, gezielte Indexierung mit Partial- und Expression-Indizes, Autovacuum-Tuning gegen Table-Bloat und Query-Plan-Analyse mit EXPLAIN (ANALYZE, BUFFERS). Wir evaluieren außerdem pg_partman für automatisches Partition-Management und TimescaleDB für Time-Series-Workloads.

Wie implementieren Sie mandantenfähige Row-Level Security?

PostgreSQL Row-Level Security Policies mit einer current_setting('app.tenant_id')-Kontextvariable — durchgesetzt auf Datenbankebene, nicht nur auf Applikationsebene. Jedes SELECT, INSERT, UPDATE und DELETE wird durch RLS gefiltert. Wir schreiben mandantenübergreifende Canary-Tests zur Verifizierung der Isolation.

pgvector oder eine dedizierte Vektordatenbank?

pgvector auf Ihrer bestehenden PostgreSQL-Instanz für Teams, die transaktionale Konsistenz zwischen Vektorsuche und relationalen Daten benötigen — keine neue Infrastruktur, SQL-Joins, ACID-Garantien. Dediziertes Qdrant oder Weaviate für Workloads, die gefilterte Vektorsuche im großen Maßstab (100M+ Vektoren) oder Multi-Modal-Indexierung erfordern. Wir haben Produktionserfahrung mit beiden.

Wie richten Sie PostgreSQL-Hochverfügbarkeit ein?

Patroni on-premises oder auf Cloud-VMs für Auto-Failover mit etcd-Quorum. RDS Multi-AZ oder Aurora PostgreSQL in der verwalteten Cloud. Wir ergänzen pgBouncer Connection-Pooling im Transaction-Mode vor jedem HA-Setup und testen Failover mit realem Applikationstraffic in Staging.

Wie handhaben Sie PostgreSQL-Backups und Point-in-Time-Recovery?

WAL-G für kontinuierliches WAL-Archiving nach S3 oder GCS, was Point-in-Time-Recovery auf jede Sekunde innerhalb des Aufbewahrungsfensters ermöglicht. pg_dump für logische Backups einzelner Datenbanken. Wir testen die Wiederherstellung in einer Staging-Umgebung wöchentlich und dokumentieren den RTO im DR-Runbook.

Wie implementieren Sie PostgreSQL-logische-Replikation für Zero-Downtime-Migrationen?

Wir richten logische Replikation von der Quelle zum Ziel ein, lassen das Replikat aufholen, führen ein kurzes applikationsseitiges Read-only-Fenster zum Leeren laufender Schreibvorgänge durch, wechseln den Connection-String und bauen die Replikation ab. Typisches Cutover-Fenster: unter 60 Sekunden für die meisten Applikations-Stacks.

Wie gehen Sie das DSGVO-Recht auf Löschung in PostgreSQL an?

Wir implementieren Soft-Delete mit einem deleted_at-Timestamp und einen DSGVO-Löschjob, der PII-Spalten durch einen SHA-256-Hash der Subject-ID ersetzt. Für irreversible Anonymisierung verwenden wir PostgreSQL's UPDATE ... RETURNING und ein Lösch-Audit-Log. Der Ansatz muss von Anfang an ins Schema eingebaut werden — nachträgliches Einrüsten erfordert eine geplante Migration.

PostgreSQL mit erfahrenen Entwicklern schnell, prüfbar und KI-bereit machen

Sagen Sie uns, wo Sie in zwölf Monaten stehen möchten. Wir liefern Ihnen einen Plan, um dorthin zu gelangen.

Angebot anfordern

Antwort innerhalb eines Werktages. NDA auf Anfrage.

Angebot anfordern

Teilen Sie uns einige Details mit, und ein Senior-Consultant antwortet innerhalb eines Werktages.

Kostenlose Projektschätzung – Sie erhalten innerhalb von 1–2 Werktagen einen Plan.
  • Analyse der Anforderungen und Empfehlungen zum Tech-Stack
  • Schätzung von Zeitrahmen, Budget und Teamzusammensetzung
  • Unverbindlich – einfach ein klarer Plan

E-Mail: sales@yusmpgroup.com

Telefon: +374 44 871 811

Büros: KAMAR Business Center, Vazgen Sargsyan Str. 2, Yerevan, Armenien · Remote — Überlappung mit der US-Ostküste (9–13 Uhr ET)

– Pflichtfelder