Blog News Kontakt Angebot anfordern

Elasticsearch Engineering-Leistungen für schnelle Suche und Analyse

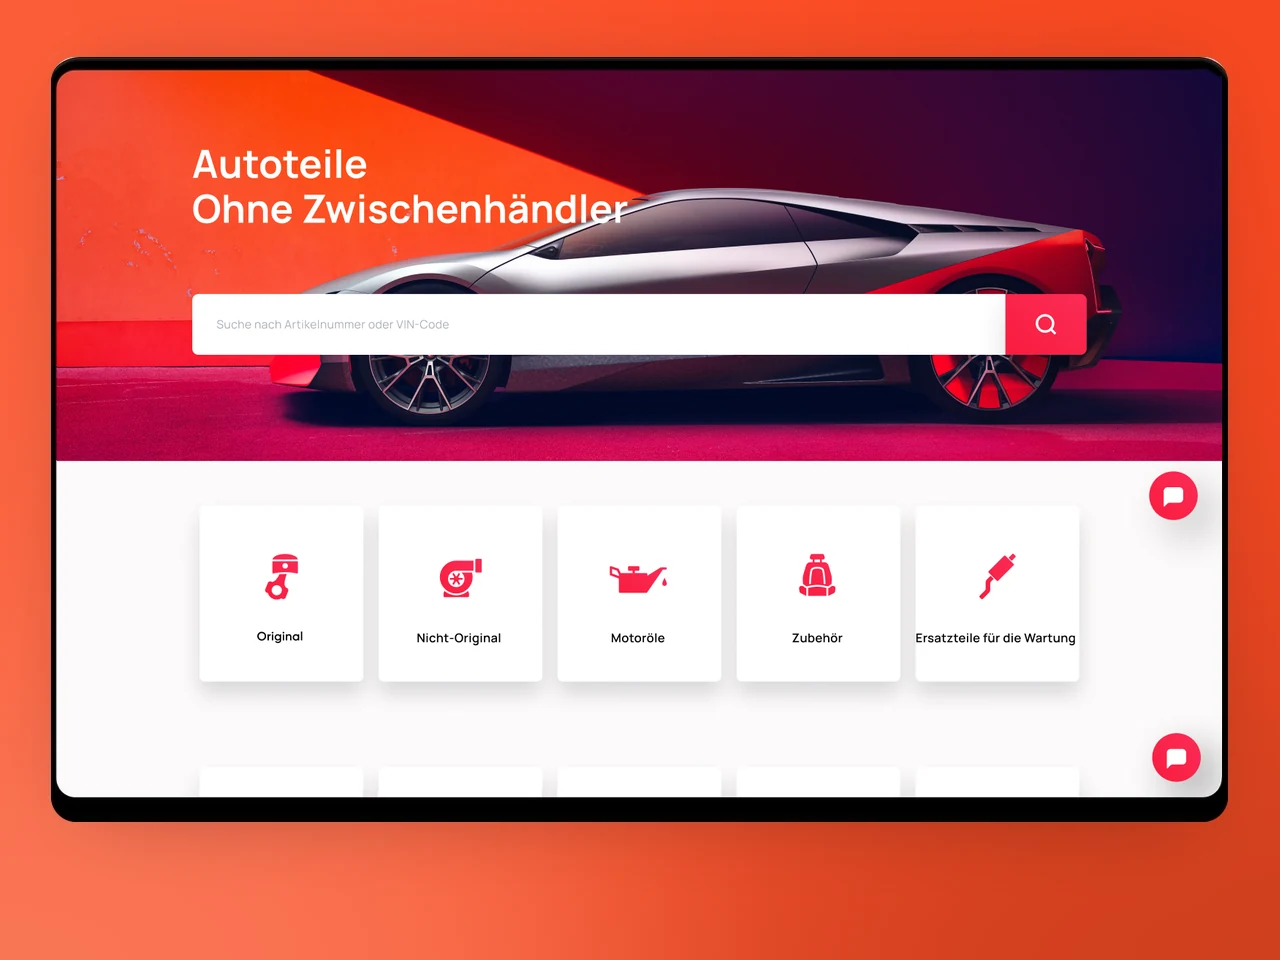
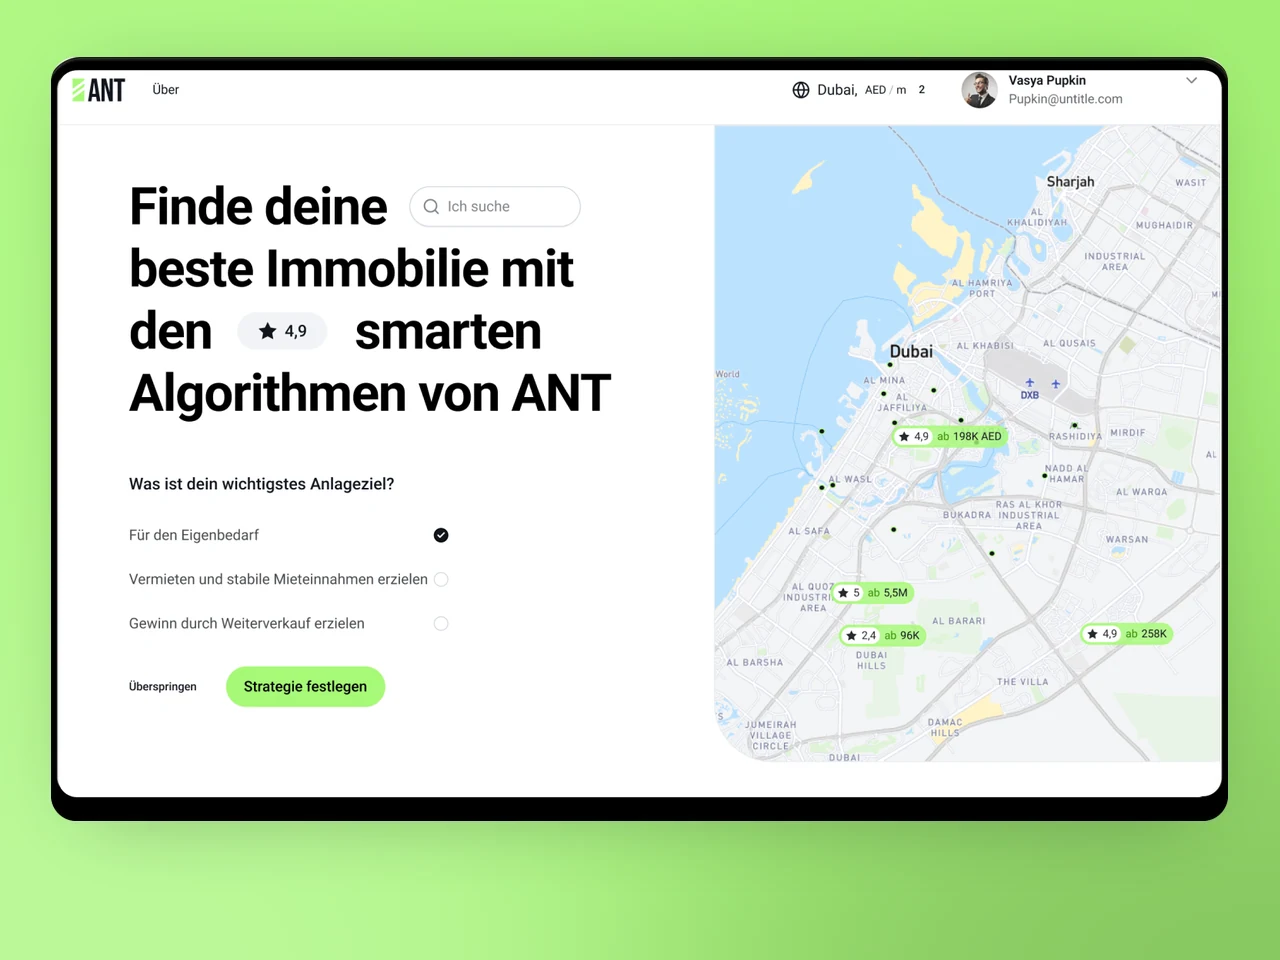
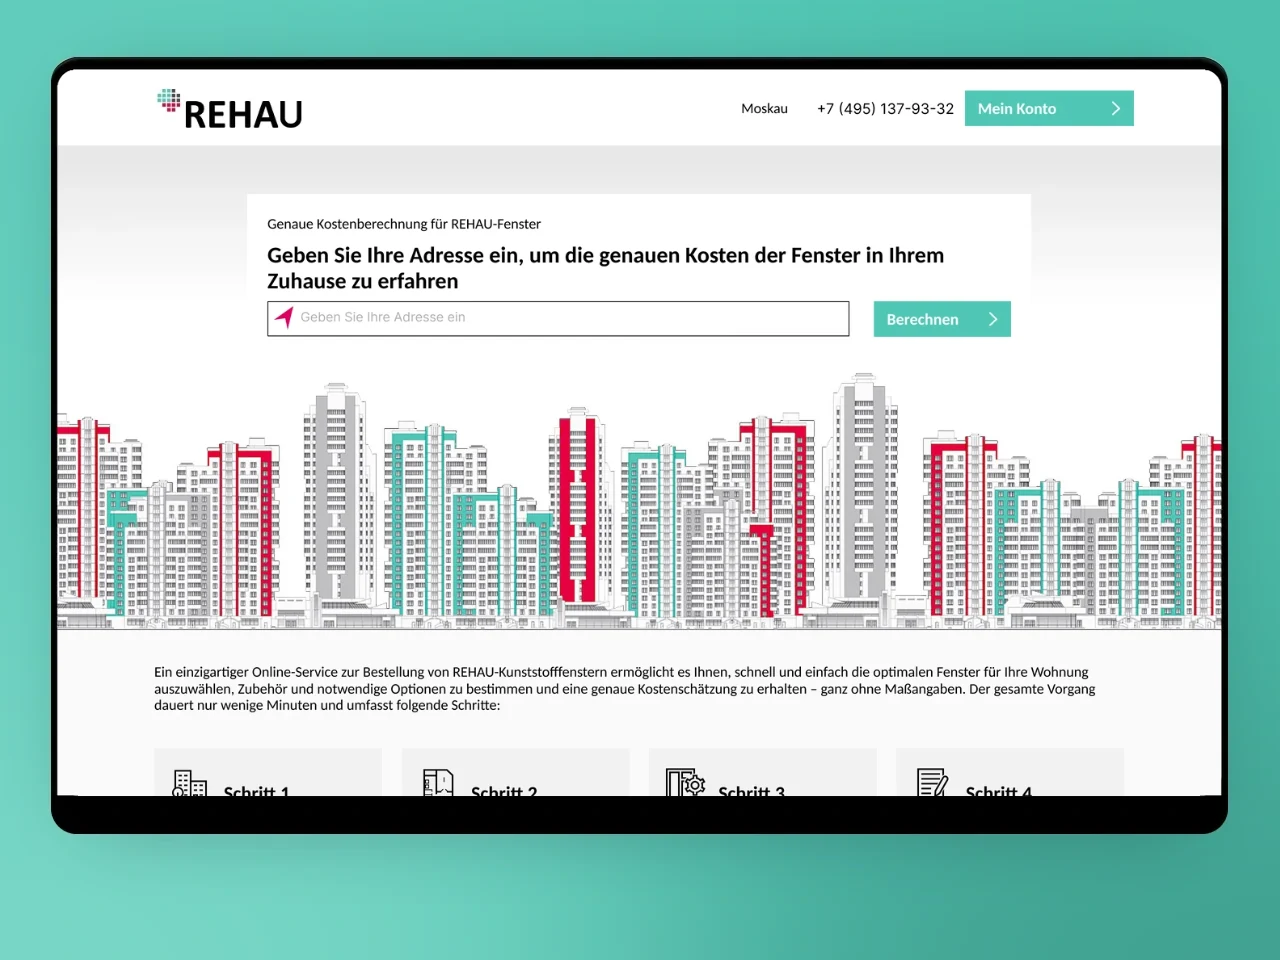
Elasticsearch treibt die Suche in drei unserer meistfrequentierten Produktionssysteme an — ANTs PropTech-Marktplatz mit mehrsprachiger Immobiliensuche und Geo-Filtern, REHAUs B2B-Portal mit SAP-synchronisiertem Produktkatalog, AutoParts' Kompatibilitätssuche mit filialübergreifendem Inventar. Facettierte Suche, Vektor-kNN, ILM-Kostenabstufung und Zero-Downtime-Reindizierung — alles Standard in unseren Elasticsearch-Deployments.

  • Elasticsearch 8
  • OpenSearch 2
  • Amazon OpenSearch Service
  • Kibana

Wir liefern Elasticsearch- und OpenSearch-Engineering für Produktkataloge und Marktplätze mit facettierter Suche, B2B-Portale mit ERP-synchronisiertem Inventar, Observability-Plattformen, die strukturierte Logs und Metriken aufnehmen, und KI-Teams, die hybride BM25+Vektorsuche für semantisches Retrieval hinzufügen. Mapping-Design, Shard-Strategie, ILM-Kostenabstufung und Zero-Downtime-Reindizierung sind Teil jedes Engagements.

Branchenherausforderungen, die wir lösen

Mapping-Explosion durch dynamische Felder

Unbegrenztes dynamisches Mapping erstellt Tausende von Feldern, bläht den Cluster-State auf und verschlechtert die Performance. Wir mappen alle Felder explizit und deaktivieren dynamisches Mapping auf Ingestion-Indizes.
Shard-Count-Überprovisionierung

Zu viele kleine Shards verschwenden Heap-Memory und verlangsamen die Suche. Wir zielen auf 20–50 GB pro Shard und verwenden ILM-Rollover-Policies, um unkontrollierte Shard-Vermehrung zu verhindern.

Ungenauigkeit der Facetten-Zähler nach dem Filtern

Post-Query-Facetten-Aggregationen spiegeln nur den gefilterten Ergebnissatz wider, nicht das gesamte Korpus. Wir implementieren Post-Filter, um Facetten-Zähler genau zu halten.

Ausfallzeit bei der Reindizierung

Mapping-Änderungen an Live-Indizes erfordern eine Reindizierung — die naiv den Produktionstraffic blockiert. Wir verwenden Index-Aliasse für Zero-Downtime-Reindizierung mit der Reindex-API.

Index-Sync-Divergenz von der Quelle der Wahrheit

Anwendungs-Dual-Write übersieht Fehler lautlos und weicht von PostgreSQL ab. Wir ersetzen Dual-Write durch eine CDC-Debezium-Pipeline für garantierten Sync.

Speicherkostenwachstum

Log- und Analytics-Indizes wachsen ohne ILM unbegrenzt. Wir implementieren Hot-Warm-Cold-Delete-Tiering mit automatisierten Phasenübergängen.

Lösungen, die wir entwickeln

Marktplatz-Facettensuche

Mehrsprachige Analyse, Facetten, Geosuche, Inventar-Sync und Relevanz-Tuning für Produktkataloge.

B2B-Katalogsuche

ERP-synchronisierte Produktsuche mit Teilenummer-Lookup, mandantenübergreifenden ACL-Filtern und strukturierter Datenextraktion.

Hybride BM25 + Vektorsuche

Lexikalische und semantische Suche kombiniert mit RRF für RAG-Retrieval und Empfehlungssysteme.

Log- und Event-Analytik

Observability-Pipelines, die strukturierte Logs, APM-Traces und Metriken mit Kibana-Dashboards und Alerting aufnehmen.

Zero-Downtime-Reindizierung

Aliasbasierte Reindizierungsstrategie für Mapping-Migrationen und Analyser-Änderungen ohne Such-Ausfallzeit.

ILM-Kostenoptimierung

Hot-Warm-Cold-Delete-Tiering, Shard-Konsolidierung und Force-Merge auf schreibgeschützten Indizes zur Reduzierung der Speicherkosten.

Technologie-Stack

  • Elasticsearch 8
  • OpenSearch 2
  • Amazon OpenSearch Service
  • Kibana
  • OpenSearch Dashboards
  • Logstash
  • Beats
  • Debezium
  • ILM
  • kNN vector search
  • RRF
  • Terraform

Compliance & Vorschriften

GDPR-aligned · SOC 2-capable · HIPAA-capable · CCPA-acknowledged

EU

  • DSGVO — Datenhaltung auf Index-Ebene, Recht auf Löschung über delete-by-query.
  • ISO 27001 — Zugangskontrolle, Audit-Protokollierung, Verschlüsselung im Ruhezustand.
  • NIS2 — Log-Aufbewahrung, Incident Response, Observability-Pipelines.
  • DSA — Inhaltsmoderation-Audit-Trails, Betroffenenrechte.

US

  • SOC 2 — Audit-Log-Indizierung, Zugangskontrolle, Monitoring-Pipelines.
  • HIPAA — PHI-Maskierung, Zugriffsprotokollierung, Verschlüsselung im Ruhezustand und bei der Übertragung.
  • CCPA — delete-by-query für Verbraucher-Datenlöschungsanfragen.
  • PCI DSS — Ausschluss von Karteninhaberdaten aus Such-Indizes, Audit-Protokollierung.

Gemeinsam: TLS + mTLS, rollenbasierte Index-ACLs, SBOM für Client-Bibliotheken.

Was Kunden sagen

“
Echtzeit-ERP-Synchronisation für einen Autoteile-Katalog ist schwieriger als es aussieht — Preise ändern sich stündlich und der Katalog ändert sich ständig. YuSMP entwickelte eine bidirektionale 1C-Integration, die einfach funktioniert, mit einem übersichtlichen Storefront, den Kunden reibungslos nutzen.
Kevin BrandtCTO, AutoParts
Fallstudie ansehen →
“
B2B-Commerce für eine Polymerproduktmarke bedeutet komplexe Produktkonfiguratoren, Händlerpreisstufen und Bestellworkflows. YuSMP entwickelte eine Plattform, die unsere Händler ohne eine einzige Schulung übernahmen. Die Bestellvolumina über das Portal verdoppelten sich im ersten Jahr.
Stefan NeumannHead of E-Commerce, REHAU
Fallstudie ansehen →
“
Eine Kreditentscheidungs-Engine, die zehnmal schneller genehmigt, entsteht nicht zufällig. YuSMP entwickelte die Scoring-Pipeline, die Integration mit Kreditbüros und ein Back-Office, das unsere Underwriter gerne nutzen. Die Genehmigungszeit sank von zwei Tagen auf unter vier Stunden.
Gregory LawsonCTO, LoanFlow
Fallstudie ansehen →
“
Wir veröffentlichen täglich Dutzende Sportartikel. YuSMP entwickelte eine Redaktionspipeline mit einem Telegram-Bot als CMS — Redakteure posten einmal, und der Inhalt erscheint sofort auf Web, iOS und Android. Die Architektur erfordert null tägliche Wartung.
Ryan O'ConnorCEO, Media Arena
Fallstudie ansehen →

1 / 4

Warum Such-Teams YuSMP wählen

Mapping-First-Disziplin

Wir entwerfen explizite Mappings, bevor wir Daten aufnehmen — keine dynamische Feld-Explosion, keine nachträglichen Reindizierungs-Überraschungen.

ILM ab Tag eins

Hot-Warm-Cold-Tiering beim Cluster-Setup verdrahtet — Speicherkosten überraschen Sie nach 12 Monaten Indexwachstum nicht.

Hybride BM25 + Vektorsuche

Wir implementieren kombinierte BM25- und kNN-Pipelines mit RRF — bessere Relevanz als jeder Ansatz allein, auf Ihr Korpus abgestimmt.

FAQ

Elasticsearch FAQ

Elasticsearch oder OpenSearch — was empfehlen Sie?

OpenSearch (AWS-Fork) für Teams auf AWS, die Elastics proprietäre Lizenzierung vermeiden und eng mit dem Amazon OpenSearch Service integrieren möchten. Elasticsearch für Teams, die Elastic Cloud oder den ELK-Stack nutzen, wo Kibana- und APM-Integration eine Rolle spielt. Beide sind API-kompatibel für die meisten Anwendungsfälle — wir gestalten den Applikationscode so, dass er zwischen beiden portierbar ist.

Wie entwerfen Sie Elasticsearch-Mappings für einen Produktkatalog?

Wir trennen Keyword-Felder (Exact-Match-Filter, Aggregationen) von Text-Feldern (Volltext-Suche mit Analyse), verwenden Nested Objects für Variantenattribute, setzen sprachgerechte Analyzer und definieren Index-Aliases für Zero-Downtime-Reindex-Operationen. Das Mapping-Design ist die wirkungsvollste einzelne Entscheidung für die Suchqualität.

Wie implementieren Sie facettierte Suche?

Terms-Aggregationen für diskrete Facetten (Marke, Kategorie), Range-Aggregationen für numerische Facetten (Preis, Bewertung) und Nested-Aggregationen für variantengerechte Facetten. Wir verwenden Post-Filter nach der Aggregation, damit Facetten-Zähler den gesamten Ergebnissatz widerspiegeln — nicht nur die aktuelle Filterauswahl.

Wie handhaben Sie Elasticsearch im großen Maßstab kosteneffizient?

ILM (Index Lifecycle Management) zum Tiering von Indizes: hot (SSD), warm (HDD), cold (frozen) und delete — basierend auf Abfragefrequenz und Aufbewahrungsanforderungen. Shard-Anzahl auf ~20–50 GB pro Shard abgestimmt. Rollup-Indizes für langfristige Aggregationen. Force-Merge auf geschlossenen Indizes. Wir auditieren Shard-Zahlen und Indexgrößen bei jedem Engagement.

Vektorsuche in Elasticsearch — wann ist sie nützlich?

kNN-Vektorsuche in Elasticsearch 8+ oder OpenSearch ist produktionsreif für semantische Suche, Empfehlungen und RAG-Retrieval-Augmentation. Wir setzen sie zusammen mit BM25-Lexikalsuche in einer hybriden RRF-Pipeline (Reciprocal Rank Fusion) ein für bessere Relevanz als beide Ansätze allein.

Wie synchronisieren Sie Elasticsearch mit einer PostgreSQL-Quelldatenbank?

CDC via Debezium Kafka Connect Pipeline für nahezu-Echtzeit-Sync. Elasticsearch Logstash JDBC-Input für Batch-Sync, wo Kafka zu viel Overhead erzeugt. Applikationsseitiges Dual-Write für einfache Fälle, bei denen das Divergenzrisiko akzeptabel ist. Wir vermeiden Dual-Write in regulierten Systemen und bevorzugen die CDC-Pipeline.

Schnelle, skalierbare Suche mit erfahrenen Elasticsearch-Entwicklern aufbauen

Sagen Sie uns, wo Sie in zwölf Monaten stehen möchten. Wir liefern Ihnen einen Plan, um dorthin zu gelangen.

Angebot anfordern

Antwort innerhalb eines Werktages. NDA auf Anfrage.

Angebot anfordern

Teilen Sie uns einige Details mit, und ein Senior-Consultant antwortet innerhalb eines Werktages.

Kostenlose Projektschätzung – Sie erhalten innerhalb von 1–2 Werktagen einen Plan.
  • Analyse der Anforderungen und Empfehlungen zum Tech-Stack
  • Schätzung von Zeitrahmen, Budget und Teamzusammensetzung
  • Unverbindlich – einfach ein klarer Plan

E-Mail: sales@yusmpgroup.com

Telefon: +374 44 871 811

Büros: KAMAR Business Center, Vazgen Sargsyan Str. 2, Yerevan, Armenien · Remote — Überlappung mit der US-Ostküste (9–13 Uhr ET)

– Pflichtfelder